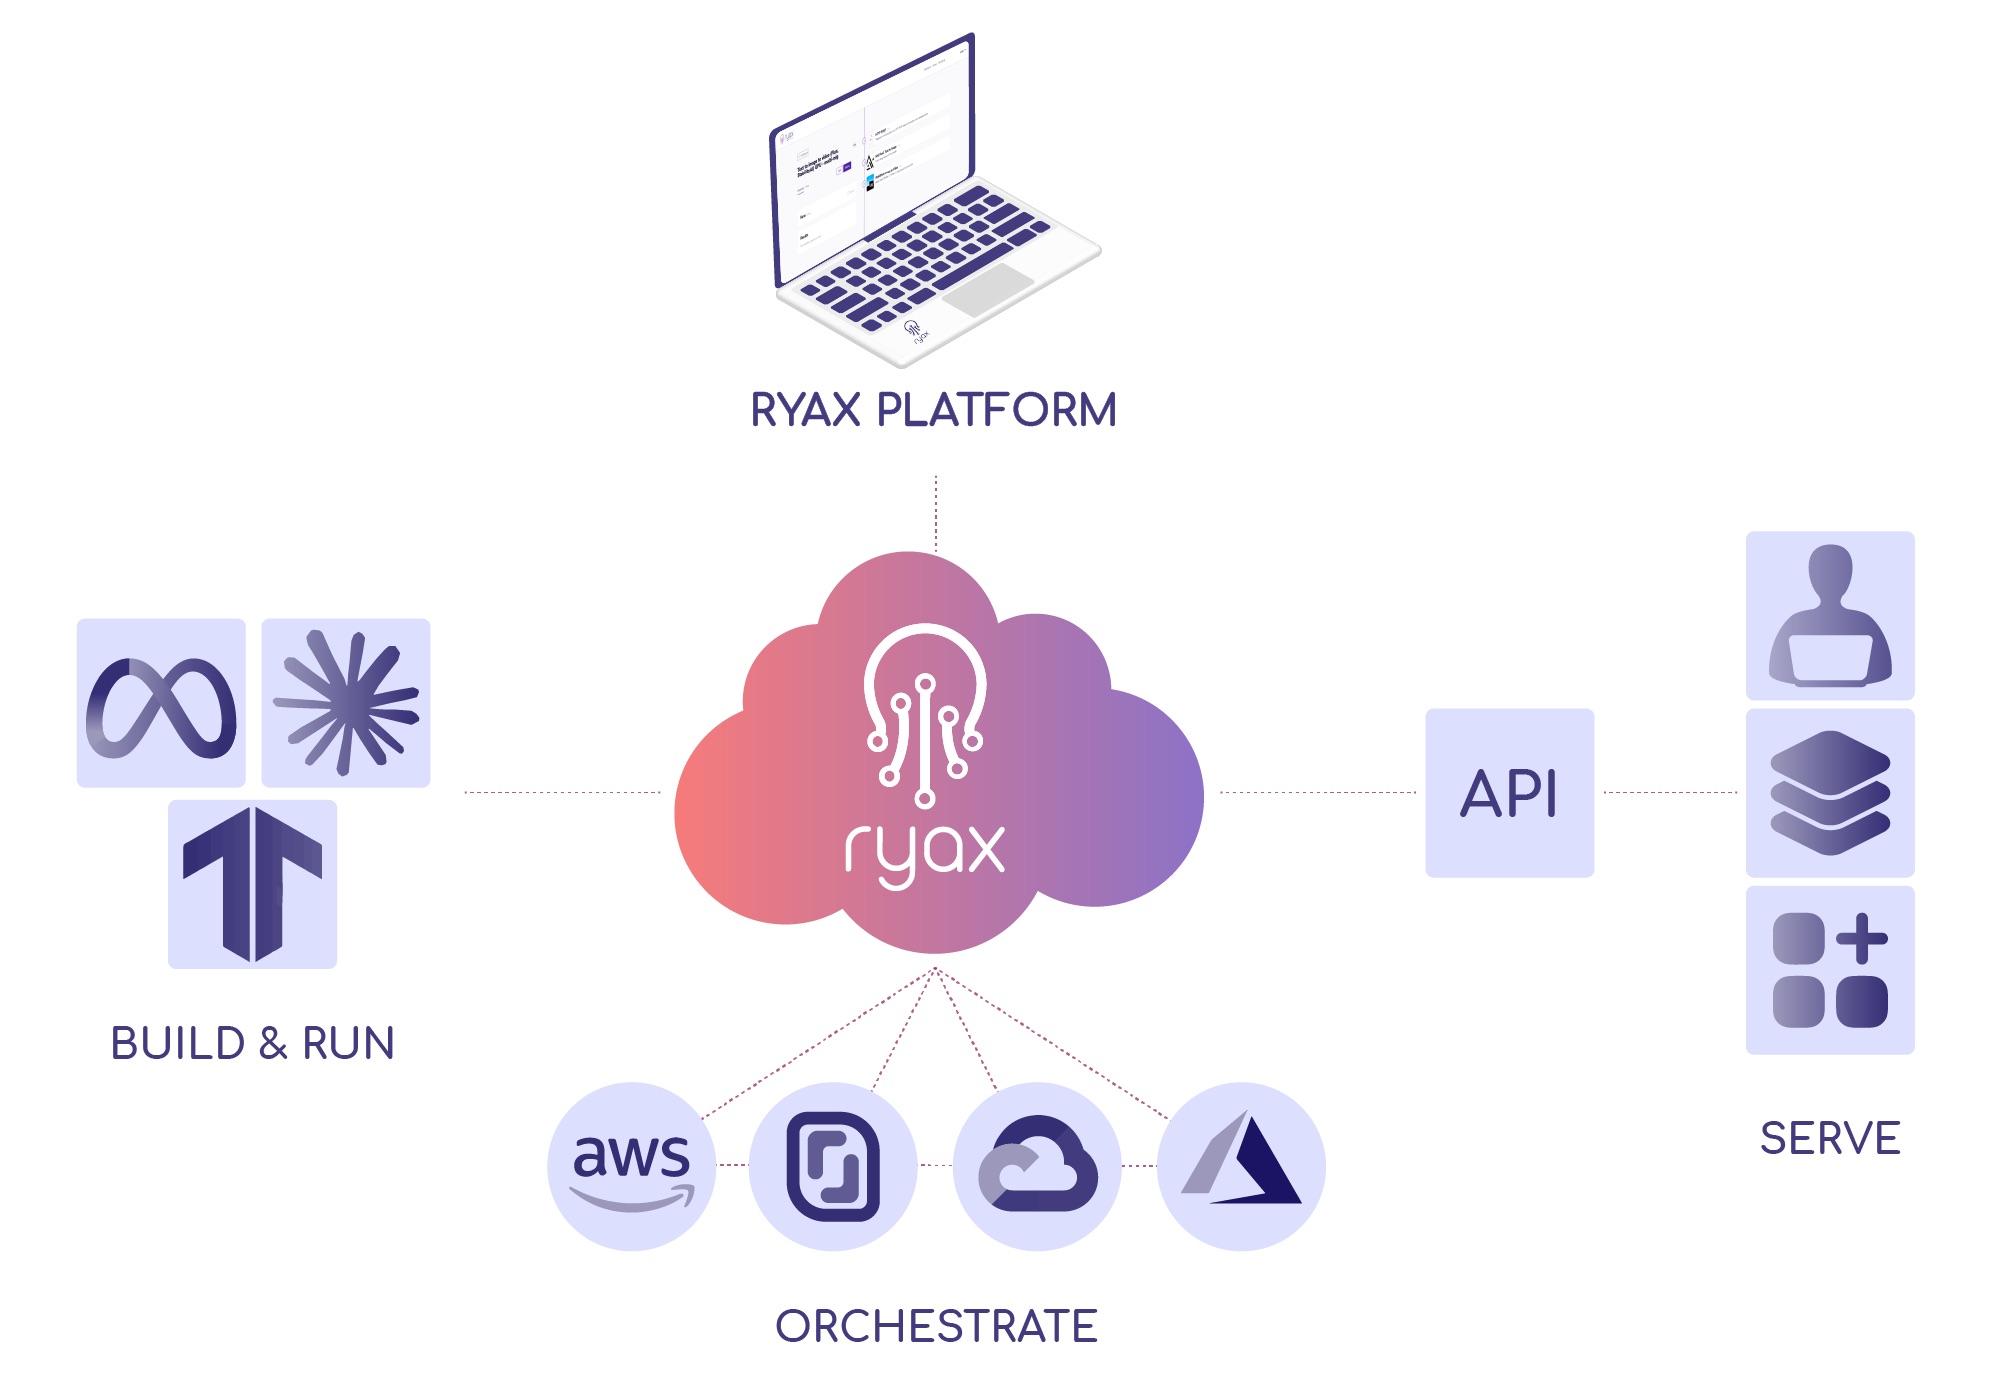
Nutanix ha acquisito Ryax Technologies, società francese specializzata nell’orchestrazione di workload ad alta intensità di calcolo. La sua tecnologia è destinata a confluire nelle prossime versioni di Nutanix Kubernetes Platform (NKP) e Nutanix Enterprise AI (NAI), aggiungendo funzioni per dimensionare dinamicamente le risorse e scegliere dove eseguire attività di training, inferenza e batch distribuite tra data center privati, cloud pubblici, neocloud e cluster HPC.
Dall’allocazione statica a risorse dimensionate per ogni esecuzione
La capacità di calcolo destinata all’intelligenza artificiale viene spesso prenotata in modo prudenziale. Un team può assegnare a un container più CPU, memoria o VRAM di quanto il workload utilizzi realmente, così da ridurre il rischio di errori durante l’esecuzione. La differenza rimane però indisponibile per altri processi e, su cluster dotati di acceleratori costosi, si traduce in capacità inutilizzata.
Ryax affronta il problema attraverso la telemetria raccolta durante le esecuzioni e lo storico di ciascuna fase del workflow. Il sistema osserva il consumo effettivo di CPU, memoria e GPU, quindi propone per l’esecuzione successiva una configurazione più vicina al fabbisogno rilevato. Se il processo termina per memoria insufficiente, può aumentare temporaneamente il limite, ripetere l’operazione e utilizzare l’errore come ulteriore dato per il dimensionamento.
Questa logica opera a livello delle singole azioni che compongono un workflow, ciascuna eseguita in un container separato. Una pipeline documentale, per esempio, può affidare il pre-processing alla CPU, assegnare una GPU alla generazione degli embedding e utilizzare nuovamente risorse meno costose per le fasi successive. La capacità accelerata viene così riservata soltanto durante il segmento che ne ha effettivamente bisogno.
Il componente Ryax IntelliScale applica modelli differenti alle diverse risorse. Per CPU e memoria cerca di avvicinare richieste e limiti all’utilizzo misurato; per le GPU valuta il rapporto tra tempo di esecuzione e costo, costruendo un profilo del comportamento del workload. Lo sviluppatore può esprimere la priorità fra prestazioni ed economia, mentre il sistema aggiorna progressivamente la configurazione sulla base delle esecuzioni reali.
Le GPU frazionate aumentano la densità dei cluster
Una parte della tecnologia riguarda il GPU bin-packing, cioè la collocazione di più carichi sullo stesso acceleratore senza assegnare a ciascuno un’intera GPU. Con NVIDIA Multi-Instance GPU (MIG), una GPU compatibile può essere suddivisa in istanze isolate dotate di una quota prestabilita di memoria e capacità di calcolo. Ryax seleziona la frazione ritenuta adeguata per l’azione e lascia il resto dell’acceleratore disponibile ad altri container.
Nel blog tecnico sull’acquisizione, Nutanix riferisce che il dimensionamento per singola esecuzione ha ridotto del 62% le ore-nodo in una sequenza di 30 attività di deep learning, completata anche il 5,7% più rapidamente. In una pipeline di document intelligence, l’assegnazione serverless ha ridotto da ore a minuti il tempo durante il quale la GPU restava impegnata per ogni esecuzione; quattro processi concorrenti su una NVIDIA H100 suddivisa tramite MIG hanno abbassato del 52% il costo per esecuzione.
Ryax ha testato IntelliScale in un simulatore che riproduceva i carichi di lavoro a partire da registrazioni storiche dell’esecuzione dei job e del relativo utilizzo delle risorse su Google Cloud. Il sistema ha ridotto il numero di nodi del 33% per i carichi legati soprattutto a CPU e memoria e del 31,2% per quelli a maggiore intensità GPU.
Lo scheduler sceglie tra Kubernetes, cloud e cluster HPC
Il secondo tassello è un meta-scheduler collocato sopra i singoli ambienti di calcolo. Per ogni job confronterà prestazioni attese, prezzo e consumo energetico, quindi selezionerà il pool di nodi più adatto tra cluster Kubernetes, risorse cloud, infrastrutture con GPU NVIDIA o AMD e sistemi HPC amministrati tramite Slurm.
La collocazione tiene conto anche della posizione dei dati. Spostare un workload verso una GPU disponibile può apparire conveniente, ma la distanza dal dataset aumenta latenza, tempi di trasferimento e costi di egress. Lo scheduler deve quindi considerare insieme disponibilità della capacità, requisiti del processo e cosiddetta data gravity, evitando che il risparmio sul calcolo venga assorbito dal movimento dei dati.
Ryax prevede inoltre un criterio energetico basato sui modelli di consumo dell’hardware. Il sistema stima l’impronta delle alternative disponibili e può assegnare il job al cluster con il fabbisogno previsto più basso.
Per Nutanix, questa capacità estenderebbe la gestione multi-cluster di NKP e il livello dedicato ai modelli e all’inferenza di Nutanix Enterprise AI. NKP amministra il ciclo di vita di ambienti Kubernetes distribuiti tra infrastruttura locale, cloud pubblico, bare metal ed edge; NAI offre strumenti per distribuire e governare modelli e servizi AI. Ryax agirebbe più in basso nello stack, decidendo come dimensionare e dove collocare il calcolo necessario a eseguirli.
L’acquisizione completa il disegno infrastrutturale di Nutanix
L’operazione segue di poche settimane la partnership fra Nutanix e ChronoScale, che prevede capacità GPU-as-a-Service, inferenza prepagata e una piattaforma AI installabile nei data center dei clienti. I due accordi intervengono su problemi complementari: ChronoScale amplia le fonti dalle quali ottenere capacità accelerata, mentre Ryax fornisce la logica per assegnarla ai workload e ridurne i periodi di inattività.
L’acquisizione amplia così il ruolo di Nutanix oltre l’amministrazione dell’infrastruttura ibrida. La società sta costruendo un livello operativo nel quale Kubernetes, servizi di inferenza, cluster HPC e capacità GPU esterna possano essere governati dallo stesso piano di controllo, con decisioni automatiche su collocazione e consumo delle risorse.
Rajiv Ramaswami, CEO di Nutanix, afferma che “l’AI agentica richiede un’architettura flessibile, operazioni semplici e la capacità di utilizzare l’infrastruttura in modo molto più efficiente”. Andry Razafinjatovo, CEO di Ryax Technologies, spiega che la piattaforma è stata sviluppata per eseguire workload attraverso “infrastrutture ibride come data center privati, hyperscaler e neocloud, gestendo la complessità del backend affinché i team possano distribuire, scalare e amministrare i workflow AI fin dal primo giorno”.
Il dimensionamento automatico e lo scheduling tra ambienti eterogenei intervengono così su due costi concreti dell’AI enterprise: acceleratori sottoutilizzati e capacità distribuita in silos.