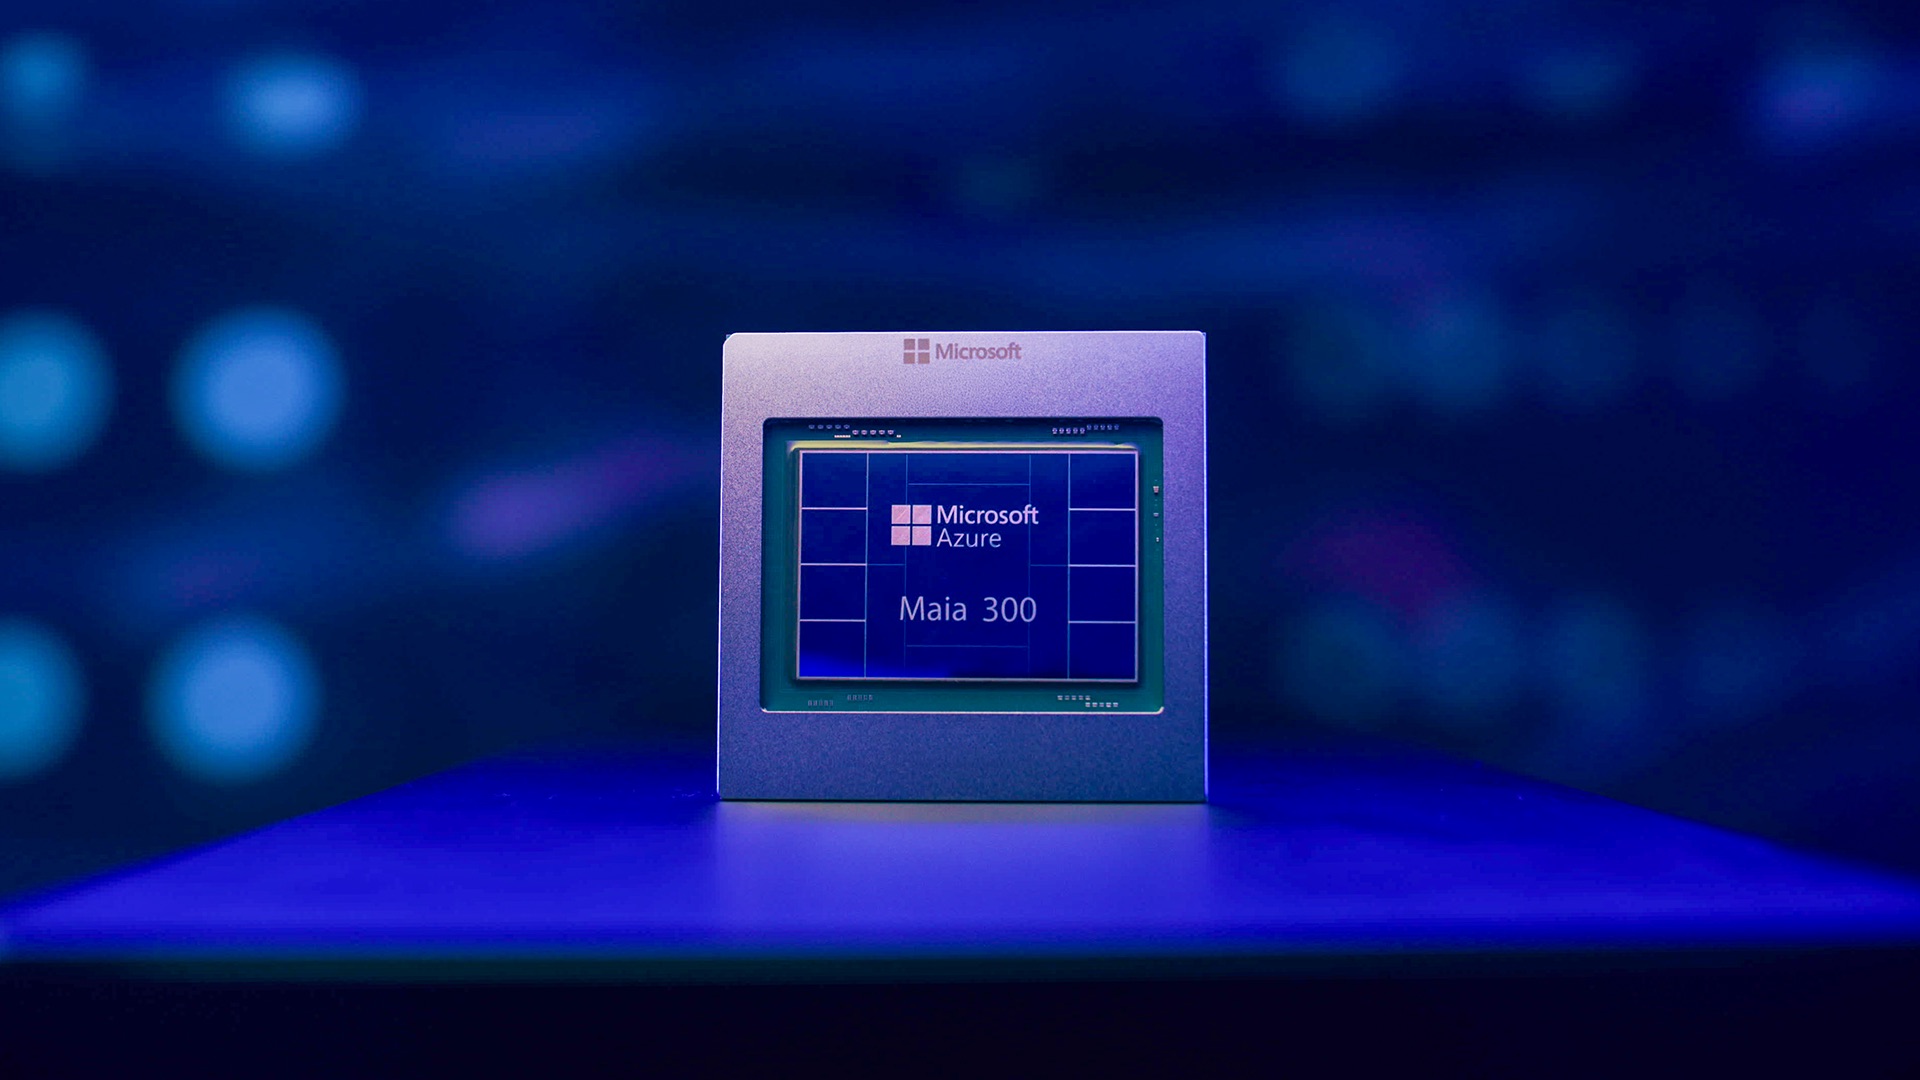
Microsoft ha presentato Azure Maia 300, la terza generazione dei propri acceleratori dedicati all’intelligenza artificiale, con un’architettura progettata per sostenere i carichi di inferenza dei modelli linguistici e delle applicazioni agentiche su larga scala. Il nuovo sistema, il cui impiego nei data center è previsto a partire dal 2027, promette un throughput di generazione dei token fino a sette volte superiore rispetto a Maia 200 a livello di rack e un miglioramento dell’efficienza energetica superiore a 2,5 volte.
Microsoft ha progettato Maia 300 intervenendo congiuntamente su processori, memoria, interconnessioni, software e infrastrutture fisiche, con l’obiettivo di aumentare il numero di token generabili a parità di potenza elettrica e di investimento infrastrutturale. L’architettura di Maia 300 risponde soprattutto alle esigenze dei sistemi agentici, nei quali l’elaborazione comprende sequenze di operazioni, accessi agli strumenti, ragionamenti articolati e contesti di grandi dimensioni.
Dai modelli linguistici agli agenti AI cambiano i requisiti dell’hardware
L’evoluzione delle applicazioni AI sta modificando le caratteristiche dei carichi di lavoro che le infrastrutture cloud devono sostenere. Ai tradizionali processi di generazione del testo si aggiungono applicazioni nelle quali i modelli eseguono numerosi passaggi consecutivi, interrogano fonti esterne, utilizzano strumenti software e mantengono informazioni contestuali durante interazioni prolungate.
Questi carichi richiedono capacità di calcolo elevate, ma attribuiscono un’importanza crescente alla disponibilità della memoria, alla sua larghezza di banda e alla rapidità con cui le informazioni possono essere trasferite tra i diversi componenti del sistema.
Particolarmente impegnativa è la gestione della KV cache, la memoria utilizzata dai modelli Transformer per conservare le informazioni necessarie durante la generazione dei token. All’aumentare della lunghezza del contesto e del numero di sessioni simultanee, la capacità e la banda della memoria possono diventare fattori limitanti delle prestazioni.
L’architettura di Maia 300 affronta questi problemi attraverso una gerarchia di memoria esplicitamente gestita dal software, formati numerici a precisione ridotta e una rete di interconnessione concepita per collegare migliaia di acceleratori.
La piattaforma è destinata a sostenere l’infrastruttura AI di Microsoft, che comprende servizi come Microsoft Copilot, GitHub Copilot e Microsoft Foundry.
Un’architettura chiplet con processo produttivo TSMC a 2 nanometri
Una delle principali novità di Maia 300 riguarda l’adozione di un’architettura multi-chiplet, che suddivide le funzioni del processore tra diversi componenti di silicio.
Le unità dedicate al calcolo utilizzano il processo produttivo TSMC N2P, appartenente alla generazione tecnologica a 2 nanometri, mentre le funzioni di controllo della memoria e di input/output sono affidate a chiplet realizzati con tecnologie più adatte alle rispettive esigenze di connettività, banda e costo.
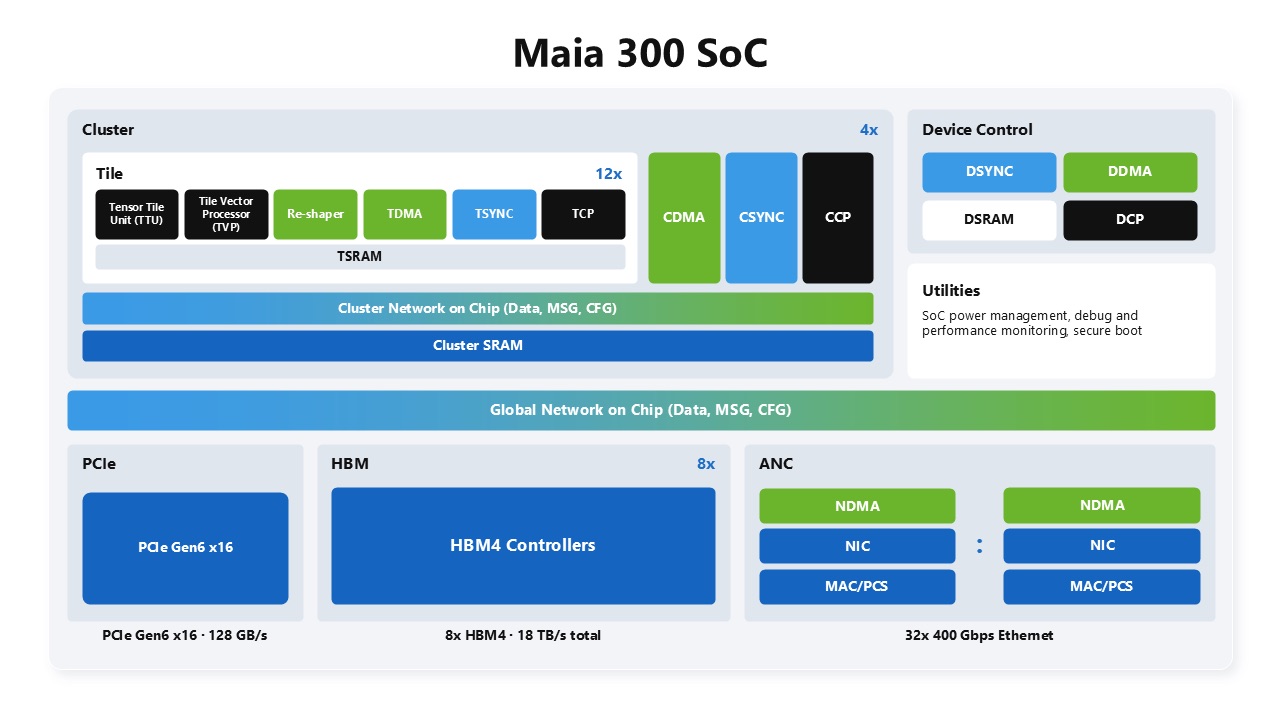
Questa separazione consente di riservare una quota maggiore del silicio più avanzato alle operazioni computazionali, evitando di impiegarlo per circuiti che non ricaverebbero gli stessi benefici dal processo produttivo.
Rispetto a Maia 200, Microsoft dichiara un incremento del 36% della capacità di calcolo espressa in FLOPS, una larghezza di banda della memoria 2,5 volte superiore e un aumento del 14% della banda delle interconnessioni scale-up.
Il nuovo processore rappresenta inoltre un’evoluzione della Software Defined Locally Accessed Dataflow Architecture (SDLA), introdotta con Maia 200.
Questa architettura separa il controllo delle operazioni dall’esecuzione dei flussi di dati e consente al software di coordinare esplicitamente il posizionamento delle informazioni, i trasferimenti tra le memorie e la sincronizzazione dei motori di calcolo.
Con Maia 300, Microsoft passa da un’organizzazione della memoria ad accesso uniforme (UMA) a una struttura NUMA, Non-Uniform Memory Access, distribuita tra i chiplet. Le diverse regioni computazionali dispongono così di risorse di memoria locali, con l’obiettivo di ridurre la distanza percorsa dai dati e, di conseguenza, il consumo energetico dei trasferimenti.
HBM4 da 288 GB e 18 TB/s per acceleratore
Il sottosistema di memoria costituisce uno degli elementi più significativi della nuova architettura.
Ogni acceleratore Maia 300 integra otto stack HBM4, per una capacità complessiva di 288 GB e una larghezza di banda di 18 TB/s.
Rispetto alla generazione precedente, la capacità aumenta del 33%, mentre la larghezza di banda cresce di 2,5 volte. Microsoft dichiara inoltre un raddoppio approssimativo della banda HBM disponibile per watt consumato.
L’aumento della memoria permette di mantenere più parametri dei modelli e una maggiore quantità di dati contestuali vicino alle unità di elaborazione, riducendo la necessità di trasferimenti verso risorse esterne.
Accanto alla HBM4, Maia 300 utilizza memoria SRAM integrata nel chip, gestita attraverso i meccanismi software dell’architettura SDLA.
Sul fronte della rappresentazione dei dati, Microsoft introduce versioni ottimizzate del formato MXFP4, a precisione di 4 bit, e formati di memorizzazione inferiori a 3 bit. Queste tecniche permettono di ridurre lo spazio necessario per rappresentare i dati e la quantità di informazioni trasferite durante l’inferenza.
L’architettura comprende anche miglioramenti al set di istruzioni dei motori vettoriali, con ottimizzazioni per operazioni frequenti nei modelli linguistici, tra cui softmax e conversioni tra formati numerici a precisione ridotta.
Una rete unificata per collegare oltre 12.000 acceleratori
Microsoft ha riprogettato anche l’infrastruttura di interconnessione, considerando il networking come un’estensione dell’architettura di elaborazione.
Maia 300 utilizza controller di rete integrati e un protocollo di trasporto specializzato basato su Ethernet, organizzato secondo una topologia a due livelli.
Il primo collega gli acceleratori all’interno dello stesso rack, mentre il secondo permette di connettere rack differenti in un unico dominio scale-up.
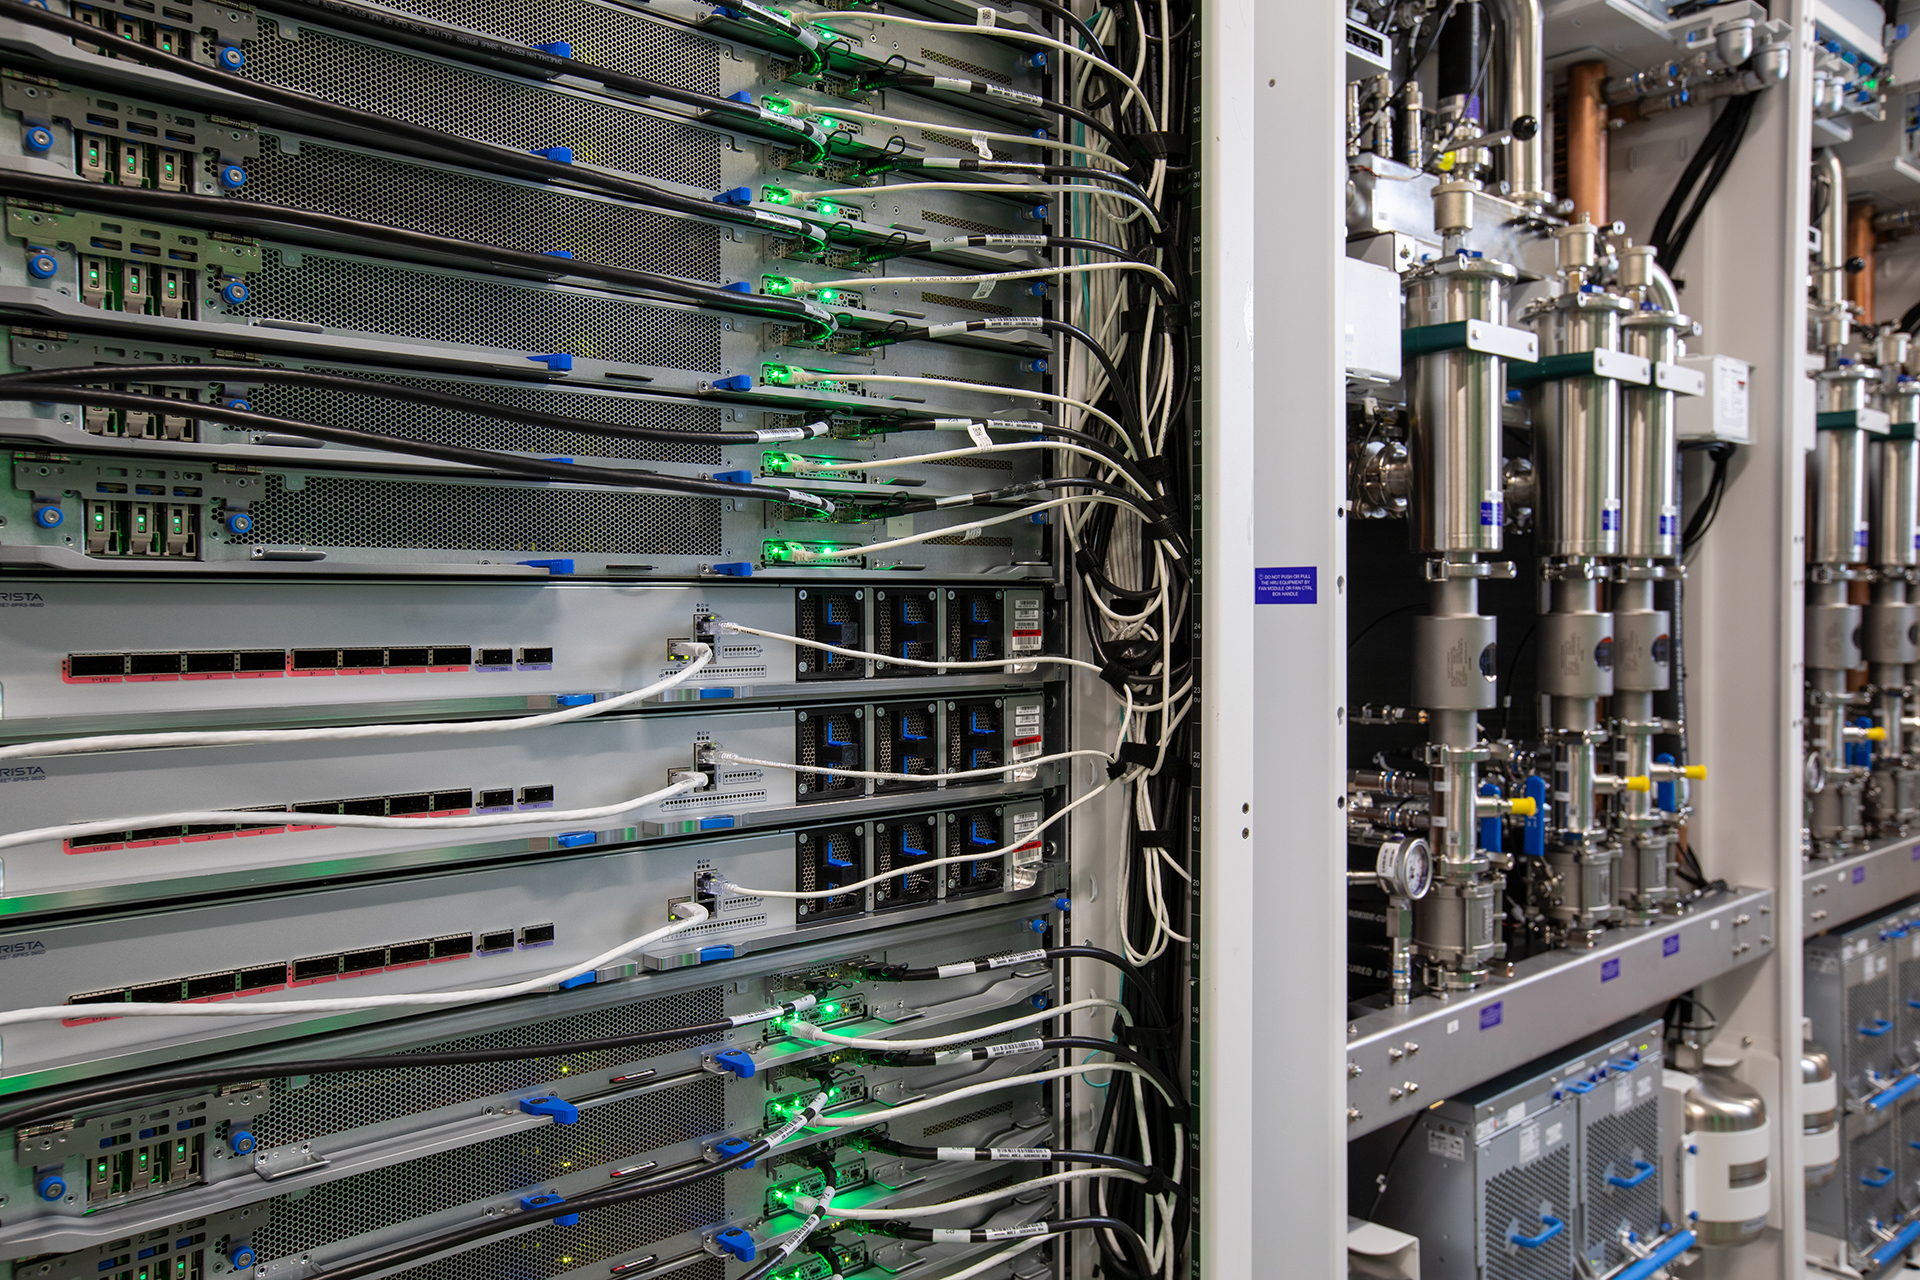
Ogni rack contiene 96 acceleratori e costituisce un pod. Collegando fino a 128 rack, l’infrastruttura può formare un superpod composto da 12.288 acceleratori.
All’interno del rack, alcune connessioni sono dirette e altre attraversano switch, mentre i collegamenti tra rack utilizzano connessioni ottiche.
La piattaforma presenta al software un modello di comunicazione uniforme, che consente a un acceleratore di trasferire dati direttamente a qualsiasi altro dispositivo del superpod, senza coinvolgere necessariamente il processore host o una scheda di rete separata per le comunicazioni scale-out.
La topologia prevede tre livelli di latenza: collegamento diretto tra una coppia di acceleratori, comunicazione attraverso uno switch all’interno del pod e comunicazione attraverso tre switch tra pod differenti.
In determinate configurazioni, un acceleratore può raggiungere 750 GB/s di banda verso un altro acceleratore del superpod, a seconda della distribuzione dei carichi e delle risorse di rete disponibili.
Questa organizzazione permette di distribuire i modelli e i processi di inferenza su gruppi di acceleratori di dimensioni differenti, adattando l’allocazione delle risorse ai requisiti applicativi.
Un aspetto particolarmente interessante riguarda la possibilità di separare le fasi di prefill, durante le quali viene elaborato il contesto iniziale, e decode, dedicate alla generazione progressiva dei token.
Le due operazioni possono essere assegnate a risorse differenti, trasferendo direttamente lo stato della KV cache attraverso la rete scale-up. La stessa infrastruttura permette di utilizzare acceleratori di riserva collocati in altri rack quando si verificano guasti, migliorando la disponibilità e l’utilizzo complessivo della capacità installata.
Rack da 167 kW, raffreddamento a liquido e maggiore densità
L’architettura Maia 300 comprende anche una nuova progettazione fisica dei sistemi destinati ai data center.
Ogni rack integra 96 acceleratori distribuiti in 24 tray da quattro acceleratori, con una potenza complessiva di 167 kW. La densità degli acceleratori risulta quindi doppia rispetto a Maia 200.
Ciascun tray comprende i quattro acceleratori, il processore host, la memoria, lo storage e i componenti di raffreddamento. L’integrazione elimina la necessità di tray separati per i processori host, liberando spazio all’interno del rack.
Il sistema di interconnessione utilizza sei ASIC di switching ad alta capacità, distribuiti in tre tray raffreddati a liquido.
Anche l’alimentazione è progettata a livello di rack, con doppia linea elettrica, distribuzione attraverso busbar a 50 V e sistemi automatici di commutazione per mantenere l’operatività durante gli interventi su una delle due linee.
Il raffreddamento a liquido rimuove oltre l’80% del carico termico complessivo del rack, intervenendo su acceleratori, regolatori di tensione e chip di switching. I componenti ausiliari, tra cui memoria e storage, utilizzano invece il raffreddamento ad aria.
Microsoft prevede due modalità di integrazione nei data center: collegamento diretto agli impianti idraulici della struttura, quando disponibili, oppure utilizzo di uno scambiatore di calore per installazioni in ambienti dotati di sistemi di raffreddamento ad aria.
La piattaforma dispone inoltre di telemetria a livello di rack e di fila, utilizzata per ottimizzare dinamicamente l’assegnazione della potenza e il posizionamento dei carichi di lavoro in funzione della capacità elettrica e termica disponibile.
Fino a sette volte più token per rack rispetto a Maia 200
I miglioramenti introdotti nelle diverse componenti concorrono ai risultati prestazionali dichiarati da Microsoft.
Nella configurazione completa da 96 acceleratori, Maia 300 offre un throughput di generazione dei token fino a sette volte superiore rispetto a Maia 200, accompagnato da un incremento della performance per watt superiore a 2,5 volte.
Il confronto riguarda il sistema completo e comprende quindi anche il raddoppio del numero di acceleratori presenti nel rack, oltre alle modifiche apportate ai singoli processori, alla memoria e alle interconnessioni.
Sul piano competitivo, Microsoft dichiara inoltre un’efficienza superiore del 40% in termini di token per megawatt rispetto ai principali sistemi basati su GPU.
La strategia di Microsoft per ridurre il costo dell’inferenza AI
Maia 300 si inserisce in una strategia che accomuna i principali hyperscaler: sviluppare acceleratori proprietari per ottimizzare i carichi AI eseguiti nei rispettivi data center, affiancando alle GPU commerciali infrastrutture progettate sulle esigenze delle proprie piattaforme.
Google segue questa direzione con le TPU, mentre Amazon Web Services sviluppa la famiglia Trainium. Microsoft, con Maia, sta costruendo progressivamente una propria infrastruttura di calcolo AI, riducendo la dipendenza esclusiva dai fornitori esterni di acceleratori.
La scelta assume particolare importanza con la crescita dell’inferenza rispetto all’addestramento. Mentre la fase di training comporta investimenti computazionali concentrati nel tempo, l’utilizzo quotidiano dei modelli genera costi operativi continuativi, destinati ad aumentare con il numero degli utenti, delle richieste e delle operazioni eseguite dagli agenti.
Per un operatore come Microsoft, che utilizza l’AI sia nei propri prodotti sia nei servizi cloud offerti ai clienti, anche miglioramenti relativamente contenuti nell’efficienza per token possono produrre effetti economici significativi quando vengono applicati su infrastrutture di grandi dimensioni.