La corsa ai modelli di intelligenza artificiale sempre più grandi sta cambiando natura. Il numero complessivo dei parametri continua a crescere, ma una parte sempre più rilevante della ricerca si concentra sulla possibilità di utilizzarne soltanto una piccola frazione durante l’elaborazione, contenendo il fabbisogno computazionale senza sacrificare la capacità della rete. È la logica delle architetture Mixture of Experts (MoE), adottate negli ultimi mesi da numerosi sviluppatori di modelli di frontiera e ora al centro anche del nuovo progetto di Microsoft AI.
Con MAI-Base-2, Microsoft ha completato l’addestramento iniziale di un modello multimodale da 2.800 miliardi di parametri complessivi, dei quali 80 miliardi attivi per ogni token elaborato. Annunciato il 15 ottobre 2026, il sistema rappresenta la seconda generazione dei modelli fondamentali sviluppati direttamente dalla divisione Microsoft AI, impegnata nella costruzione di una propria tecnologia di base destinata ai prodotti del gruppo e ai clienti di Microsoft Foundry.
Il risultato più importante rivendicato dalla società riguarda l’efficienza dell’addestramento: secondo le valutazioni interne, MAI-Base-2 richiede da 4,2 a 12,3 volte meno operazioni computazionali rispetto a DeepSeek-V4-Pro-Base per raggiungere un livello equivalente di qualità predittiva. Microsoft ha sfruttato questi miglioramenti per addestrare una rete di dimensioni molto maggiori, ottenendo risultati che, nelle prove pubblicate, superano quelli degli altri modelli open-weight esaminati.
Il confronto con DeepSeek e gli altri modelli di frontiera
MAI-Base-2 nasce dall’esperienza di MAI-Base-1, il modello sul quale Microsoft aveva successivamente costruito MAI-Thinking-1, annunciato a giugno 2026 e specializzato nel ragionamento attraverso una fase aggiuntiva di addestramento, denominata post-training.
Per valutare la nuova generazione, Microsoft ha confrontato MAI-Base-2 con alcuni dei maggiori modelli open-weight disponibili prima di ottobre 2026: DeepSeek-V4-Pro-Base, Kimi K3, Qwen3.8-2.4T-A95B e MiMo-V2.6-Pro-RL.
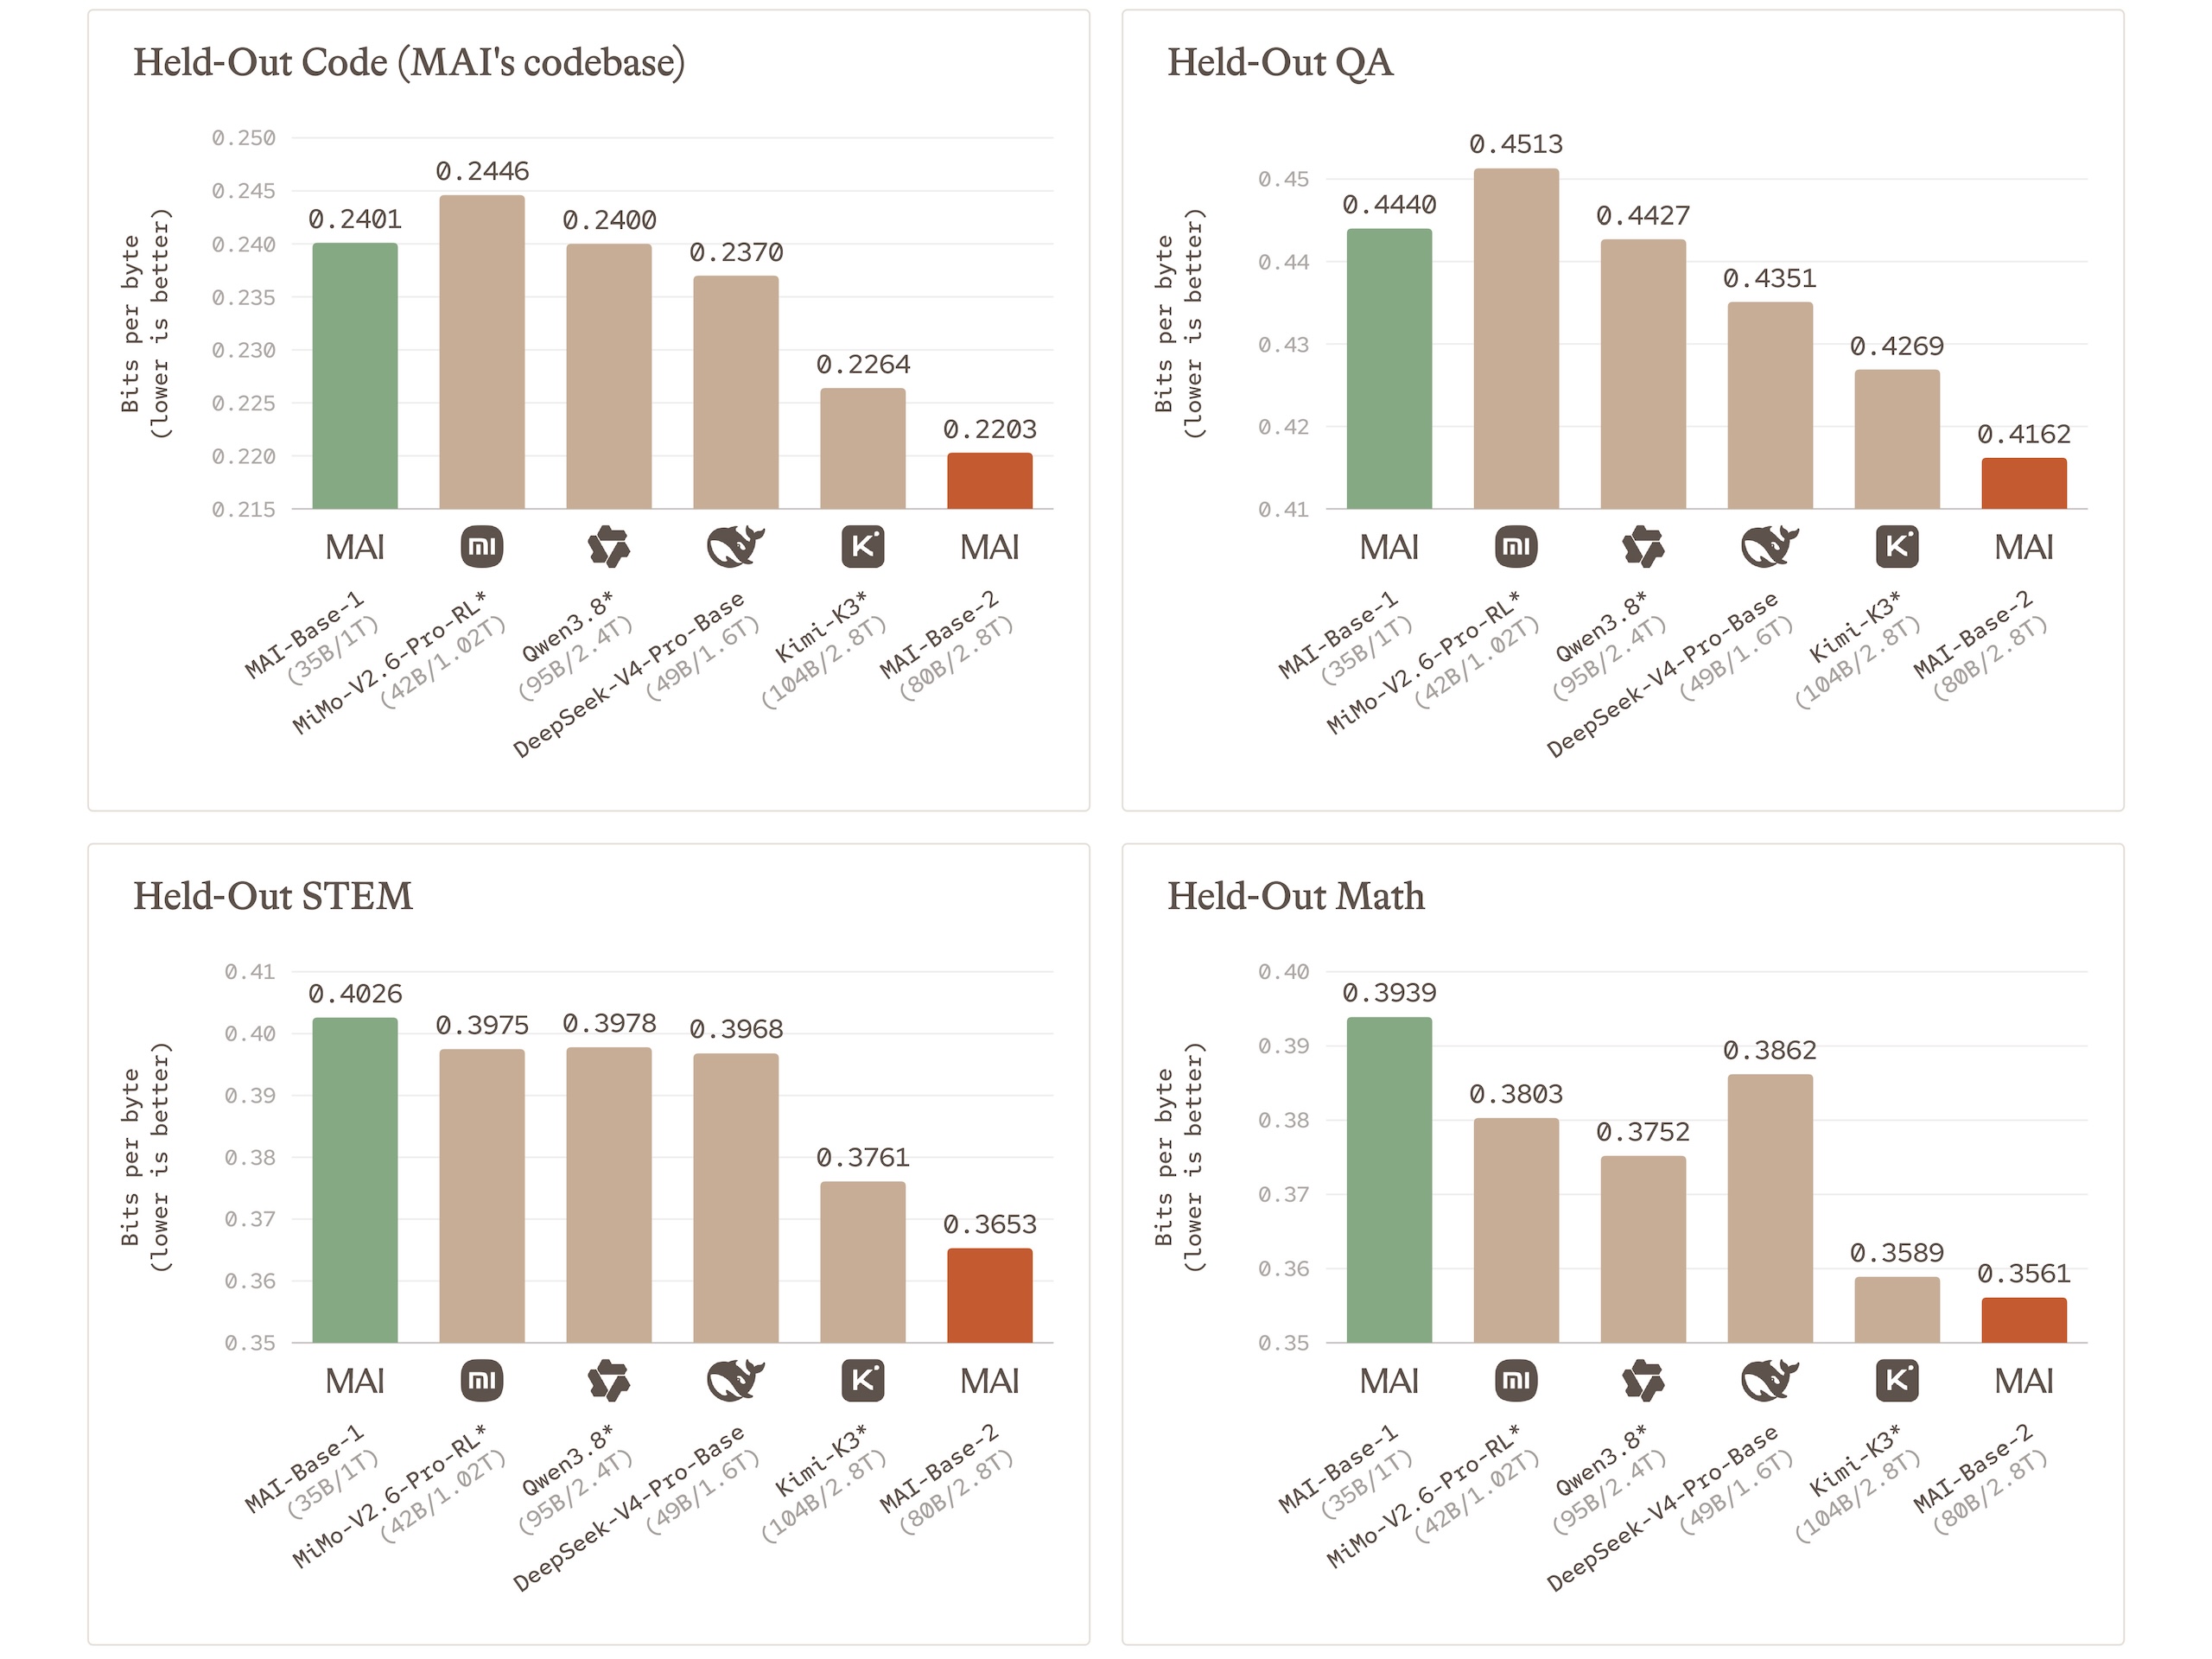
MiMo-V2.6-Pro-RL, Qwen3.8-2.4T-A95B e Kimi K3 sono modelli già sottoposti a post-training.
Le prove misurano la capacità di prevedere correttamente il contenuto di testi appartenenti a differenti domini, dalla programmazione alla matematica, dalle discipline scientifiche alla conoscenza generale. La metrica adottata è il bits per byte (BPB), che esprime l’incertezza del modello nella previsione del testo e permette di confrontare sistemi dotati di tokenizer differenti: valori più bassi corrispondono a una migliore capacità predittiva.
MAI-Base-2 ottiene il valore migliore in tutte le valutazioni presentate da Microsoft. Il confronto comprende tuttavia modelli in fasi differenti del loro sviluppo: DeepSeek-V4-Pro-Base è un modello base, mentre per Kimi K3, Qwen3.8 e MiMo-V2.6 sono disponibili soltanto versioni già sottoposte a post-training, che può modificare le prestazioni nelle prove di predizione del testo.
Per Microsoft, l’efficienza dell’addestramento costituisce un risultato altrettanto importante delle prestazioni assolute. La società ha confrontato la quantità di calcolo utilizzata da DeepSeek con quella che la propria metodologia avrebbe richiesto per raggiungere lo stesso livello di qualità, ricavando un vantaggio compreso tra 4,2 e 12,3 volte nelle differenti categorie di valutazione. Rispetto al precedente MAI-Base-1, il miglioramento stimato è ancora maggiore, tra 6,3 e 12,7 volte.
Questi rapporti derivano da modelli matematici costruiti sui risultati di esperimenti condotti a scale differenti e descrivono l’efficienza della procedura di addestramento, mentre le prestazioni finali di MAI-Base-2 nelle applicazioni operative potranno essere valutate quando sarà completato il post-training.
Da Meta a NVIDIA e Mistral, i modelli MoE conquistano l’AI di frontiera
La configurazione scelta da Microsoft conferma la crescente diffusione delle architetture Mixture of Experts, che consentono di aumentare il numero complessivo dei parametri mantenendo relativamente contenuta la quantità di calcolo necessaria per generare ciascun token.
In un modello tradizionale dense, tutti i parametri dei livelli interessati vengono normalmente coinvolti nell’elaborazione. Un’architettura MoE distribuisce invece una parte dei parametri fra numerose reti specializzate, chiamate experts, e utilizza un sistema di instradamento per selezionare quelle più appropriate al contenuto da elaborare.
In MAI-Base-2, gli 80 miliardi di parametri attivi corrispondono a circa il 2,9% dei 2.800 miliardi complessivi. Il modello conserva quindi una capacità molto elevata, pur utilizzandone una frazione durante ogni passaggio di inferenza, con vantaggi potenziali in termini di efficienza rispetto a una rete densa di dimensioni equivalenti. La memoria necessaria per conservare i pesi, le comunicazioni tra acceleratori e il bilanciamento del lavoro fra gli esperti rimangono però fattori determinanti per le prestazioni effettive.
La stessa impostazione caratterizza alcuni degli annunci più recenti del settore.
Il Meta Muse Spark Open, presentato il 15 ottobre e descritto da Meta come il più potente modello open-weight statunitense, dispone di 816 miliardi di parametri complessivi e 42 miliardi attivi. Grazie anche alle tecniche di quantizzazione, Meta ha sviluppato configurazioni che permettono di eseguirlo su una workstation con circa 300 GB di memoria, ampliando le possibilità di utilizzo dei grandi modelli al di fuori dei data center.
Pochi giorni prima, la francese Mistral AI aveva annunciato Mistral Large 4, una rete MoE con 1.050 miliardi di parametri, dei quali 49 miliardi attivi, addestrata nei propri data center europei e destinata ad applicazioni che comprendono sviluppo software, cybersecurity, documentazione tecnica e ragionamento multimodale.
Anche NVIDIA ha scelto di sviluppare modelli nei quali la differenza fra parametri complessivi e attivi è particolarmente marcata. Nemotron 3.5 Super VL utilizza 120 miliardi di parametri complessivi e circa 12 miliardi attivi, combinando elaborazione multimodale, programmazione e capacità agentiche. Ancora più compatto sul piano del calcolo è Nemotron 3.5 Lightning, che impiega appena 3 miliardi di parametri attivi su 30 miliardi complessivi ed è progettato per le operazioni ripetitive degli agenti AI, nelle quali latenza e costi di inferenza assumono particolare importanza.
Tra i nuovi protagonisti figura inoltre Reflection AI, che con Beam ha annunciato un modello open-weight da 501 miliardi di parametri complessivi e 23 miliardi attivi, specializzato nella programmazione, nel ragionamento e nei carichi di lavoro agentici.
Le differenze nelle dimensioni e nelle configurazioni riflettono strategie differenti, ma la convergenza sulle architetture MoE evidenzia un cambiamento significativo nella progettazione dei modelli di frontiera. La capacità di un sistema dipende sempre meno dal numero di parametri utilizzati simultaneamente e sempre più dall’organizzazione della rete, dalla qualità dell’addestramento e dall’efficienza con cui vengono selezionate e coordinate le sue componenti specializzate.
Microsoft distribuisce gli esperti in tutti i livelli di MAI-Base-2
L’utilizzo di un’architettura MoE presenta difficoltà tecniche che diventano particolarmente rilevanti durante l’addestramento su migliaia di GPU. La distribuzione dinamica dei token può infatti creare forti squilibri tra gli esperti: alcuni ricevono un numero elevato di richieste, mentre altri rimangono parzialmente inattivi, con conseguenze sull’occupazione della memoria e sul tempo necessario a completare le operazioni.
Microsoft aveva già sperimentato l’impiego degli esperti in ogni livello della rete durante lo sviluppo di MAI-Base-1, riscontrando vantaggi in termini di operazioni computazionali ma anche inefficienze nell’esecuzione. Per il primo modello aveva quindi preferito alternare livelli MoE e livelli dense, ottenendo un compromesso più favorevole tra prestazioni ed efficienza.
Con MAI-Base-2, le ottimizzazioni dell’infrastruttura hanno consentito di adottare livelli MoE lungo tutta la rete, aumentando dal 24% al 35% l’utilizzo effettivo della capacità computazionale in questi livelli.
Uno degli interventi principali riguarda il meccanismo multi-round dropless MoE, sviluppato per gestire gli squilibri di carico senza perdere i token assegnati agli esperti sovraccarichi. Il sistema organizza gli esperti in gruppi e distribuisce l’elaborazione attraverso più cicli successivi, utilizzando anche la capacità disponibile presso gli altri esperti dello stesso gruppo quando uno di essi riceve più token di quanti possa gestirne contemporaneamente.
La tecnica permette di mantenere prevedibile l’occupazione della memoria, evitando di riservare permanentemente grandi quantità di risorse per affrontare picchi occasionali. Il lavoro viene inoltre organizzato in modo da sovrapporre comunicazioni e calcoli, limitando i tempi nei quali gli acceleratori devono attendere lo scambio dei dati.
Altri miglioramenti riguardano l’efficienza delle moltiplicazioni matriciali, le comunicazioni NVLink tra GPU NVIDIA e la gestione dei metadati direttamente sugli acceleratori, riducendo le sincronizzazioni con la CPU.
Questi interventi rendono possibile una configurazione più sparsa rispetto a MAI-Base-1, conservando i vantaggi computazionali degli esperti anche quando il loro numero aumenta considerevolmente.
Sedicimila GPU NVIDIA GB200 per 38 giorni di addestramento
Nonostante la riduzione della quota di parametri attivi, la costruzione di un modello delle dimensioni di MAI-Base-2 richiede risorse computazionali enormi.
Microsoft ha utilizzato 16.000 GPU NVIDIA GB200 per 38 giorni, tra agosto e settembre 2026, raggiungendo un’efficienza media di utilizzo delle operazioni in virgola mobile (Model FLOPs Utilization, MFU) del 21%. Il goodput, ossia la percentuale del tempo durante la quale l’addestramento ha effettivamente progredito, è stato dell’89%, un dato che riflette la continuità operativa dell’infrastruttura durante un’esecuzione particolarmente lunga e complessa.
Una parte importante del lavoro ha riguardato Muon, l’ottimizzatore utilizzato per aggiornare i parametri del modello durante l’apprendimento. Rispetto al più diffuso AdamW, Microsoft ha rilevato una maggiore stabilità e un miglioramento dell’efficienza, ma l’impiego su migliaia di acceleratori ha richiesto modifiche sostanziali nella distribuzione delle operazioni.
Muon utilizza infatti procedure matematiche che lavorano sulle matrici complete dei pesi, mentre l’addestramento distribuito tende a suddividere i dati tra GPU differenti per limitare il consumo di memoria. Microsoft ha risolto il problema organizzando lo scambio delle informazioni necessarie tra gli acceleratori, con operazioni eseguite localmente e comunicazioni sovrapposte al calcolo. Dopo le ottimizzazioni, Muon ha inciso soltanto per il 2,1% sul tempo medio di un’iterazione, corrispondente a 165 millisecondi.
La stabilità dell’addestramento è stata ulteriormente migliorata attraverso l’activation gradient clipping, una tecnica che limita l’effetto dei gradienti anomali intervenendo sulle attivazioni interne della rete. Anziché ridimensionare l’aggiornamento dei pesi per un intero gruppo di esempi quando pochi di essi producono valori eccessivi, il sistema agisce in modo più selettivo, preservando il contributo degli altri dati all’apprendimento.
Lo stesso meccanismo ha aiutato Microsoft a individuare problemi nella preparazione del materiale di addestramento, tra cui un errore che aveva troncato l’intestazione di licenza di un file di codice.
L’efficienza si costruisce anche con le scaling laws
Un altro contributo ai risultati di MAI-Base-2 proviene dal perfezionamento delle scaling laws, le relazioni matematiche utilizzate per prevedere come cambiano le prestazioni di un modello al crescere delle sue dimensioni, dei dati disponibili e delle risorse computazionali impiegate.
Microsoft ha utilizzato una serie di modelli progressivamente più grandi, organizzati in quelle che definisce scaling ladders, per valutare differenti configurazioni prima di applicarle all’addestramento completo. Le prove hanno consentito di prevedere con maggiore precisione il comportamento della rete su grande scala e di individuare parametri di addestramento più efficaci, limitando la necessità di costosi esperimenti direttamente sul modello finale.
Particolare attenzione è stata dedicata alla ripetizione dei dati durante l’apprendimento. Nei modelli sperimentali più piccoli, Microsoft ha regolato la quantità di esempi unici in modo da mantenere costante il numero delle ripetizioni rispetto alle prove di dimensioni maggiori, migliorando così l’affidabilità delle previsioni.
L’approccio è stato accompagnato da nuove relazioni empiriche per determinare automaticamente alcuni degli iperparametri che governano l’addestramento, tra cui learning rate, weight decay e dropout. Questi valori regolano rispettivamente l’entità degli aggiornamenti dei pesi, la regolarizzazione della rete e la disattivazione temporanea di alcune componenti durante l’apprendimento.
La combinazione di esperimenti su scala ridotta, modelli predittivi e ottimizzazioni dell’infrastruttura ha permesso a Microsoft di impiegare il budget computazionale disponibile su una rete molto più grande, mantenendo sotto controllo l’efficienza dell’intero processo.
Un modello multimodale addestrato su 50.000 miliardi di token
MAI-Base-2 introduce anche una differenza sostanziale rispetto alla generazione precedente: la componente visiva è stata prevista fin dall’inizio dell’addestramento, attraverso un’architettura vision-language model (VLM) che elabora testo e immagini senza ricorrere a un encoder visivo separato.
Il modello è stato quindi addestrato su documenti che combinano immagini e testo, coppie immagine-descrizione e contenuti visivi di diversa natura, sviluppando capacità che comprendono l’interpretazione di grafici, il ragionamento spaziale, la comprensione di documenti medici e l’interazione con interfacce software. Tra le applicazioni considerate da Microsoft figurano anche la lettura degli spartiti musicali e l’interpretazione di contenuti visivi provenienti dal web.
L’addestramento ha utilizzato complessivamente 50.000 miliardi di token, dei quali il 18% proviene dal corpus multimodale, considerando anche le ripetizioni. Quest’ultimo comprende 4.500 miliardi di token unici, mentre la quantità complessiva di dati unici impiegati per MAI-Base-2 è cresciuta di circa il 36% rispetto a MAI-Base-1.
L’espansione del corpus è stata accompagnata dal miglioramento delle procedure di classificazione qualitativa, estrazione dei contenuti dalle pagine web ed eliminazione dei duplicati. Microsoft ha inoltre utilizzato campionamenti basati sugli embedding, rappresentazioni numeriche del significato dei contenuti che consentono di individuare esempi semanticamente simili e privilegiare informazioni differenti, aumentando la varietà dei dati utilizzati.
La società attribuisce particolare importanza anche alla provenienza del materiale impiegato. Tutti i token sono stati elaborati attraverso pipeline interne e l’addestramento utilizza dati originali, senza ricorrere alla distillazione delle risposte di altri modelli AI. Per la raccolta dei contenuti web, Microsoft dichiara di utilizzare un crawler proprietario che rispetta le istruzioni robots.txt e gli altri meccanismi di controllo previsti dai siti, mentre il limite temporale delle conoscenze utilizzate nell’addestramento è marzo 2026.
MAI-Base-2 rafforza la strategia dei modelli proprietari di Microsoft
Il completamento del pre-training di MAI-Base-2 rappresenta un passaggio importante nella strategia di Microsoft AI, che sta costruendo una propria famiglia di modelli fondamentali attraverso il controllo diretto dell’intera filiera, dalla raccolta dei dati all’addestramento e all’ottimizzazione dell’infrastruttura.
Questa impostazione consente alla società di progettare congiuntamente modelli e sistemi di calcolo, adattandoli alle caratteristiche delle piattaforme hardware e alle esigenze delle applicazioni. L’efficienza diventa così un elemento che può incidere sia sulle prestazioni sia sui costi operativi dei servizi, soprattutto quando l’inferenza viene eseguita su grandi volumi di richieste.
Microsoft prevede di utilizzare inizialmente MAI-Base-2 nei propri prodotti e successivamente di renderne disponibili le capacità attraverso Microsoft Foundry. La società intende inoltre concedere in licenza i pesi dei propri modelli a partner selezionati, facendo leva anche sulla tracciabilità dei dati utilizzati durante l’addestramento.
Il modello è attualmente sottoposto al post-training, la fase nella quale le capacità generali acquisite vengono perfezionate attraverso ulteriori procedure di apprendimento, comprese quelle destinate al ragionamento e all’esecuzione di attività specifiche. Parallelamente, Microsoft ha già avviato la preparazione di MAI-Base-3.
Con MAI-Base-2, Microsoft entra dunque nella fascia dei modelli AI con migliaia di miliardi di parametri complessivi, adottando un’architettura che accomuna ormai numerosi protagonisti del settore. La diffusione delle reti MoE rende sempre più importante distinguere fra dimensioni totali, parametri attivi e risorse necessarie per l’elaborazione: tre grandezze che, insieme alla qualità dei dati e alle tecniche di addestramento, contribuiscono a determinare le prestazioni effettive dei modelli e la sostenibilità economica del loro utilizzo.
La continua evoluzione dei modelli richiede applicazioni AI indipendenti dagli LLM
La rapidità con cui si susseguono annunci come MAI-Base-2, Muse Spark Open e Nemotron 3.5 solleva una questione importante per le aziende che stanno sviluppando applicazioni basate sull’intelligenza artificiale. Le prestazioni dei modelli migliorano continuamente, gli equilibri competitivi cambiano nel giro di pochi mesi e le politiche commerciali dei fornitori, dai prezzi per token alle condizioni di accesso e utilizzo, possono evolvere altrettanto rapidamente. In un mercato caratterizzato da questa dinamica, vincolare un’applicazione a un singolo LLM rischia di trasformare una scelta tecnologica inizialmente conveniente in un limite economico e operativo.
Diventa quindi sempre più importante progettare applicazioni nelle quali il modello linguistico costituisca un componente sostituibile, attraverso livelli di astrazione che separino la logica applicativa dalle specificità dei singoli fornitori. Questa impostazione permette di adottare modelli più recenti senza riprogettare l’intero sistema, negoziare condizioni economiche differenti e mantenere maggiore controllo sulla localizzazione dei dati e sulle infrastrutture utilizzate. La sostituibilità richiede comunque di considerare le differenze tra API, gestione del contesto, chiamate agli strumenti e formati delle risposte, oltre a verificare che un nuovo modello garantisca risultati adeguati attraverso test applicativi.
L’evoluzione più interessante riguarda però la possibilità di orchestrare modelli differenti all’interno della stessa applicazione, selezionando dinamicamente quello più appropriato per ciascuna attività. Operazioni relativamente semplici, come classificazione, estrazione di informazioni o instradamento delle richieste, possono essere affidate a modelli compatti ed economici, mentre il ragionamento complesso, la programmazione e l’elaborazione multimodale possono richiedere sistemi più avanzati. La scelta può dipendere anche da latenza, disponibilità del servizio, riservatezza dei dati e costo effettivo dell’inferenza, con meccanismi di model routing capaci di bilanciare questi fattori in funzione delle esigenze operative.
La crescente specializzazione dei modelli e la diffusione delle architetture Mixture of Experts rafforzano questa prospettiva: il vantaggio competitivo delle applicazioni AI dipenderà sempre più dalla capacità di utilizzare e coordinare efficacemente modelli diversi, aggiornandoli quando emergono alternative migliori, piuttosto che dalla scelta di un unico LLM considerato superiore agli altri. Un approccio che consente alle aziende di beneficiare della continua evoluzione tecnologica senza dover inseguire ogni nuovo annuncio con una revisione della propria architettura software.