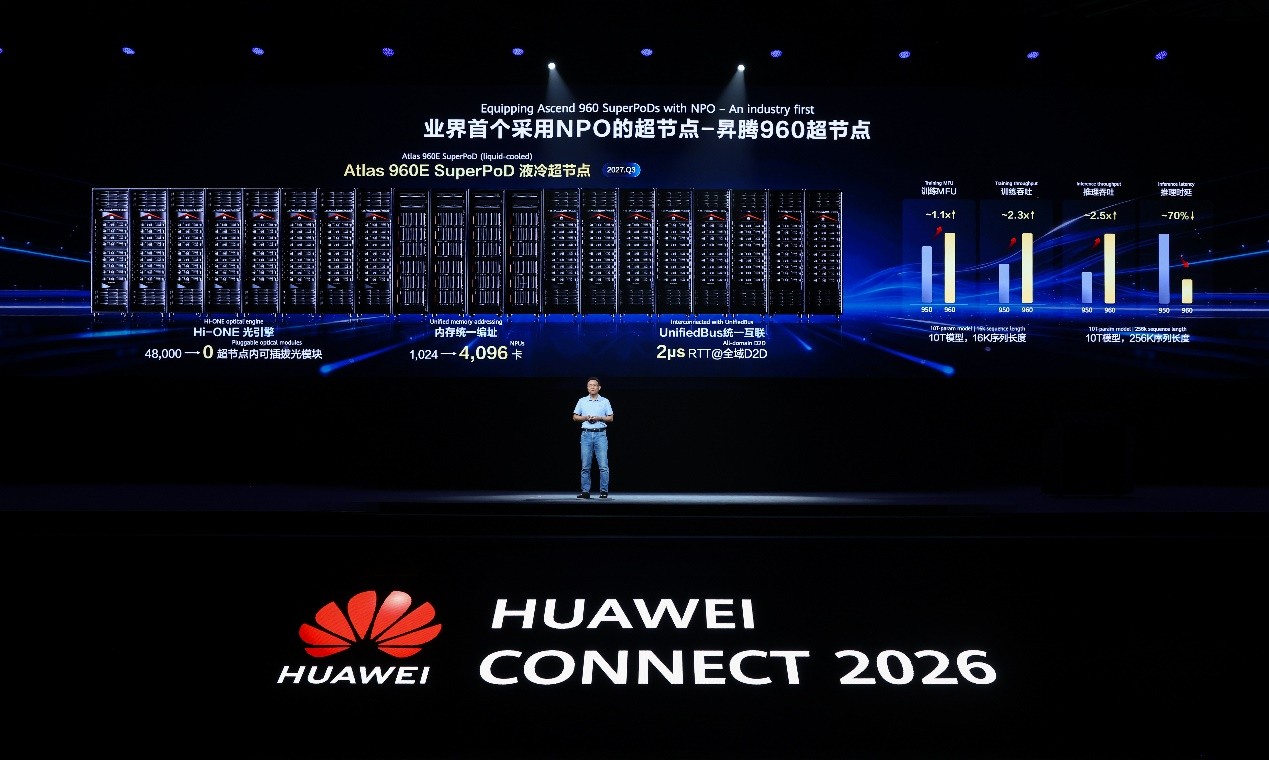
Huawei ha scelto Huawei Connect 2026 di Shanghai per mostrare come intende affrontare uno dei problemi centrali dell’intelligenza artificiale dei prossimi anni: collegare migliaia, e potenzialmente centinaia di migliaia, di acceleratori mantenendo elevate prestazioni, affidabilità ed efficienza energetica. Il nuovo Atlas 960E SuperPoD rappresenta il fulcro di questa strategia e introduce l’interconnessione ottica NPO, Near-Packaged Optics, all’interno di un sistema progettato per training e inferenza dei modelli AI di dimensioni estreme.
Huawei definisce Atlas 960E il primo SuperPoD del settore basato su NPO. Il sistema combina i nuovi acceleratori Ascend 960, l’architettura UnifiedBus e il motore ottico Hi-ONE, con l’obiettivo di creare infrastrutture capaci di comportarsi come un unico grande sistema di calcolo anche quando il numero di NPU cresce fino a diverse migliaia.
L’AI spinge verso infrastrutture di calcolo sempre più grandi
La presentazione parte da un assunto preciso: la crescita dei modelli di intelligenza artificiale sta modificando rapidamente i requisiti dei data center. Secondo i dati illustrati da David Wang, Deputy Chairman of the Board e Rotating Chairman di Huawei, i foundation model si stanno avvicinando alla soglia dei 10 trilioni di parametri e potrebbero superare i 100 trilioni entro il 2030.
Parallelamente aumenta la quantità di elaborazione necessaria per l’inferenza. Huawei indica per la Cina un consumo medio giornaliero già nell’ordine dei 500 trilioni di token, mentre gli agenti AI, oggi capaci di operare autonomamente per alcune ore, potrebbero arrivare entro la fine del decennio a gestire attività distribuite nell’arco di mesi.
Il problema non riguarda quindi soltanto la disponibilità di acceleratori più potenti. Diventa altrettanto importante poter collegare grandi quantità di NPU, condividere memoria e dati con latenze contenute e limitare il consumo energetico dell’infrastruttura di comunicazione.
“Nessuna azienda può costruire da sola un mondo intelligente. Per questo continuiamo a investire nello sviluppo di infrastrutture AI ad alte prestazioni, a supportare l’open source e i sistemi aperti per far crescere gli ecosistemi di computing e lavorare per favorire un successo condiviso con clienti e partner in tutto il mondo”, ha dichiarato Wang.
Atlas 960E SuperPoD e il passaggio alle Near-Packaged Optics
Uno degli elementi tecnologicamente più rilevanti di Atlas 960E è Hi-ONE, il motore di interconnessione ottica sviluppato da Huawei utilizzando un’architettura Near-Packaged Optics.
Con NPO, i componenti ottici vengono portati molto più vicino ai chip di elaborazione rispetto alle architetture tradizionali basate su moduli ottici collegati attraverso percorsi elettrici relativamente lunghi. L’obiettivo è ridurre le perdite del segnale, aumentare la densità di banda e contenere i consumi energetici quando la quantità di dati scambiata tra gli acceleratori cresce.
Huawei dichiara per ogni motore Hi-ONE una capacità di trasmissione di 7,2 Tbit/s e sottolinea la presenza di una sorgente luminosa integrata. Secondo l’azienda, il componente è stato progettato fin dall’origine per una produzione su larga scala.
Hi-ONE diventa così un elemento fondamentale dell’architettura Atlas 960E, perché l’efficienza dell’interconnessione rappresenta uno dei principali fattori limitanti quando migliaia di acceleratori devono lavorare contemporaneamente sullo stesso modello.
Fino a 4.096 NPU in un singolo SuperPoD
Un singolo Atlas 960E SuperPoD può integrare fino a 4.096 NPU utilizzando UnifiedBus e un sistema di memoria unificata.
Huawei dichiara una potenza di calcolo massima di 8 EFLOPS in FP8 e 16 EFLOPS in FP4, accompagnata da una capacità complessiva della memoria HBM fino a 1 petabyte.
Sono valori pensati soprattutto per il training e l’inferenza di foundation model di grandi dimensioni. Il sistema è stato progettato, secondo Huawei, per gestire modelli che possono arrivare fino a 10 trilioni di parametri, collocandosi quindi nella fascia delle infrastrutture AI destinate ai workload più impegnativi.
La disponibilità di una memoria HBM aggregata nell’ordine del petabyte è altrettanto significativa della potenza di calcolo. Con l’aumento delle dimensioni dei modelli, infatti, non basta incrementare il numero di acceleratori: diventa necessario rendere rapidamente disponibili pesi, attivazioni e dati intermedi senza trasformare il sottosistema di memoria in un collo di bottiglia.
Hi-ONE riduce il numero dei moduli ottici
L’impiego di NPO interviene anche sui consumi dell’infrastruttura.
Atlas 960E integra circa 5.500 unità Hi-ONE. Huawei sostiene che questa architettura consenta di evitare l’utilizzo di circa 48.000 moduli ottici 800G che sarebbero altrimenti necessari per realizzare l’interconnessione fra tutte le NPU con un approccio convenzionale.
Il risultato dichiarato è una riduzione della potenza assorbita superiore a 550 kW.
Su infrastrutture AI di questa scala, il tema assume particolare rilevanza. I consumi associati al networking e all’interconnessione possono infatti diventare una componente consistente dell’assorbimento complessivo del cluster, andando ad aggiungersi ai requisiti energetici già molto elevati degli acceleratori e dei sistemi di raffreddamento.
Huawei punta anche sull’affidabilità del sistema
La crescita della scala introduce inevitabilmente un altro problema: aumentando il numero dei componenti cresce anche la probabilità che uno di essi presenti un malfunzionamento.
Huawei afferma di aver lavorato sull’affidabilità dell’architettura Atlas 960E fino a ottenere una disponibilità complessiva del 99,8% e un raddoppio del tempo medio di funzionamento senza interruzioni.
È un aspetto particolarmente importante durante il training dei foundation model, dove un lavoro può impegnare migliaia di acceleratori per periodi prolungati e un problema hardware o di interconnessione può incidere direttamente sui tempi necessari per completare l’elaborazione.
UnifiedBus diventa la base dell’architettura Huawei
Atlas 960E non è però un prodotto isolato. Il progetto rientra in una strategia infrastrutturale più ampia costruita attorno a UnifiedBus, tecnologia che Huawei sta estendendo a diversi livelli della propria piattaforma di calcolo.
Durante Huawei Connect 2026 l’azienda ha infatti presentato anche un aggiornamento di TaiShan 950 SuperPoD, sistema destinato al general-purpose computing.
La piattaforma utilizza una rete UnifiedBus completamente ottica e può scalare fino a 4.096 nodi, mettendo a disposizione un pool di memoria unificata che raggiunge i 256 TB.
L’obiettivo, in questo caso, è creare un ambiente in cui CPU, memoria e risorse di elaborazione possano essere aggregate su scala molto ampia, rispondendo in particolare alle esigenze degli agenti AI e dei workload che richiedono l’accesso rapido a grandi quantità di informazioni.
OceanStor M900 porta lo storage nella memoria contestuale dell’AI
La stessa architettura viene utilizzata anche da OceanStor M900, nuovo cluster di storage progettato per la cosiddetta memoria contestuale dei sistemi di intelligenza artificiale.
Huawei descrive M900 come una piattaforma capace di offrire accesso diretto a singolo hop e una KV cache su scala petabyte destinata al livello L3.5 della gerarchia di memoria.
La KV cache, abbreviazione di Key-Value cache, è diventata uno degli elementi centrali dell’inferenza dei modelli linguistici. Conservando le rappresentazioni già calcolate durante l’elaborazione delle sequenze, permette di evitare una parte consistente dei calcoli ridondanti e può migliorare sensibilmente latenza e throughput.
Portare questa capacità su una piattaforma di storage condivisa e su scala petabyte punta soprattutto ai grandi ambienti nei quali numerosi modelli, agenti e sessioni di inferenza devono accedere contemporaneamente a una quantità crescente di contesto.
Dai SuperPoD ai SuperCluster da centinaia di migliaia di NPU
La parte più ambiziosa della strategia Huawei riguarda però il passaggio dal singolo SuperPoD al SuperCluster.
Più Atlas 960E possono essere collegati attraverso UnifiedBus o RoCE, costruendo infrastrutture nelle quali la capacità computazionale viene aggregata su una scala molto superiore a quella del singolo sistema.
Huawei descrive un’architettura Clos a due livelli e quattro piani capace di interconnettere fino a 512.000 NPU.
Attraverso una topologia multi-rail, l’azienda sostiene che l’infrastruttura possa successivamente arrivare fino a un milione di NPU.
A queste dimensioni la complessità dell’infrastruttura cambia ordine di grandezza. Networking, sincronizzazione, memoria, distribuzione dei workload, tolleranza ai guasti e gestione energetica diventano parti integranti dell’architettura computazionale, anziché semplici componenti di supporto.
Huawei costruisce la propria alternativa infrastrutturale per l’AI
Con Atlas 960E, Huawei cerca quindi di spostare il confronto dall’acceleratore individuale all’intero sistema.
Ascend 960 rappresenta la componente di elaborazione, Hi-ONE quella di interconnessione ottica, UnifiedBus il tessuto che collega le risorse, mentre TaiShan 950 e OceanStor M900 estendono la stessa logica al general-purpose computing e alla gestione della memoria contestuale.
È un approccio coerente con l’evoluzione delle infrastrutture AI, nelle quali le prestazioni complessive dipendono sempre meno dal singolo processore e sempre più dalla capacità di far lavorare insieme migliaia di acceleratori, memoria e storage come componenti di un unico sistema distribuito.
Con Huawei Connect 2026, l’azienda cinese mette quindi al centro della propria strategia SuperPoD e SuperCluster, indicando nell’integrazione fra calcolo, interconnessione ottica e memoria condivisa la strada per sostenere la crescita dei modelli e degli agenti AI nei prossimi anni.