Il debutto della nuova generazione Gemini comincia dalla difesa informatica: Gemini 4 Argon entra in distribuzione presso un primo gruppo di partner selezionati del programma Fairwind, mentre Google prepara l’accesso più ampio per sviluppatori, imprese e consumatori. Il modello combina ragionamento approfondito, capacità multimodali e gestione di attività complesse che richiedono numerosi passaggi, con applicazioni nello sviluppo software e nel lavoro professionale, dalla finanza al settore legale. Già utilizzato all’interno di Google, introduce un limite di output fino a un milione di token, rispetto ai precedenti 64 mila.
La distribuzione procede per fasi, accompagnata dalla partecipazione di Google al processo volontario del governo statunitense per la valutazione dei modelli prima del rilascio. Le aziende aderenti consentono ai ricercatori governativi di accedere in anticipo ai sistemi per esaminarne le capacità e i potenziali rischi per la sicurezza nazionale, soprattutto in ambito informatico, biologico e chimico. Queste collaborazioni fanno capo al Center for AI Standards and Innovation (CAISI), all’interno del NIST, l’istituto statunitense per gli standard e la tecnologia del Dipartimento del Commercio. Google DeepMind ha sottoscritto un accordo con il centro, insieme a Microsoft e xAI, nel maggio 2026. Il confronto sui risultati delle valutazioni aiuta gli sviluppatori a migliorare le protezioni dei modelli prima della diffusione su larga scala.
Anche le valutazioni dei primi utilizzatori serviranno a rafforzare le protezioni prima dell’apertura al pubblico, che inizierà dai clienti delle API a pagamento e dagli abbonati Google AI Ultra. Google punta a estendere l’accesso il prima possibile.
Un milione di token per attività più lunghe
L’ampliamento del limite di output permette al modello di sviluppare ragionamenti e generare centinaia di migliaia di token lungo una singola sequenza di lavoro. Questa capacità sostiene l’esecuzione di problemi articolati in più passaggi e di attività di lunga durata, nelle quali occorre mantenere continuità fra analisi, uso degli strumenti e produzione del risultato. Il milione di token riguarda la quantità massima generabile in output; il riferimento è quindi alla capacità di elaborazione e generazione durante il compito.
Nello sviluppo software, gli ingegneri di Google utilizzano Argon per il debugging quotidiano, la progettazione di algoritmi e la migrazione di grandi basi di codice. Su DeepSWE v1.1 raggiunge il 77,9%, stabilendo il miglior risultato nella valutazione di attività di ingegneria del software reali e di lunga durata.
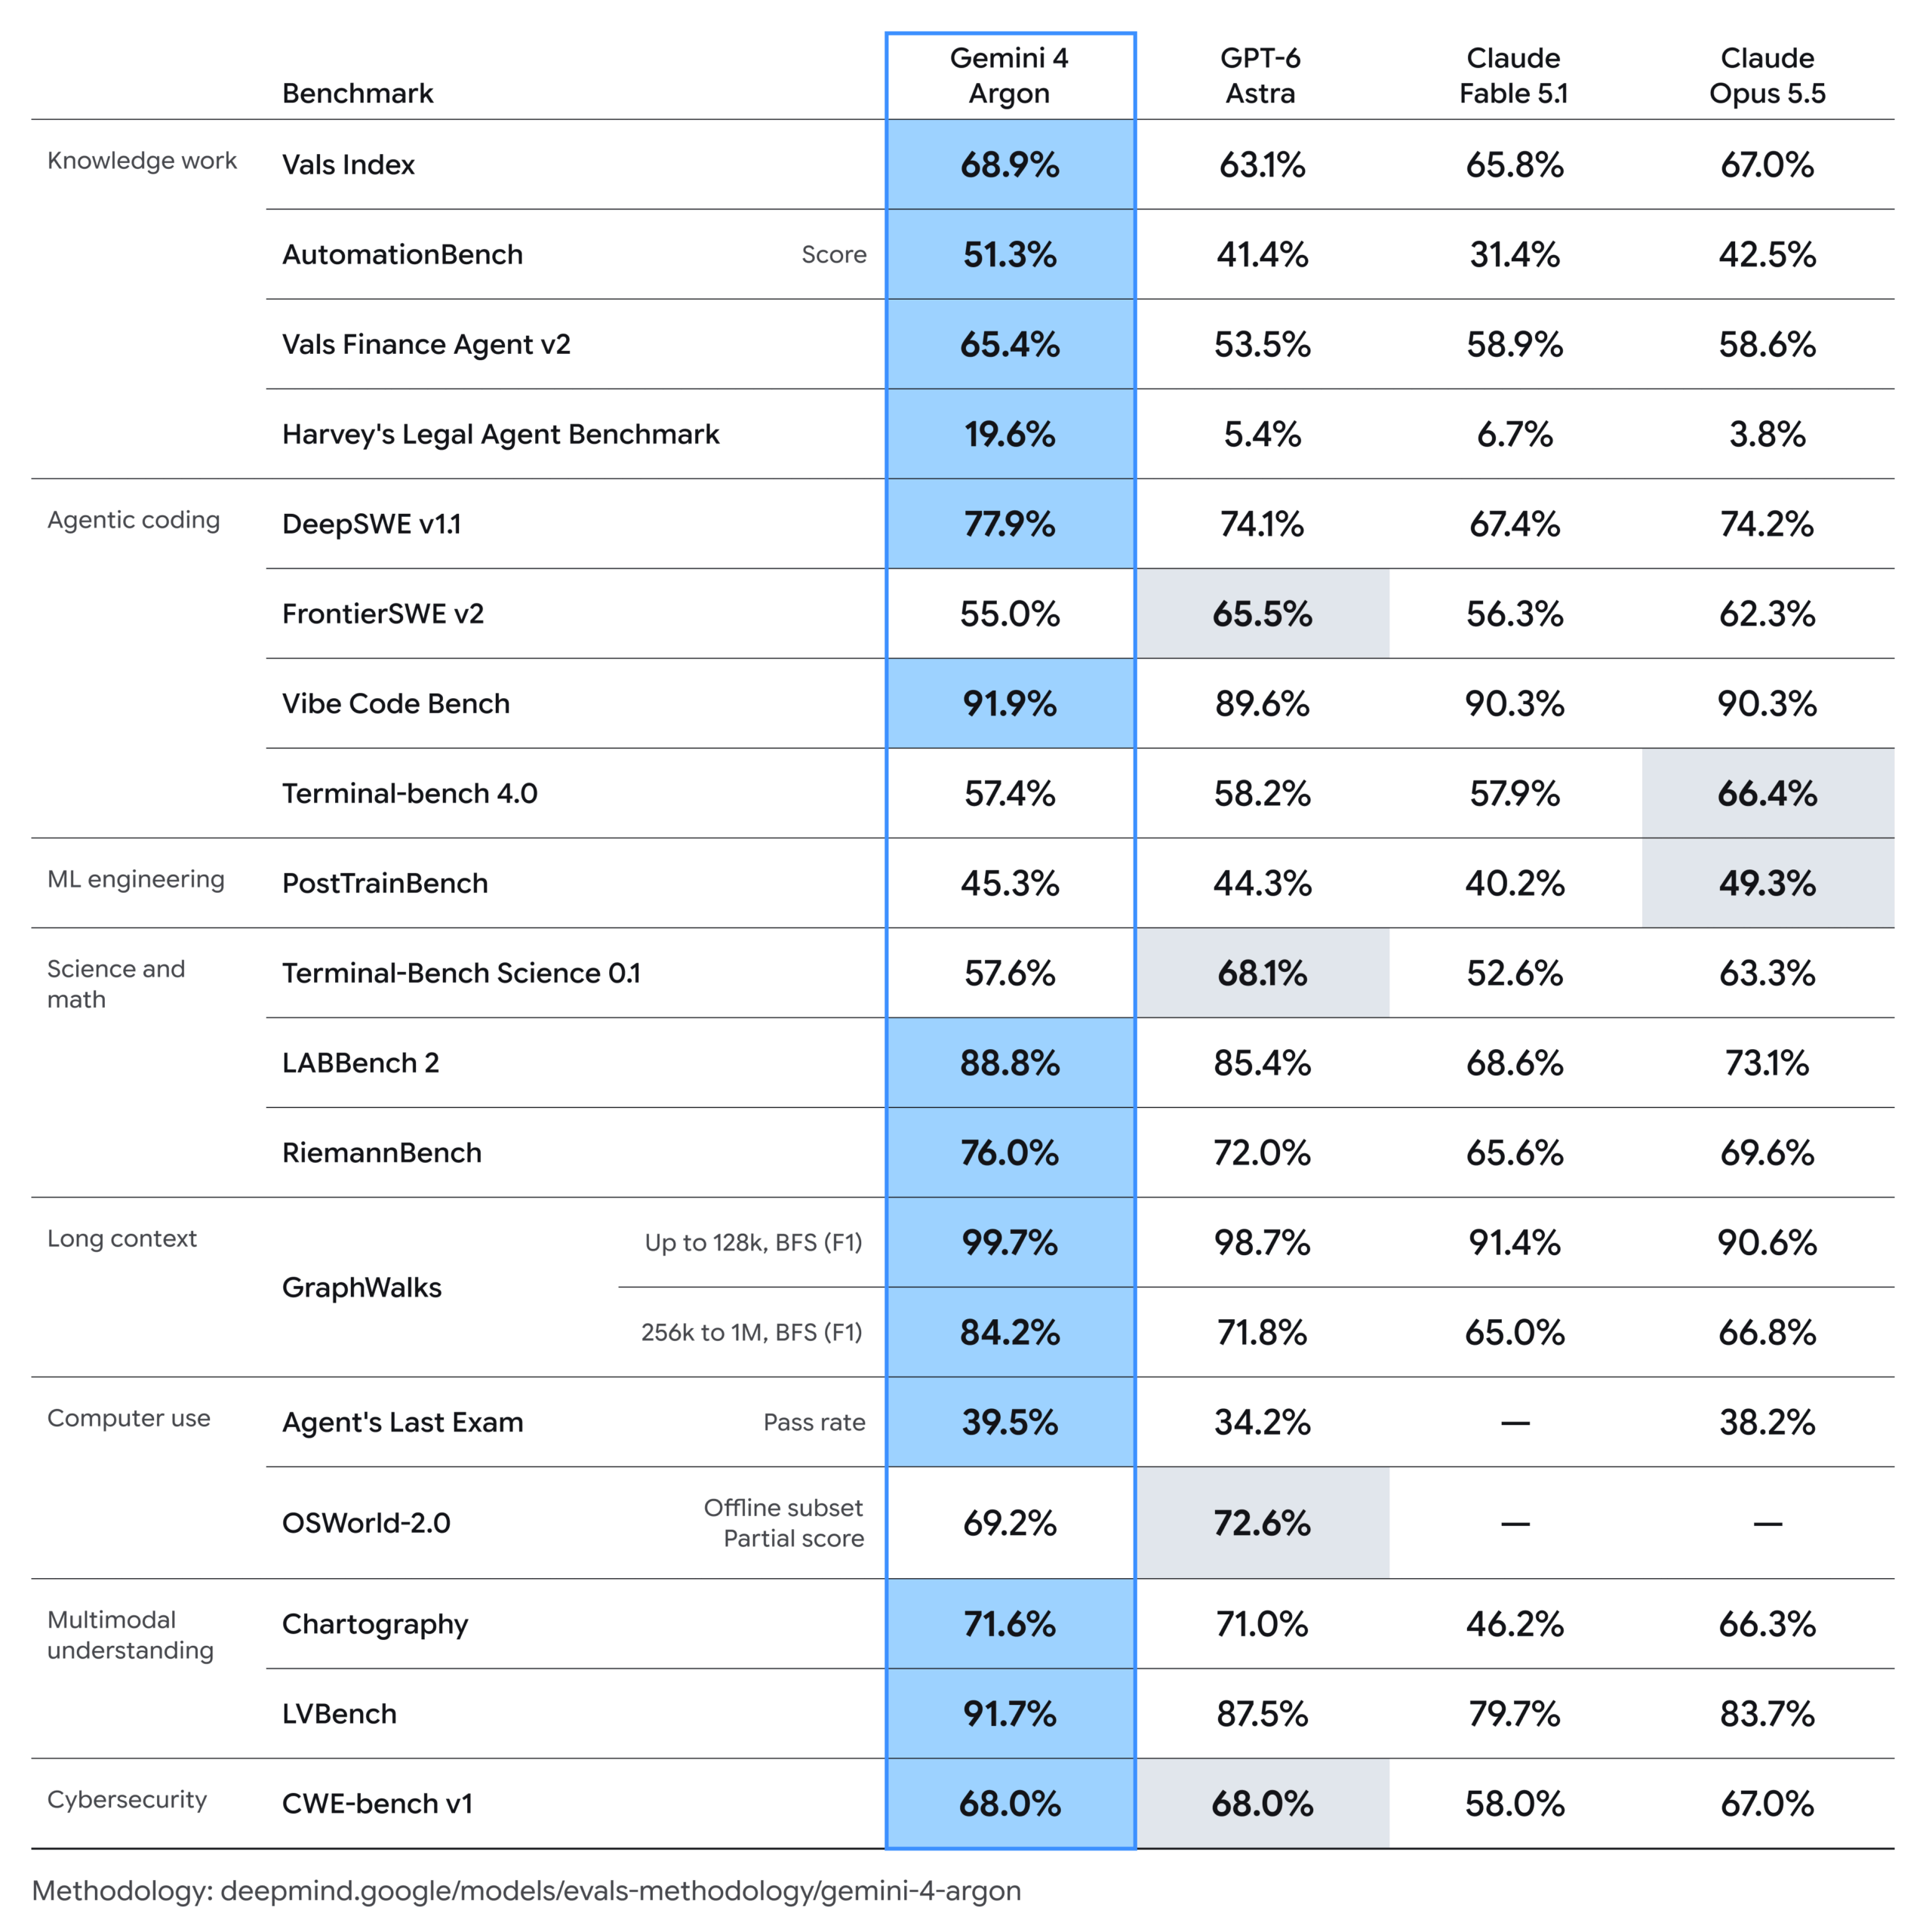
Le prestazioni cambiano con il tipo di prova: su FrontierSWE v2 Argon registra il 55%, mentre GPT-6 Astra raggiunge il 65,5%; su Terminal-bench 4.0 il risultato di Argon è del 57,4%, con Claude Opus 5.5 al 66,4%. Anche nelle valutazioni di ingegneria del machine learning e nelle attività scientifiche eseguite da terminale il punteggio più alto appartiene ad altri modelli: Opus 5.5 raggiunge il 49,3% su PostTrainBench, contro il 45,3% di Argon, e Astra il 68,1% su Terminal-Bench Science 0.1, contro il 57,6% di Argon.
Finanza, settore legale e automazione aziendale
Nel Vals Index, che valuta attività in finanza, programmazione, diritto e fiscalità attribuendo a ciascun settore un peso legato al suo contributo al Pil statunitense, Argon ottiene il 68,9%. Il risultato supera il 63,1% di GPT-6 Astra, il 65,8% di Claude Fable 5.1 e il 67% di Claude Opus 5.5. Nelle prove specialistiche, il modello raggiunge il 65,4% su Vals Finance Agent v2, dedicato alla ricerca finanziaria in più passaggi, e il 19,6% sull’Harvey’s Legal Agent Benchmark, che comprende ricerca giuridica e redazione di testi legali.
Per l’automazione delle funzioni aziendali, AutomationBench di Zapier assegna ad Argon il primo posto con il 51,3%. Il benchmark misura l’esecuzione completa di attività nelle principali funzioni d’impresa; nella stessa comparazione Astra ottiene il 41,4%, Fable 5.1 il 31,4% e Opus 5.5 il 42,5%.
La componente multimodale estende queste capacità all’analisi professionale di grafici, all’identificazione di dettagli all’interno di video lunghi e all’esecuzione di azioni sulla base di una sequenza di documenti. Su LVBench, dedicato alla comprensione di video lunghi, Argon stabilisce il miglior risultato con il 91,7%, mentre su Chartography raggiunge il 71,6%. Nei test sul contesto lungo GraphWalks, il punteggio F1 per le attività di ricerca in ampiezza nei grafi è del 99,7% fino a 128 mila token e dell’84,2% nell’intervallo da 256 mila a un milione di token.
Altri risultati di punta riguardano LABBench 2, con l’88,8%, e RiemannBench, con il 76%. Nell’uso del computer, Argon ottiene il 39,5% di superamento delle prove su Agent’s Last Exam, mentre sul sottoinsieme offline di OSWorld-2.0 il punteggio parziale è del 69,2%, rispetto al 72,6% di Astra.
Le applicazioni già attive in Google
Migliaia di dipendenti Google hanno utilizzato Argon per programmazione specialistica, ricerche approfondite e scrittura. Fra gli impieghi più concreti c’è l’ottimizzazione degli algoritmi quantistici: il modello aiuta i ricercatori a ridurre le risorse spazio-temporali, espresse come prodotto fra qubit e porte, richieste da subroutine che costituiscono un collo di bottiglia per applicazioni importanti. In un caso, ha migliorato del 40% il risultato di riferimento pubblicato nel giro di pochi minuti.
Nei data center, un gruppo di agenti Argon ha analizzato la telemetria di profilazione dell’intera infrastruttura per individuare e applicare autonomamente ottimizzazioni della memoria. Una volta distribuite, queste modifiche hanno liberato oltre 300 TiB di memoria, con un risparmio totale stimato fra 500 TiB e un PiB.
Le migrazioni da C e C++ a Rust coinvolgono basi di codice che vanno dalle decine di migliaia di righe di librerie fondamentali come re2 e libgav1 alle oltre 800 mila righe del kernel Zircon di Fuchsia OS. Per la criticità di questi sistemi, le riscritture sono sottoposte ad audit automatici e manuali, test in emulazione e revisioni prima dell’impiego in produzione.
Un esempio dettagliato riguarda libgav1, il software open source di Google per la decodifica video. Partendo da un porting Rust esistente, gli agenti hanno sostituito 32 mila righe di codice SIMD attraverso ripetuti esperimenti guidati dalla profilazione e l’analisi dell’output del compilatore. Hanno così prodotto codice Rust sicuro che il compilatore può vettorizzare automaticamente: il decoder risultante mantiene un output video identico e funziona 2,7 volte più velocemente del porting Rust di partenza, avvicinandosi alle prestazioni della versione C++ ottimizzata.
Ricerca e correzione delle vulnerabilità
Sul fronte della cybersecurity, Argon può individuare, validare e correggere autonomamente vulnerabilità software critiche. Ai partner fidati e ai team interni di Google viene fornita una versione priva dei guardrail specifici per il cyber, così da consentire l’uso completo delle capacità di difesa informatica. L’accesso iniziale avviene attraverso il Fairwind Program, rivolto a soggetti come governi, operatori di infrastrutture critiche e piattaforme tecnologiche.
Il programma conta oltre 650 partner nel mondo; un gruppo selezionato accede ad Argon, utilizzabile anche con CodeMender per la ricerca e la correzione delle vulnerabilità. La partecipazione prevede controlli sulle organizzazioni, autenticazione degli utenti, MFA resistente al phishing e tracciamento degli accessi e dell’uso. L’accesso resta riservato ai team interni di cybersecurity, risposta agli incidenti e penetration testing, con divieto di condivisione, rivendita o redistribuzione. Gli impieghi a duplice uso, come simulazione autorizzata delle minacce, reverse engineering e analisi del malware, sono consentiti per difesa e ricerca.
Wiz utilizza già Argon nell’iniziativa Scan for Good, che protegge gratuitamente infrastrutture pubbliche critiche identificando e risolvendo esposizioni ad alto rischio. In una prima applicazione, il modello ha scoperto una vulnerabilità critica che esponeva informazioni personali sensibili in software sanitari utilizzati da ospedali in tutto il mondo, individuando un rischio che i precedenti modelli di frontiera non avevano rilevato.
Su CWE-bench v1, dedicato alla correzione delle vulnerabilità, Argon raggiunge il 68%, al primo posto a pari merito con GPT-6 Astra e Grok 4.7, proseguendo i risultati di Gemini 3.8 Flash Cyber su CWE-bench v0. Nel benchmark interno di Google sulla scoperta di vulnerabilità reali, che comprende basi di codice complesse in 20 linguaggi di programmazione, Argon ottiene l’85,8%, rispetto al 71% di Flash Cyber. Nel test interno di penetration testing di Wiz arriva al 70,9%, contro il 58,2% del precedente modello: la prova richiede di analizzare sistemi web attivi senza accedere al codice sorgente, ricostruire la superficie di attacco, individuare vulnerabilità e produrre evidenze proof of concept per validarle.
Le protezioni prima dell’apertura generale
Prima della distribuzione estesa, Google sta rafforzando le protezioni in quattro aree. Per contrastare gli abusi, il modello è progettato per rifiutare richieste dannose in ambito cyber e chimico, biologico, radiologico e nucleare, preservando la ricerca scientifica legittima a duplice uso secondo il Frontier Safety Framework. Le tecniche comprendono il monitoraggio delle attivazioni interne del modello per individuare utilizzi impropri e verifiche di robustezza condotte da red team interni ed esterni, con attacchi manuali e automatici.
Contro le prompt injection indirette, nelle quali istruzioni malevole inserite nel contesto cercano di deviare il comportamento del sistema, Google ha impiegato red teaming automatizzato e addestramento avversario. Argon risulta il modello Google più resistente a questi attacchi e guida il benchmark Indirect Prompt Injection di Gray Swan; con 15 tentativi, il tasso di successo degli attacchi è dello 0,7%.
Il monitoraggio del disallineamento controlla il ragionamento e le azioni di Argon, interrompendo l’esecuzione quando il sistema cerca di raggiungere un obiettivo oltre le intenzioni dell’utente. Un meccanismo analogo è stato utilizzato durante l’addestramento, con avvisi a un team dedicato alla risposta agli incidenti. Google ha adottato precauzioni per evitare che gli esiti di questi controlli rientrassero nell’addestramento e inducessero il modello a eludere il monitoraggio; sostiene inoltre la trasparenza del ragionamento come strumento per identificare e diagnosticare il disallineamento.
La quarta area riguarda gli ambienti di esecuzione: le sandbox vengono isolate e sigillate prima dell’avvio di addestramenti o valutazioni ad alto rischio, in linea con la roadmap di sicurezza degli agenti. Google intende condividere queste pratiche con i partner.
I prezzi API e i primi destinatari
Per l’accesso tramite API, il prezzo introduttivo sarà di 2 dollari per milione di token in input e 10 dollari per milione di token in output, con uno sconto del 95% sul prezzo dei token in input recuperati dalla cache. Terminato il periodo introduttivo, si applicheranno le tariffe di 4 dollari per milione di token in input e 20 dollari per milione di token in output. La successiva distribuzione a sviluppatori, imprese e consumatori partirà dai clienti API a pagamento e dagli abbonati Google AI Ultra.
La gara degli LLM: gli annunci di settembre 2026
Dal 28 al 30 settembre, la gara dei grandi modelli linguistici ha registrato un nuovo annuncio ogni giorno: Claude Sonnet 5.5 il 28, GPT-6.1 Sol il 29 e Gemini 4 Argon il 30. Google, OpenAI e Anthropic aggiornano le proprie famiglie a distanza di giorni o settimane, alternando modelli per i compiti più complessi, versioni più rapide ed economiche e configurazioni riservate ai professionisti della sicurezza. La competizione riguarda la qualità del ragionamento e del codice, il costo delle attività e la capacità di completare lavori lunghi usando strumenti e applicazioni.
Il ritmo è evidente anche all’interno delle singole famiglie: con Gemini 3.8 Flash, presentato il 2 settembre, Google aveva già raggiunto tre aggiornamenti Flash in sei settimane. Argon segna ora il passaggio alla generazione Gemini 4, con un primo accesso concentrato sulla difesa informatica e risultati che lo mettono a confronto con GPT-6 Astra e Claude Fable 5.1 e Opus 5.5.
1 settembre – Claude Fable 5.1 e Mythos 5.1. Stesso modello con protezioni diverse: Fable disponibile sulle piattaforme Claude, Mythos riservato ai programmi di accesso verificato per cybersecurity e scienze della vita.
2 settembre – Gemini 3.8 Flash e Flash Cyber. Miglioramenti nel coding e nelle attività con agenti; la variante Cyber è riservata ai partner Fairwind.
3 settembre – GPT-6 Astra. Disponibile via API per ragionamento, coding, ricerca, uso del computer e creazione di documenti in attività complesse.
15 settembre – Gemini 3.8 Live e Live Extended Thinking. Nuovi modelli per il dialogo vocale, con miglioramenti nel ragionamento parallelo e nell’esecuzione di compiti complessi tramite la voce.
22 settembre – Claude Opus 5.5. Disponibile sulle piattaforme Claude e sui principali cloud, con capacità vicine a Fable 5.1 nella maggior parte dei lavori e un costo medio per attività inferiore del 40% rispetto a Opus 5.
22 settembre – GPT-6 Sol e GPT-6 Luna. Disponibili via API, ampliano la famiglia GPT-6 con modelli per il coding e il lavoro con agenti e per attività ad alto volume e costo contenuto.
28 settembre – Claude Sonnet 5.5. Disponibile sulle piattaforme Claude: genera output oltre il 30% più velocemente di Sonnet 5 e costa fino al 30% meno per attività.
29 settembre – GPT-6.1 Sol. Nuovo modello disponibile via API per coding complesso e lavoro professionale, a un costo inferiore rispetto ad Astra.
30 settembre – Gemini 4 Argon. Primo accesso ai partner di difesa informatica Fairwind; output fino a un milione di token e successiva apertura ai clienti API a pagamento e agli abbonati Google AI Ultra.