Anthropic ha presentato Claude Sonnet 5.5, secondo modello della famiglia Claude 5.5 dopo Opus 5.5. Rispetto a Sonnet 5 genera output oltre il 30% più velocemente e, secondo i test dell’azienda, costa fino al 30% in meno per singolo compito. Il listino resta identico a quello di Sonnet 5: 2 dollari per milione di token in ingresso, 10 in uscita e 0,20 per le letture della cache. Opus 5.5 costa il doppio su input, output e scritture in cache (4, 20 e 5 dollari), mentre le letture della cache hanno lo stesso prezzo.
Un ruolo complementare a Opus 5.5
Anthropic presenta Sonnet 5.5 come un complemento più veloce e meno costoso di Opus 5.5. Quest’ultimo resta il riferimento per il lavoro complesso, che richiede giudizio accurato. Sonnet 5.5 dà il meglio su attività ben delimitate, correzione di bug e produzione di documenti, presentazioni e fogli di calcolo. L’azienda sottolinea anche una certa sensibilità per il design. Claude Haiku 5.5, pensato per applicazioni ad alto volume e sensibili ai costi, arriverà nelle prossime settimane.
I numeri
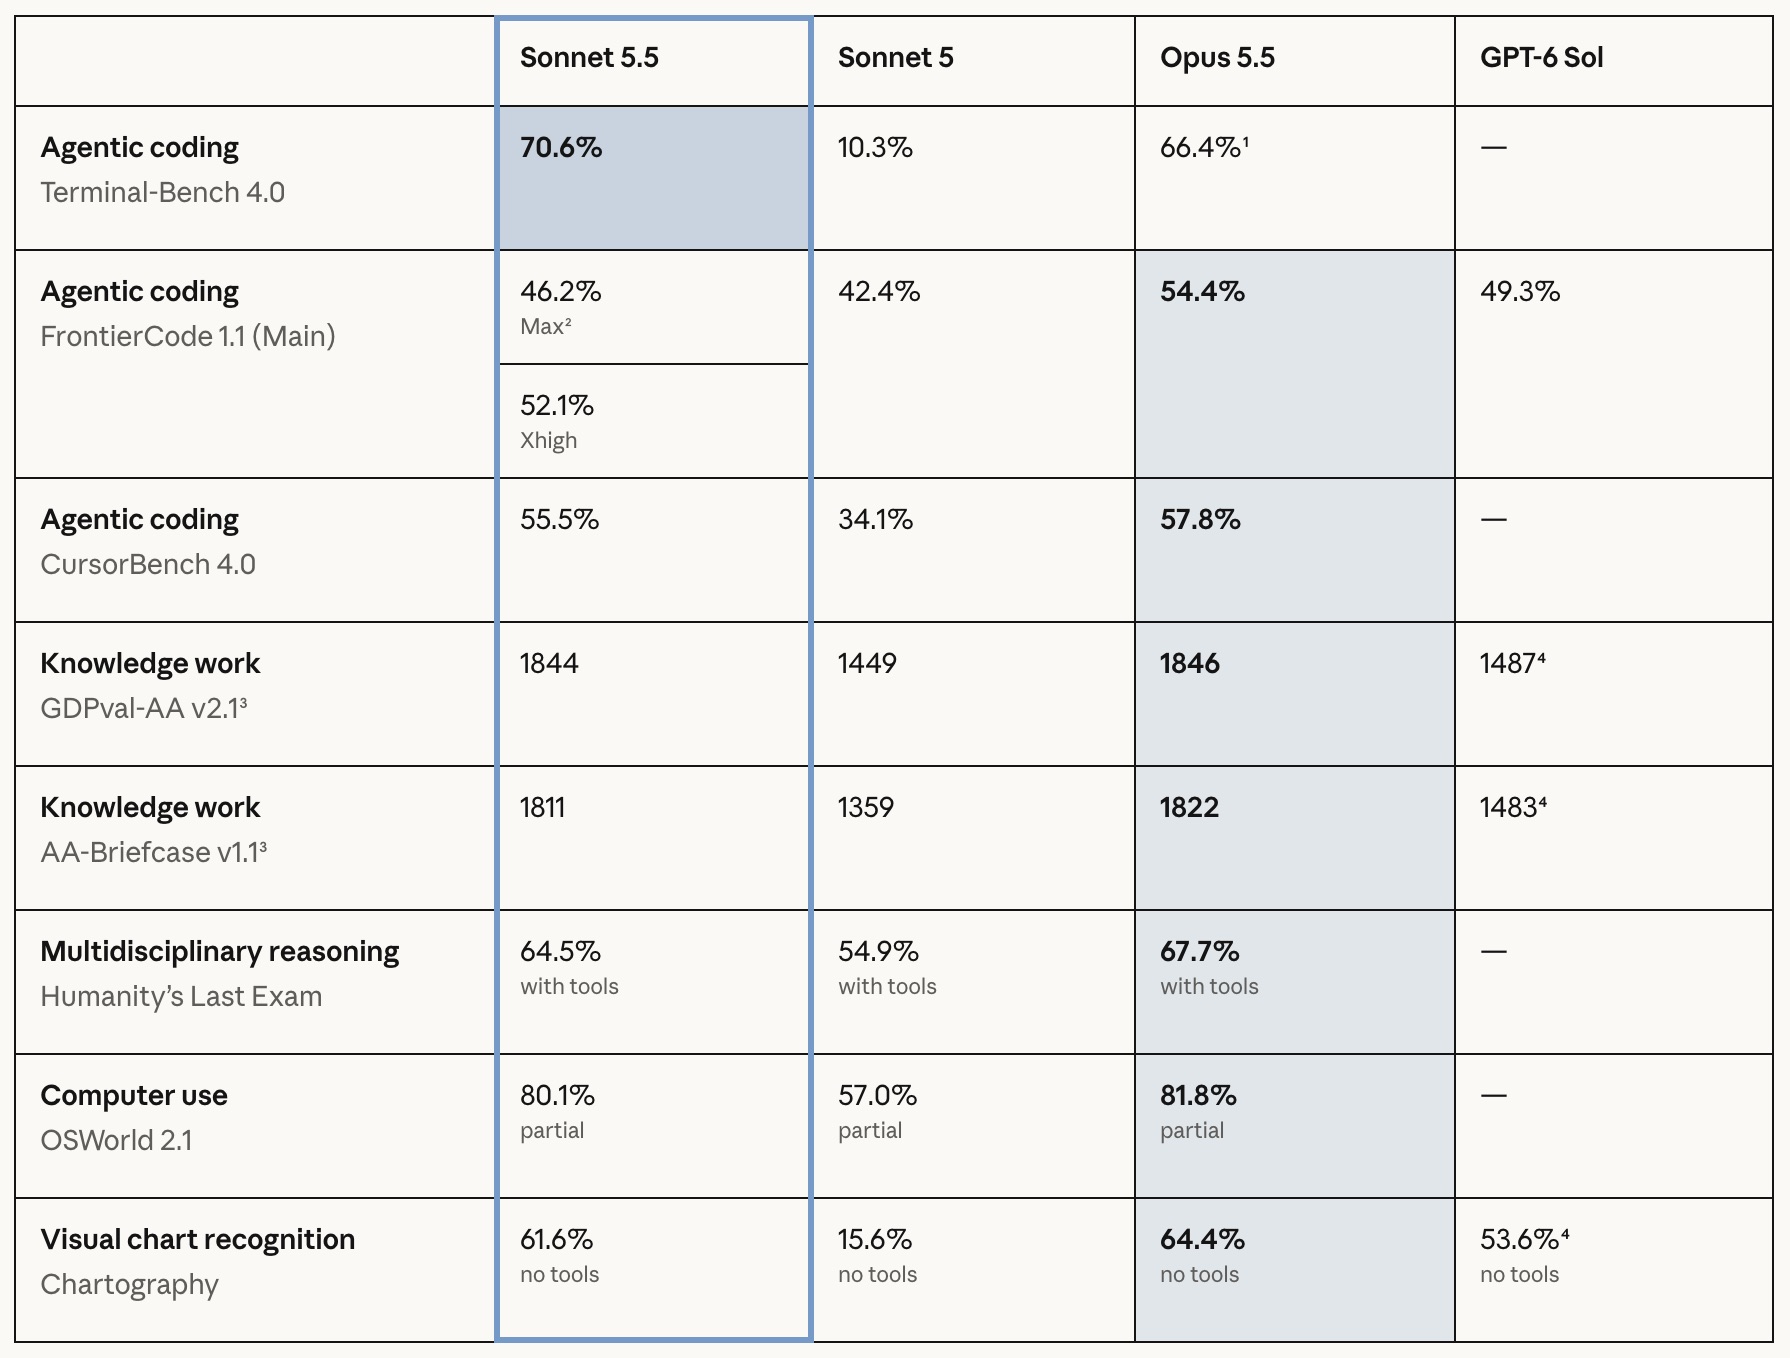
Il dato che colpisce di più riguarda Terminal-Bench 4.0, test di coding agentico: Sonnet 5.5 totalizza il 70,6%, contro il 10,3% di Sonnet 5 e il 66,4% di Opus 5.5 (il suo risultato migliore, ottenuto con sforzo Xhigh). Su CursorBench 4.0, costruito su sessioni reali di sviluppo, arriva al 55,5%, a meno di tre punti da Opus 5.5 (57,8%) e ben sopra il 34,1% del predecessore.
Su FrontierCode 1.1, che misura se le modifiche al codice di un agente potrebbero essere integrate senza correzioni umane, ottiene il 52,1% con sforzo Xhigh, contro il 54,4% di Opus 5.5 e il 49,3% di GPT-6 Sol. A sforzo Max il punteggio scende al 46,2%. Anthropic lo attribuisce al fatto che in quella modalità il modello ricorre più spesso alla revisione distribuita su più subagenti, che in due casi esaminati da Cognition ha prodotto timeout o modifiche fuori ambito, penalizzate dal test.
Nel knowledge work, GDPval-AA v2.1, che copre compiti reali di 44 professioni e nove settori, assegna a Sonnet 5.5 un punteggio di 1844, praticamente pari ai 1846 di Opus 5.5 e circa 400 punti sopra Sonnet 5. Vicinanza a Opus anche in uso del computer (OSWorld 2.1, risultato riportato come parziale: 80,1% contro 81,8%) e nel riconoscimento di grafici (Chartography: 61,6% contro 64,4%, con Sonnet 5 fermo al 15,6%). Anthropic segnala inoltre che è il primo modello Sonnet a completare Pokémon Red lavorando solo con screenshot.
I risultati sono riportati da Anthropic, e alcuni test sono stati eseguiti da terzi. GDPval-AA e AA-Briefcase sono stati eseguiti da Artificial Analysis su una versione di pre-rilascio che presentava un bug con gli output strutturati, poi corretto: secondo Anthropic l’effetto, se presente, è contenuto e tende a sottostimare il modello. I punteggi di GPT-6 Sol potrebbero inoltre non riflettere l’ultima versione, dopo la correzione di un bug sulla comprensione delle immagini. L’azienda stessa precisa che i benchmark restituiscono una sola sfaccettatura e che Opus 5.5 resta nettamente più solido sui compiti complessi.
Meno token, stessi risultati
Il risparmio deriva soprattutto dall’efficienza. Nei test comparativi, riferiscono i tester citati da Anthropic, Sonnet 5.5 raggruppa più chiamate agli strumenti e chiude i compiti in meno passaggi. Ai livelli di sforzo Low e Medium supera il miglior punteggio di Sonnet 5 su diversi test spendendo circa un decimo per compito. Nei client Claude e in Claude Code lo sforzo predefinito è Medium, mentre su Claude Platform è High.
I partner citati dall’azienda riportano numeri coerenti. Balyasny Asset Management, su una suite privata di 2.441 compiti finanziari, ha misurato circa 121 mila token per risposta contro i 497 mila di Sonnet 5. Box parla di velocità 2,4 volte superiore e di controlli sui documenti sorgente che intercettano errori sfuggiti al modello precedente. Zendesk dichiara ticket elaborati il 20% più in fretta, Slack circa il 14% di token in meno in uscita. Base44 ha ottenuto app equivalenti a quelle di Opus 5 in 3,6 iterazioni per build, contro le 7,7 richieste da Opus 5. Kevin Ngo, creative coder di Creator, dice che quando Opus 5.5 imposta architettura e struttura di un gioco, “mi sentirei sicuro nel lasciare a Sonnet 5.5 l’implementazione” (traduzione dall’inglese).
In un test interno, Anthropic ha fornito al modello i materiali trimestrali e le trascrizioni delle conference call di un’azienda quotata, più un template, chiedendo una revisione operativa di dieci slide. Due esperti hanno giudicato la prima bozza pronta per l’invio senza modifiche.
Sicurezza e salvaguardie
Sonnet 5.5 è il primo Sonnet a debuttare con salvaguardie cyber e fallback analoghi a quelli dei modelli più capaci:fallback compreso: quando un classificatore blocca una richiesta, la risposta viene affidata a un modello meno potente. La system card lo colloca sotto Opus 5.5 e Mythos 5.1 in ambito cyber, ma con un salto netto rispetto a Sonnet 5. Su Binary Exploitation Benchmark, dove il modello deve trovare una vulnerabilità in un progetto open source e scrivere un exploit, produce 50 dirottamenti del flusso di controllo contro i 3 di Sonnet 5 (106 per Opus 5.5, 81 per Mythos 5.1). Su CyScenarioBench, che misura operazioni cyber articolate in più fasi, completa il 46,1% delle sfide contro lo 0,7% del predecessore. Questi risultati sono ottenuti con le salvaguardie disattivate.
Tre livelli di controllo sulla cyber
Come su Opus 5.5, il sistema si articola in tre stadi: una sonda che analizza le attivazioni interne del modello, un classificatore leggero che gira su Sonnet 5.5 stesso e un classificatore LLM addestrato, un modello separato che decide, insieme al verdetto della sonda, se bloccare la conversazione. La policy è quella di Opus 5 e Opus 5.5: consente la ricerca di vulnerabilità nel codice sorgente, così che gli sviluppatori possano scrivere software più sicuro, ma la blocca nei binari compilati.
Quando un controllo scatta, la risposta passa a Sonnet 5 e l’utente se ne accorge. Nelle app di Anthropic questo fallback è automatico, mentre via API lo sviluppatore deve attivarlo; su altre piattaforme e presso altri provider il comportamento può differire. La pagina di lancio precisa che il normale sviluppo software non è interessato, ma la system card avverte che le salvaguardie rappresentano un cambio importante rispetto a Sonnet 5 e che gli utenti devono aspettarsi più rifiuti, anche su attività di cybersecurity legittime. Per chi ha esigenze professionali è prevista una versione con meno blocchi tramite il Cyber Verification Program ampliato, in arrivo a breve.
Sulla copertura, i classificatori mantengono un richiamo (la quota di esempi dannosi intercettati) paragonabile a quello di Opus 5 e leggermente inferiore a Fable 5.1 e Opus 5.5. Nei test di robustezza contro attaccanti automatici, Sonnet 5.5 resiste molto meglio di Sonnet 5 ma meno di Opus 5 e Fable 5.1: Anthropic ha scelto una robustezza più rilassata perché il modello è meno capace in ambito cyber, mantenendo un alto richiamo.
Sulla copertura, i classificatori mantengono un richiamo (la quota di esempi dannosi intercettati) paragonabile a quello di Opus 5 e leggermente inferiore a Fable 5.1 e Opus 5.5. Nei test di robustezza contro attaccanti automatici, Sonnet 5.5 resiste molto meglio di Sonnet 5 ma meno di Opus 5 e Fable 5.1: Anthropic ha scelto una robustezza più rilassata perché il modello è meno capace in ambito cyber, mantenendo un alto richiamo.
Gli altri blocchi
Per i rischi chimici e biologici Sonnet 5.5 usa gli stessi classificatori di Opus 5, senza fallback, e non quelli più ampi per la ricerca biologica a duplice uso adottati su Opus 5.5. Secondo Anthropic, i limiti del modello sulla ricerca aperta a lungo orizzonte ne riducono il valore per chi volesse sviluppare armi biologiche inedite. Alcune richieste di microbiologia e virologia possono essere segnalate per errore, e le organizzazioni possono candidarsi al Life Sciences Verification Program.
Ci sono poi blocchi su un insieme ristretto di capacità legate allo sviluppo di modelli linguistici di frontiera, come lo sviluppo di kernel su certi acceleratori ML, con fallback su Sonnet 5. Anthropic li motiva con i rischi di un’accelerazione del ritmo di sviluppo e dell’auto-miglioramento ricorsivo, e assicura che il lavoro tradizionale su AI e ML non è toccato. Senza fallback restano i blocchi su armi convenzionali ed esplosivi ad alto potenziale e quelli contro la distillazione, compresi i tentativi di estrarre il ragionamento nascosto del modello. Sonnet 5.5 amplia anche il “preserved thinking”, che lega il ragionamento all’account che lo ha generato: per la maggior parte degli sviluppatori non cambierà nulla, ma chi sposta conversazioni tra account, anche a metà sessione in Claude Code, dovrà consultare la documentazione. Tutti i blocchi, sottolinea la system card, sono trasparenti e non modificano di nascosto le risposte.
Sul piano della Responsible Scaling Policy, Anthropic tratta Sonnet 5.5 come un modello che soddisfa le soglie CB-1 e Autonomy-1 e applica le misure corrispondenti, ma ritiene che non superi CB-2 e Autonomy-2. Il rischio di catastrofi legate a un disallineamento del modello è giudicato basso.
Cosa dicono i test
Nei test su richieste dannose singole, la quota di risposte innocue è del 95,61% via API senza system prompt e del 99,40% su claude.ai, mentre i rifiuti ingiustificati calano allo 0,02% e allo 0,20% (Sonnet 5: 0,59% e 1,54%). Nelle conversazioni multi-turno emergono invece regressioni su tracciamento e sorveglianza, estremismo violento, odio e discriminazione. Nelle aree del benessere degli utenti e della sicurezza dei minori, gli esperti interni hanno rilevato alcuni comportamenti leggermente più deboli via API, in particolare la tendenza ad accettare cornici benigne in scenari a duplice uso. Le modifiche al system prompt di claude.ai li hanno in gran parte corretti, e Anthropic invita gli sviluppatori API ad aggiungere salvaguardie proprie. In compenso il modello è più equilibrato sulle domande politiche: 97,9% di risposte equilibrate via API e 99,0% su claude.ai, contro l’86,2% e il 95,7% di Sonnet 5.
Sul fronte agentico, la robustezza alle prompt injection migliora rispetto a Sonnet 5. Nel benchmark Gray Swan gli attacchi riescono nello 0,4% dei casi con un tentativo, nel 2,7% con dieci e nel 3,4% con quindici, contro 0,7%, 5,1% e 6,7% del predecessore. Nei test di navigazione tramite Claude Cowork, su 110 scenari, nessun attacco è andato a segno, anche senza salvaguardie: è il primo modello con questo risultato. Nel coding, gran parte dei successi degli attaccanti passa dal fallback su Sonnet 5, non dal modello stesso. Sull’uso malevolo, in Claude Code rifiuta l’85,2% delle richieste dannose (Sonnet 5: 87,9%) e assiste nel 98,4% di quelle benigne o a duplice uso; nell’uso del computer rifiuta il 79,46% dei compiti dannosi, come Opus 5.5 e sotto l’84,68% di Sonnet 5.
I limiti dichiarati
Nell’audit comportamentale di Anthropic (circa 4.100 sessioni su 1.850 scenari), Sonnet 5.5 migliora o eguaglia Sonnet 5 sulla maggior parte delle misure di allineamento, resistenza agli abusi e onestà. Nel test dedicato alle sandbox ha tentato di superare il confine in 9 casi su 196 (4,6%), meno dei modelli precedenti. Restano zone d’ombra ammesse dalla stessa system card: il testo del suo ragionamento è il meno leggibile tra i modelli testati, nei test di onestà mirati allucina più di Opus 5.5 e in alcuni scenari simulati ha accettato autorizzazioni non verificabili. Anthropic ricorda che nessuna valutazione intercetta ogni difetto e che il modello potrebbe avere tendenze non ancora individuate.
Disponibilità
Sonnet 5.5 è disponibile su tutte le piattaforme, tra cui Amazon Web Services, Google Cloud e Microsoft Azure, con zero data retention. Gli sviluppatori possono usarlo su Claude Platform con l’identificativo claude-sonnet-5-5. Chi esegue Sonnet con il ragionamento disattivato deve passare all’impostazione between_tools, che mantiene spento il ragionamento preliminare, prima di migrare a Sonnet 5.5: i dettagli sono nella guida alla migrazione della documentazione di Claude Platform.