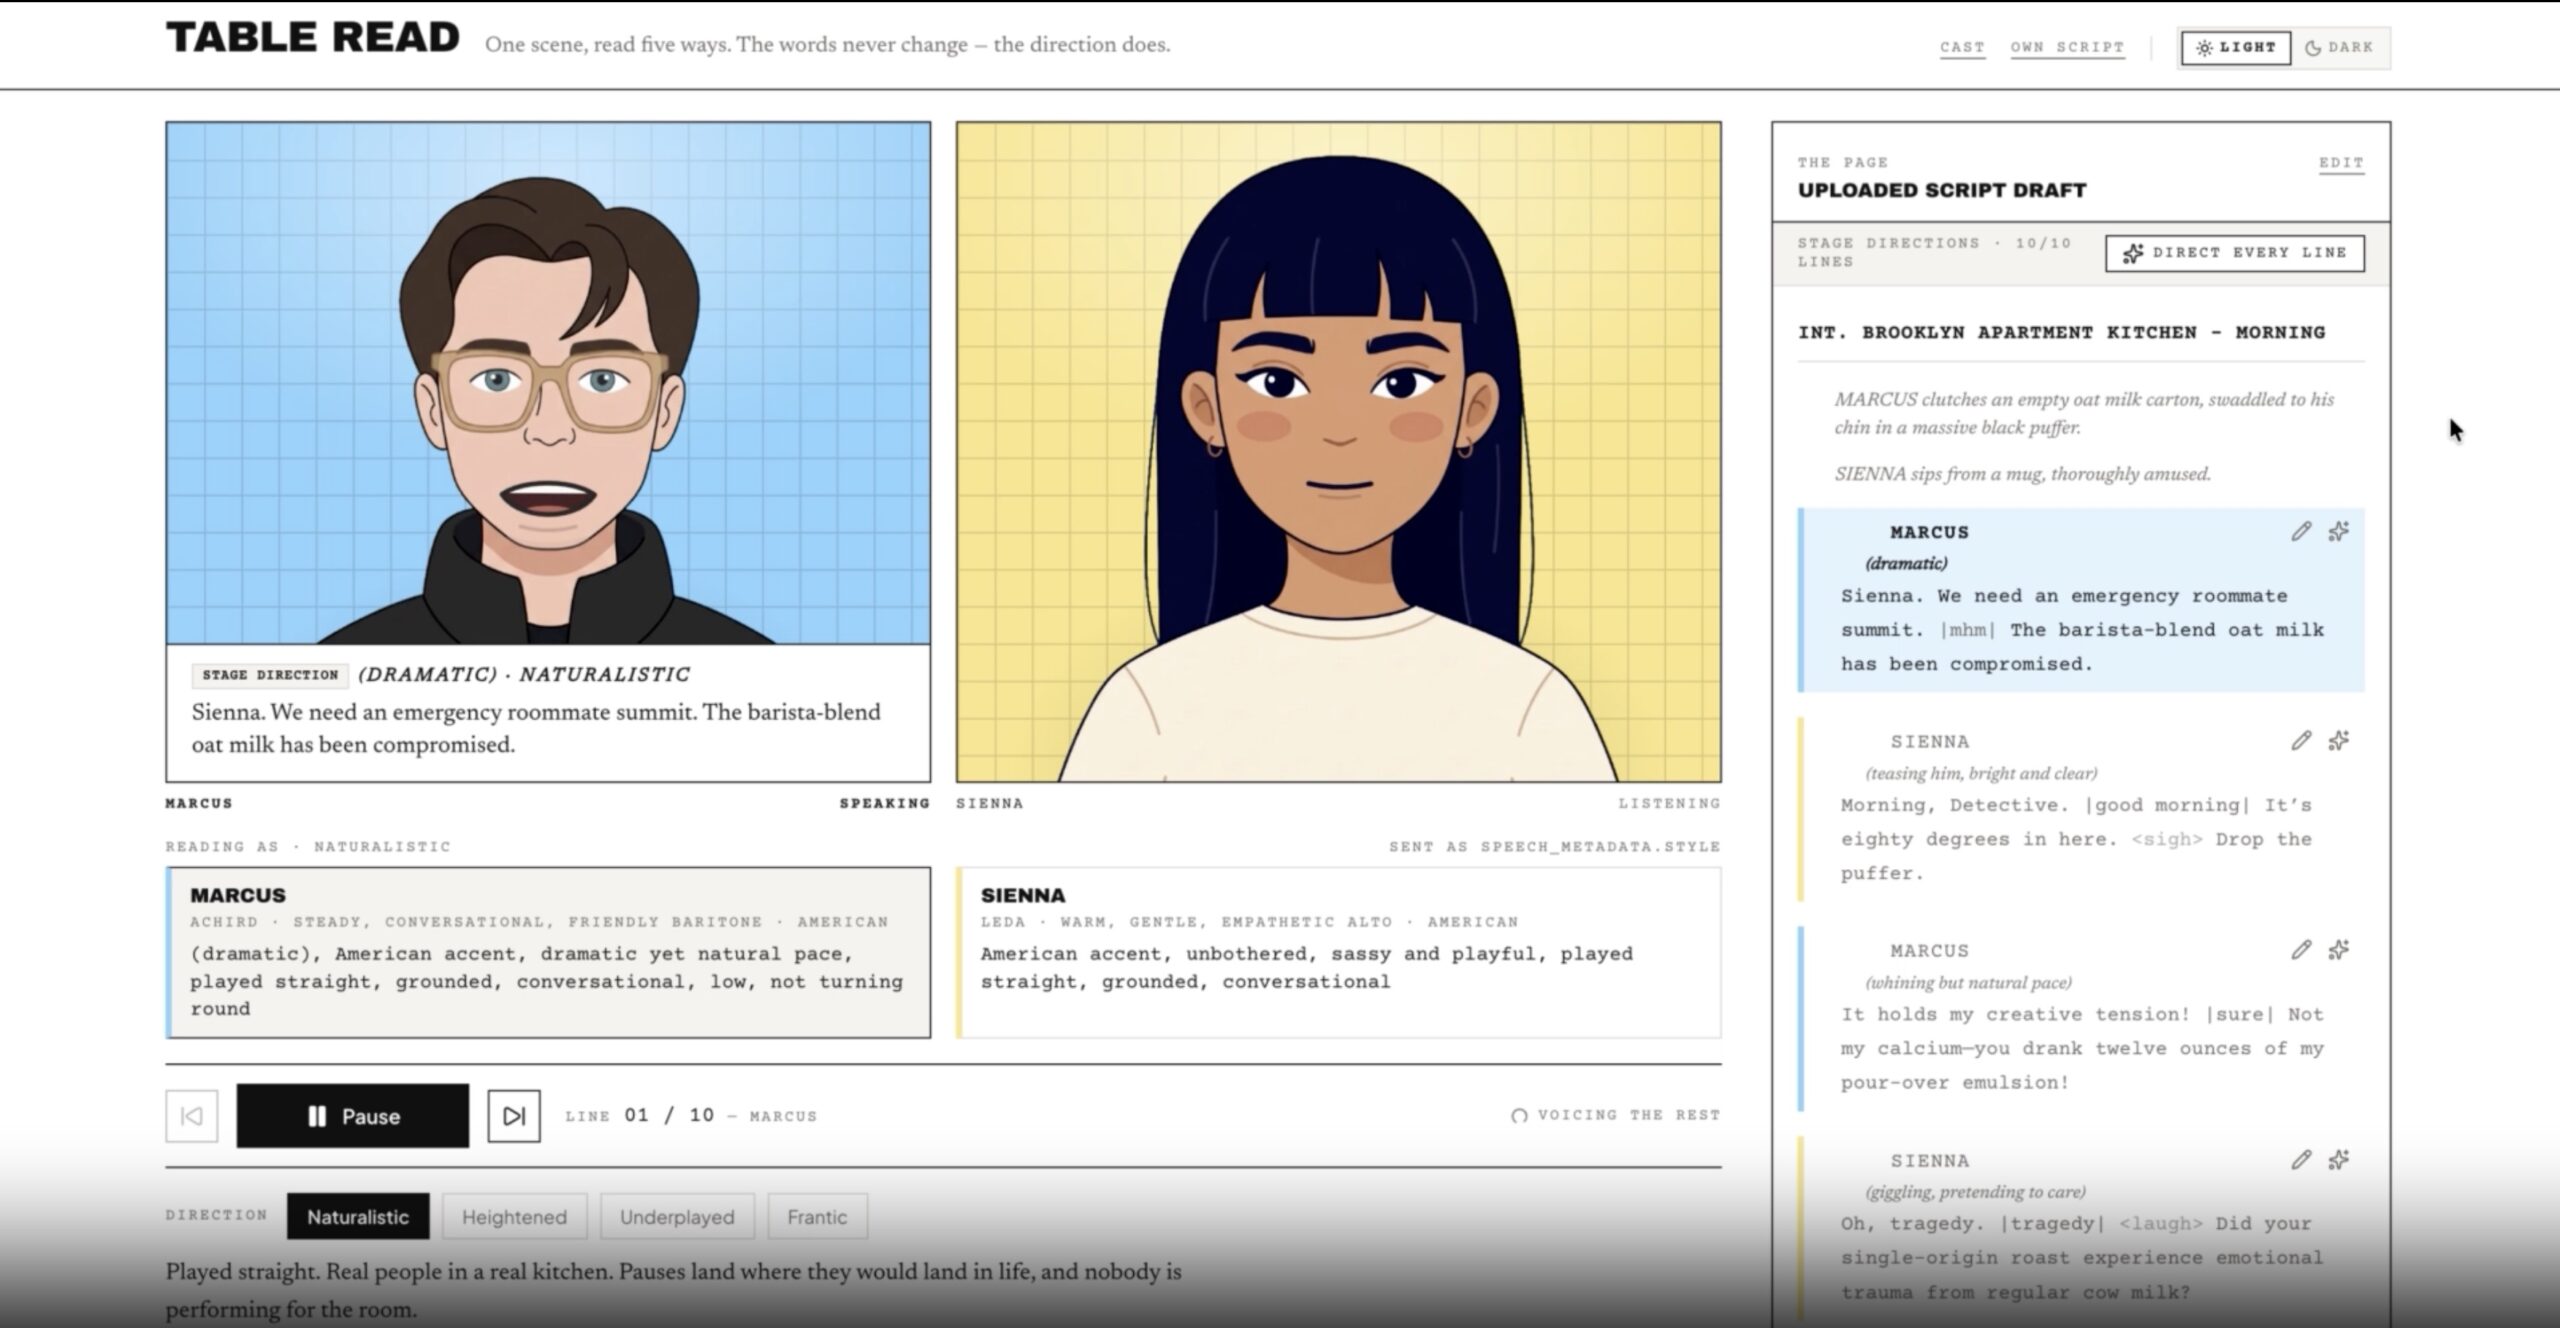
Da una descrizione in linguaggio naturale a una voce originale, riutilizzabile e coerente anche nelle produzioni di lunga durata. È la novità principale dei nuovi Gemini 3.8 Flash TTS e Gemini 3.8 Flash-Lite TTS, i due modelli text-to-speech con cui Google estende la generazione audio verso podcast, audiolibri, doppiaggio, contenuti interattivi e agenti vocali.
La famiglia si articola in due proposte. Gemini 3.8 Flash TTS privilegia la qualità della resa, la direzione creativa e la costruzione dei personaggi; Gemini 3.8 Flash-Lite TTS è ottimizzato per latenza, volumi elevati ed efficienza economica. I due modelli condividono lo stesso schema API e la medesima impostazione dei prompt, ma si rivolgono a carichi differenti: Flash è indicato per narrazioni complesse, dialoghi interpretati e pronunce difficili, mentre Flash-Lite è destinato soprattutto a lettura automatica, doppiaggio su larga scala e pipeline di agenti vocali.
Dalla libreria di voci al voice design
Con il Generative Voice Design, lo sviluppatore può descrivere ruolo, età percepita, timbro, accento e stile di una voce, senza limitarsi ai profili vocali predefiniti. L’API restituisce un identificatore persistente voice_…, utilizzabile nelle successive richieste di sintesi per conservare l’identità vocale tra episodi, sessioni o contenuti diversi. La funzione è disponibile per entrambe le varianti 3.8 e si affianca a una libreria di oltre 2.000 voci pronte per la produzione.
Il Voice Remixing, previsto prossimamente, permetterà di partire da una voce della libreria e modificarne timbro, altezza, ritmo e accento attraverso istruzioni testuali, per esempio attenuando l’interpretazione o aggiungendo una specifica inflessione regionale.
La copertura linguistica dichiarata arriva a 130 lingue per Flash TTS e a 101 per Flash-Lite TTS, italiano compreso. Google sottolinea anche il supporto per varianti regionali e dialetti; Flash consente inoltre di indicare pronunce con l’alfabeto fonetico internazionale, una funzione utile per nomi propri, terminologia tecnica e localizzazioni in cui la pronuncia deve restare stabile.
Accanto alla progettazione da prompt compare la replica vocale da un campione di 30 secondi. Il sistema richiede una registrazione di consenso della persona a cui appartiene la voce, verificata rispetto al campione di riferimento. Ogni clip prodotta dai modelli Gemini Audio incorpora inoltre il watermark impercettibile SynthID e Google dichiara l’impiego di credenziali C2PA per rendere riconoscibile la provenienza del contenuto.
La replica della voce attraverso Google AI Studio non è disponibile nello Spazio economico europeo, nel Regno Unito e in Svizzera, oltre che in Illinois, Texas e India. Il voice design da descrizione e le altre funzioni di sintesi restano distinti dalla replica basata su una registrazione reale.
Regia riga per riga e dialoghi a due voci
I modelli trattano il testo come una trascrizione da pronunciare fedelmente, mentre le istruzioni durevoli su stile e interprete passano nei metadati strutturati speech_metadata. In questo modo tono, ritmo, accento e ruolo del parlante non vengono confusi con le parole da leggere. Nel testo restano invece gli eventi puntuali, come <laugh>, <sigh> e <short pause>, insieme alle interiezioni di ascolto che rendono più naturale uno scambio.
La messa in scena nativa a due interlocutori permette di fornire un unico copione e assegnare una voce a ciascun turno, mantenendo distinti timbro e alternanza della conversazione. Google dichiara inoltre una maggiore stabilità nelle produzioni lunghe, con minore deriva della voce, del volume e dell’ambiente acustico. Il campo d’impiego comprende audiolibri, podcast narrativi e doppiaggio, ma anche risposte predefinite di assistenti vocali che richiedono la recitazione esatta del testo.
Flash TTS ha ottenuto 71,4 punti e il primo posto complessivo nel Voice Design Benchmark di Hume AI, oltre a 60,8 punti nella modellazione degli accenti. Flash e Flash-Lite occupano rispettivamente la prima e la seconda posizione nell’Overall Quality Index dello stesso benchmark. Nelle valutazioni umane in cieco di Voice Arena, i due modelli raggiungono le posizioni più alte in lingue che comprendono giapponese, portoghese brasiliano, vietnamita, arabo standard moderno, spagnolo messicano e hindi.
Il TTS recita un copione con controllo fine, mentre la Live API gestisce conversazioni audio interattive e input multimodali in tempo reale. Sul versante opposto della pipeline, Gemini 3.5 Transcribe converte il parlato in testo già ripulito e strutturato, con diarizzazione, timestamp e vocabolario personalizzato. I due servizi coprono così fasi complementari di un flusso: trascrizione e organizzazione dell’audio in ingresso, generazione della voce in uscita.
API, formati e migrazione dal modello 3.1
Gemini 3.8 Flash TTS accetta testo e produce esclusivamente audio, con un limite di 8.192 token in ingresso e 16.384 token in uscita. Supporta elaborazione standard, Batch API, Flex e Priority. Flash-Lite adotta lo stesso schema ed è indicato da Google come sostituto del precedente gemini-3.1-flash-tts-preview nei carichi produttivi ad alto volume.
Per chi migra dalla generazione 3.1 cambia anche il formato predefinito delle richieste non in streaming: il risultato è ora un file WAV con intestazione RIFF, pronto per essere salvato, anziché audio PCM grezzo da racchiudere manualmente in un contenitore. Restano selezionabili i formati senza intestazione audio/l16, mu-law e A-law quando richiesti da una pipeline telefonica o da un sistema preesistente.
Quanto costa Gemini 3.8 TTS
Fino al 31 dicembre 2026, Gemini 3.8 Flash TTS e Flash-Lite TTS costano 0,50 dollari per milione di token testuali in ingresso nel livello standard. L’uscita audio è quotata 9 dollari per milione di token con Flash e 6 dollari con Flash-Lite. Il livello gratuito comprende input e output senza addebito, entro i limiti previsti dal servizio.
Google calcola 25 token per secondo di audio: un milione di token corrisponde quindi a circa 666,7 minuti. Il costo della sola uscita equivale a circa 0,0135 dollari al minuto per Flash e 0,009 dollari al minuto per Flash-Lite, ai quali si aggiunge il consumo del testo in ingresso.
Batch e Flex dimezzano fino alla fine del 2026 le tariffe: 0,25 dollari per milione di token testuali, con audio in uscita a 4,50 dollari per Flash e 3 dollari per Flash-Lite. Il costo indicativo scende così a circa 0,00675 e 0,0045 dollari al minuto. Priority aumenta invece l’input a 0,90 dollari e l’output a 16,20 dollari per Flash e 10,80 dollari per Flash-Lite. Sono previsti anche addebiti per il caching e la conservazione della cache.
Dal 1° gennaio 2027 il listino raddoppia: nel livello standard l’ingresso passa a 1 dollaro per milione di token, mentre l’uscita sale a 18 dollari per Flash e 12 dollari per Flash-Lite, pari rispettivamente a circa 0,027 e 0,018 dollari al minuto. Lo stesso raddoppio interessa Batch, Flex, Priority e caching.
Entrambi i modelli sono generalmente disponibili nella Gemini API e accessibili in Google AI Studio. Flash TTS viene utilizzato anche in Gemini Notebook, mentre Flash-Lite TTS arriva in Google Vids; per le imprese, l’accesso API tramite Gemini Enterprise è indicato come disponibile prossimamente. Google segnala inoltre il supporto delle piattaforme Agora, LiveKit, Pipecat e Vercel per costruire servizi di sintesi vocale basati sulla Gemini API.