NVIDIA domina il mercato degli acceleratori per l’intelligenza artificiale grazie a un vantaggio competitivo che va ben oltre le prestazioni dei suoi processori. L’azienda controlla infatti anche CUDA, la piattaforma software sulla quale si è sviluppato un vastissimo ecosistema di librerie, strumenti e applicazioni per il calcolo accelerato. Per i concorrenti, proporre chip alternativi significa quindi affrontare due sfide contemporaneamente: offrire hardware competitivo e permettere agli sviluppatori di utilizzarlo senza dover riscrivere il software.
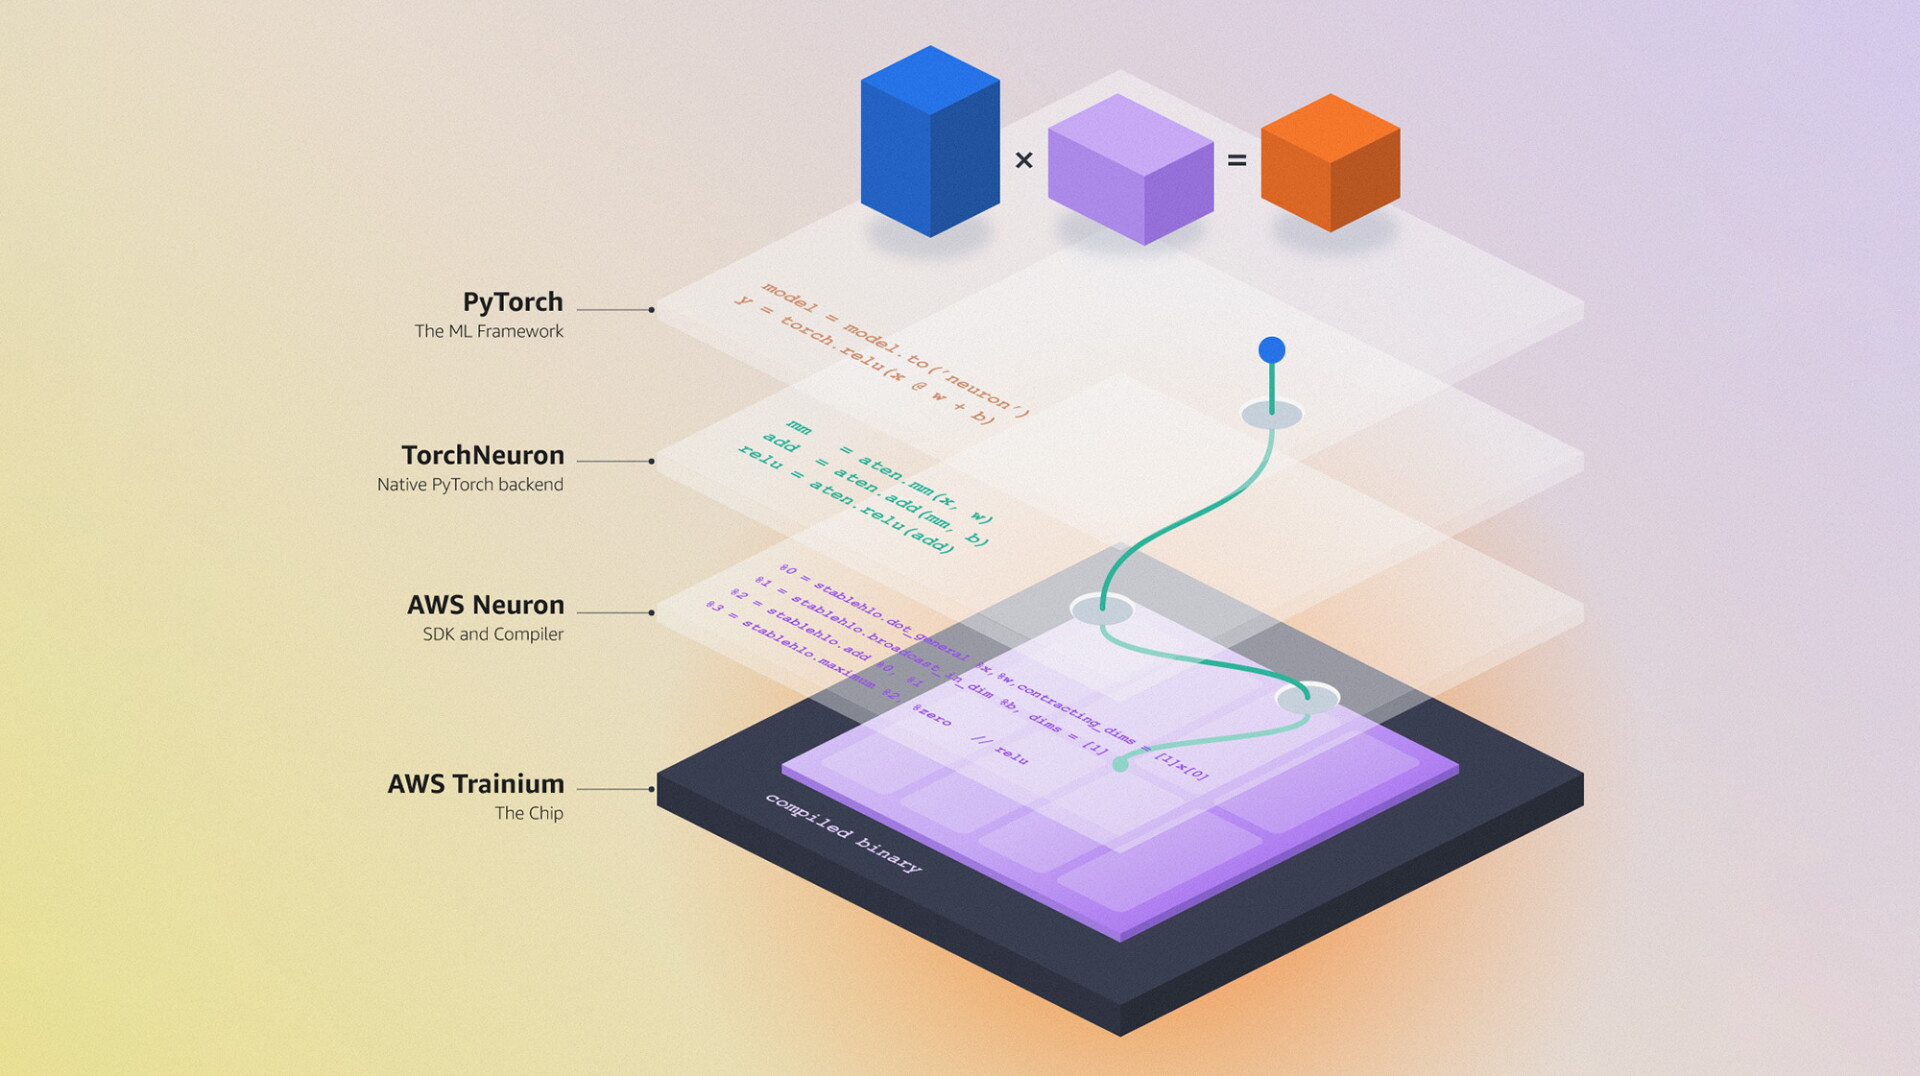
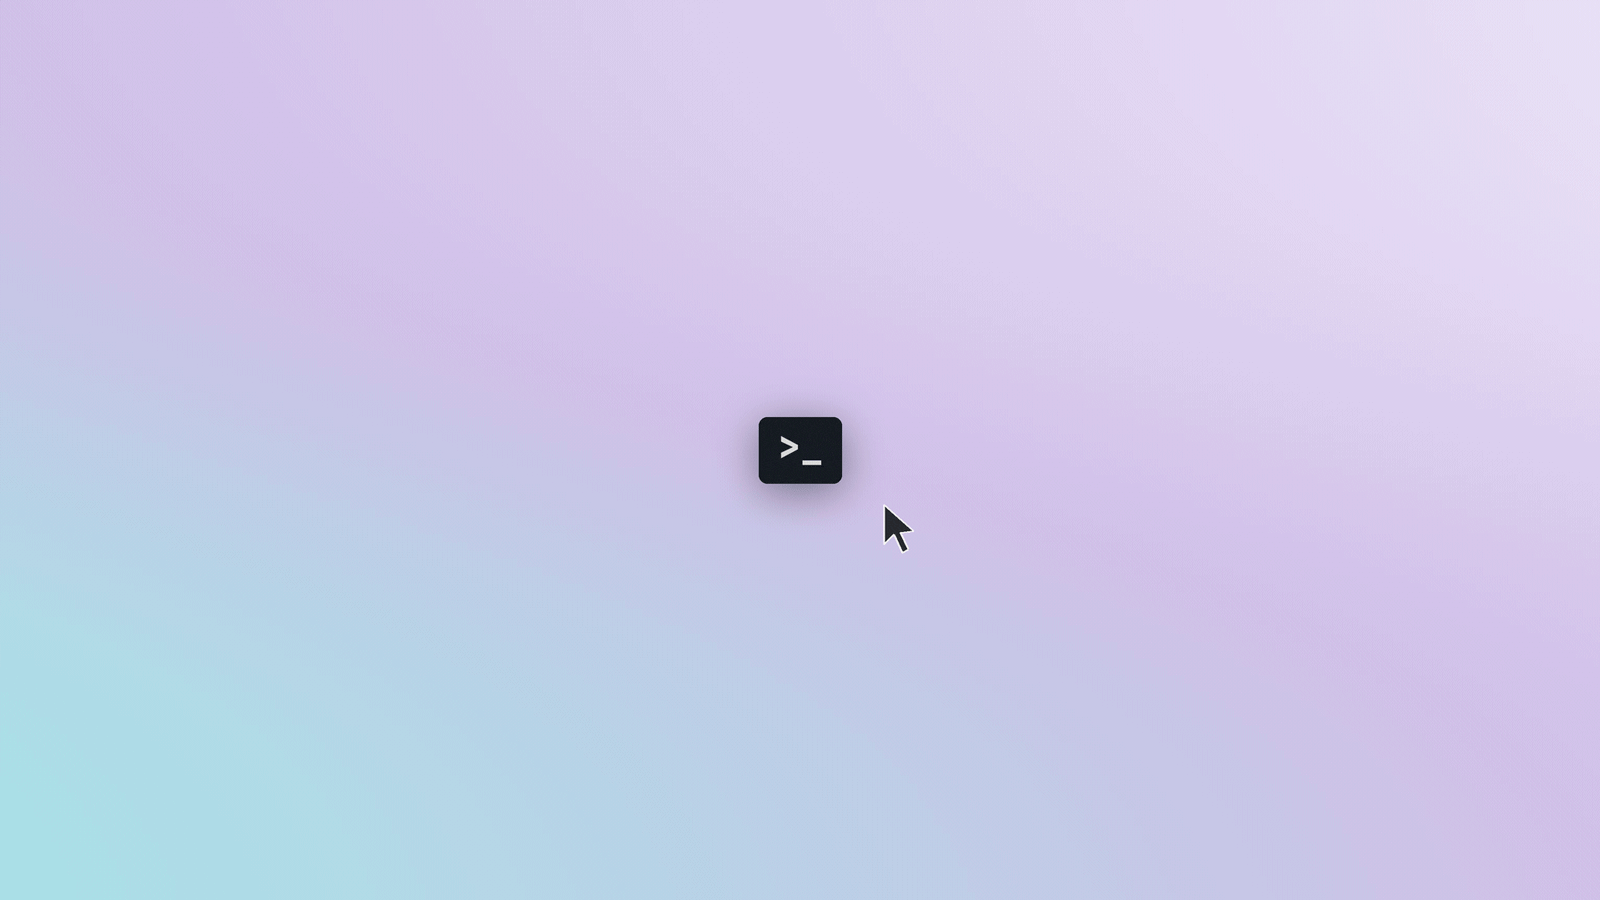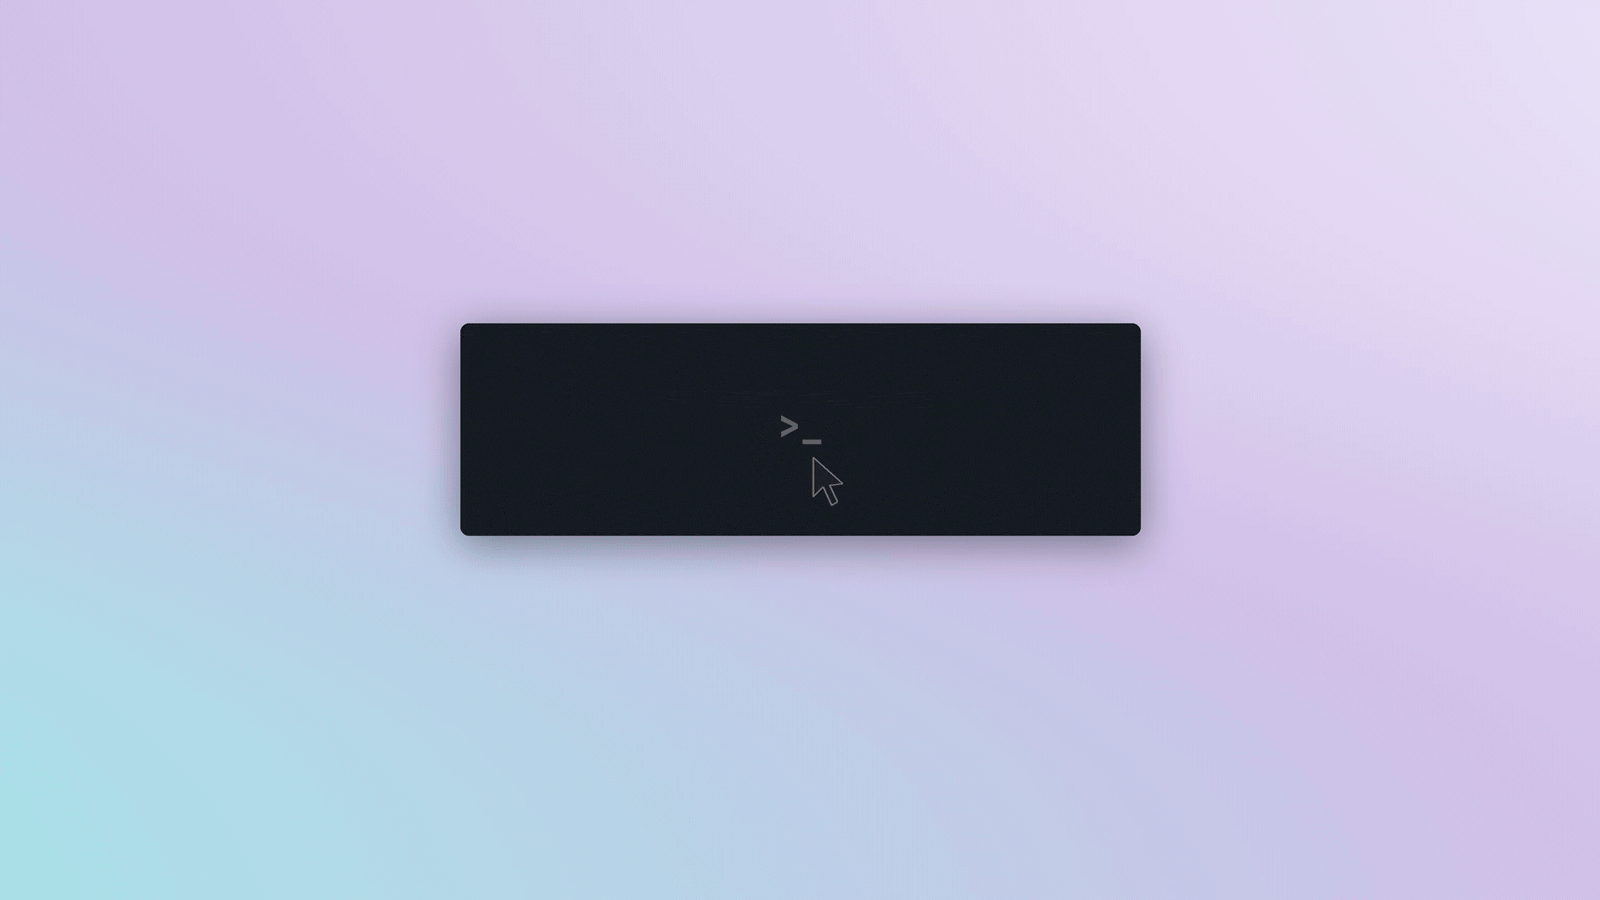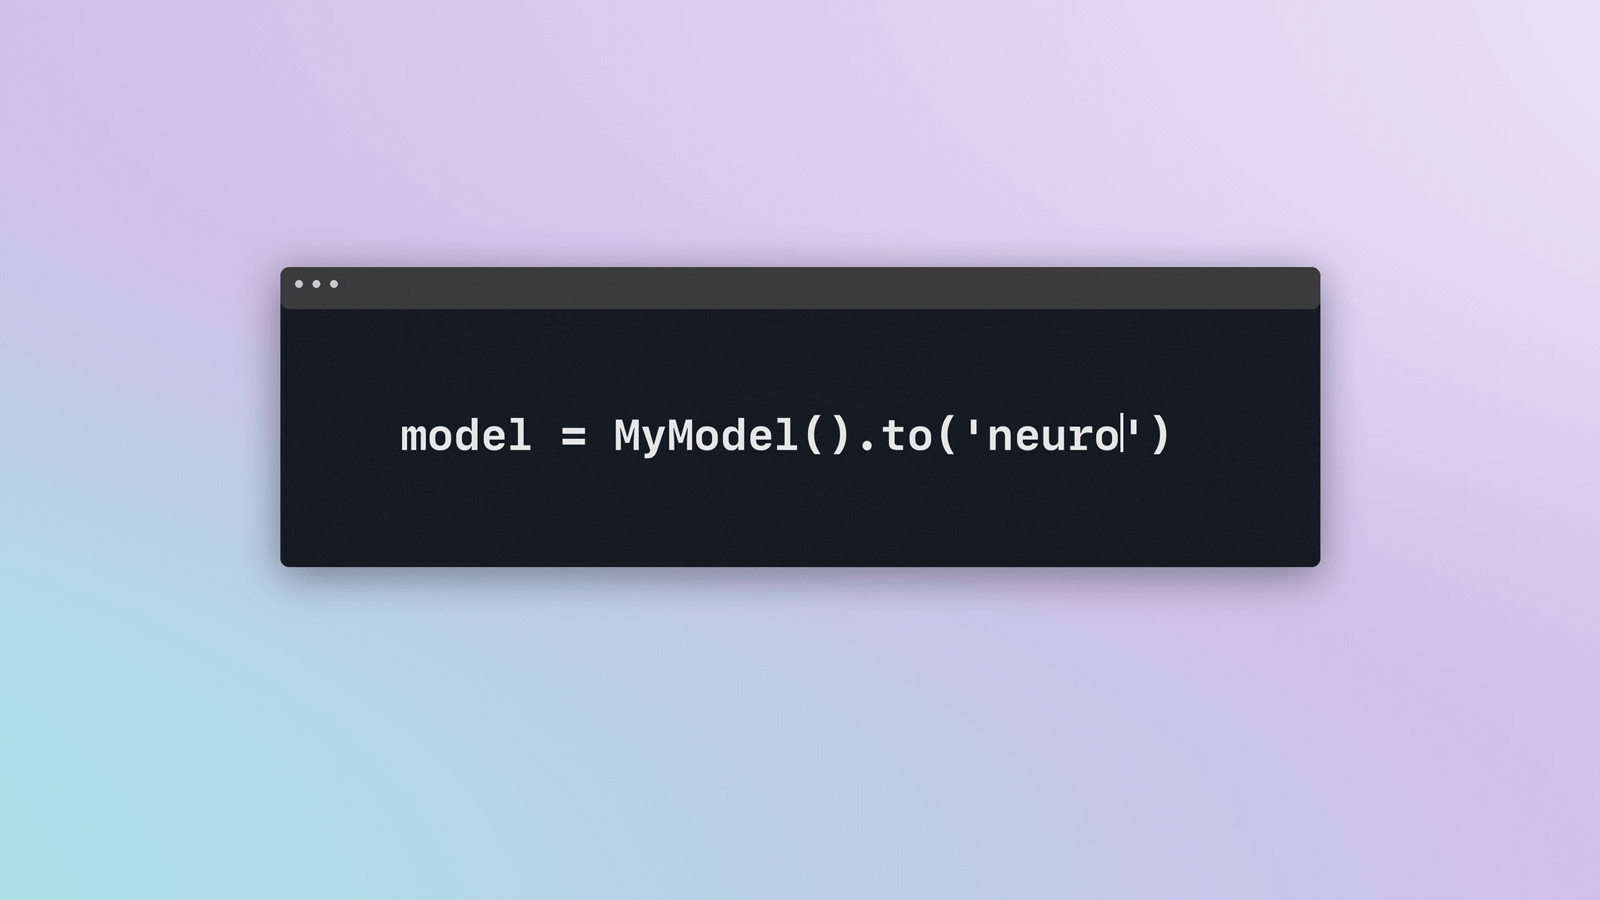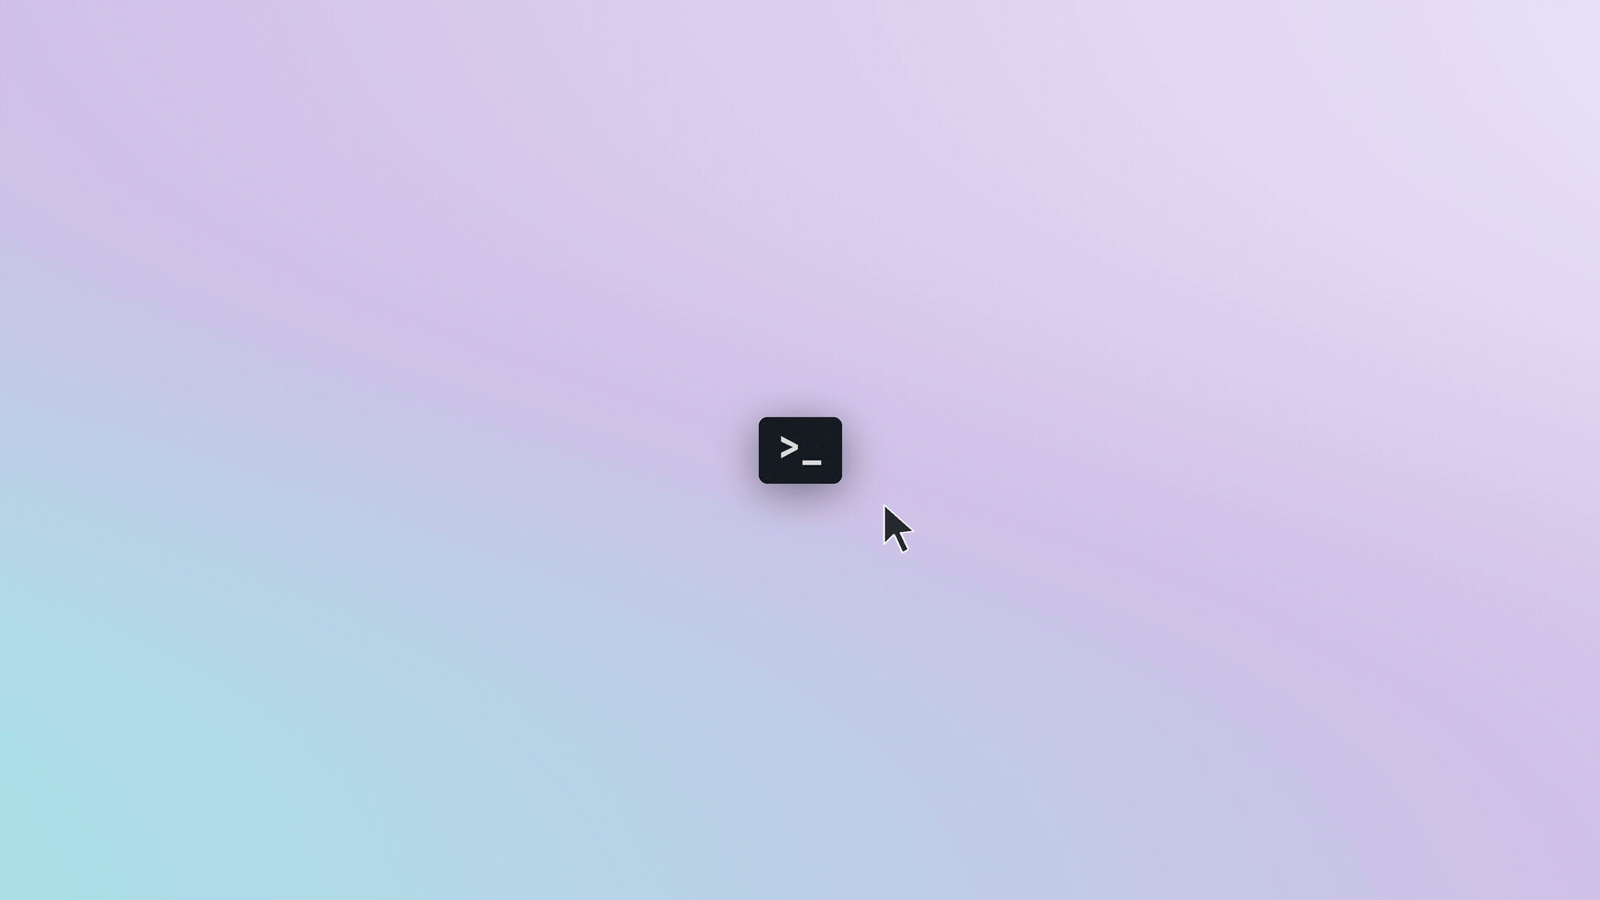
Amazon Web Services affronta questa seconda difficoltà con TorchNeuron, un backend che permette di eseguire il codice PyTorch esistente sui processori AWS Trainium, modificando soltanto la configurazione del dispositivo di calcolo.
TorchNeuron sarà distribuito come software open source con licenza Apache 2.0 il 20 ottobre, in occasione della PyTorch Conference North America. La tecnologia supporta gli acceleratori Trainium2 e Trainium3 e si inserisce nella strategia con cui Amazon intende ampliare l’utilizzo dei propri chip, riducendo una delle principali barriere alla loro adozione.
Il vantaggio di NVIDIA comincia dal software
Il successo di NVIDIA nell’intelligenza artificiale è strettamente legato a CUDA, la piattaforma di programmazione parallela introdotta nel 2006, che permette di utilizzare le GPU per attività di calcolo generale.
Nel corso degli anni, NVIDIA ha costruito attorno a CUDA un ecosistema che comprende compilatori, strumenti di sviluppo e librerie ottimizzate, fra cui cuDNN per il deep learning, cuBLAS per l’algebra lineare, NCCL per la comunicazione tra GPU e TensorRT per l’ottimizzazione dell’inferenza.
Queste componenti intervengono in numerose operazioni fondamentali per l’addestramento e l’esecuzione dei modelli AI, e il loro impiego permette agli sviluppatori di sfruttare le prestazioni delle GPU NVIDIA senza dover programmare direttamente ogni operazione a basso livello.
La disponibilità di strumenti consolidati, documentazione, competenze professionali e software già ottimizzato rende l’ecosistema CUDA particolarmente difficile da sostituire. Anche quando un acceleratore concorrente offre prestazioni interessanti o costi inferiori, la migrazione può richiedere interventi significativi sul codice e una nuova fase di verifica e ottimizzazione.
Il vantaggio competitivo di NVIDIA deriva quindi dalla combinazione tra hardware e software: le prestazioni dei processori favoriscono l’adozione di CUDA, mentre la diffusione delle librerie e delle competenze CUDA rende più conveniente continuare a utilizzare hardware NVIDIA.
Questa dipendenza tecnologica costituisce un ostacolo per AMD, Intel e per i grandi operatori cloud che sviluppano acceleratori proprietari, fra cui Amazon e Google.
TorchNeuron permette di utilizzare PyTorch sui chip Trainium
Amazon ha scelto di intervenire direttamente sull’integrazione con PyTorch, uno dei framework più utilizzati per lo sviluppo di modelli di intelligenza artificiale.
Nato in Meta e successivamente affidato alla PyTorch Foundation, nell’ambito della Linux Foundation, PyTorch è un progetto open source indipendente dai produttori di hardware. La sua diffusione è tuttavia storicamente legata alle GPU NVIDIA, sulle quali può utilizzare CUDA e le relative librerie di accelerazione.
Secondo i dati riportati da Amazon, l’85% dei ricercatori e degli sviluppatori AI utilizza PyTorch. Una percentuale che evidenzia l’importanza strategica della compatibilità con il framework, anche se Amazon non precisa la metodologia utilizzata per determinarla.
Con TorchNeuron, AWS permette al codice PyTorch di utilizzare Trainium attraverso il meccanismo standard con cui il framework riconosce e gestisce differenti dispositivi di calcolo.
Gli sviluppatori possono così conservare gran parte del codice esistente, delle procedure di addestramento e degli strumenti di debugging, intervenendo sulla configurazione che identifica l’acceleratore utilizzato.
In una dimostrazione comparativa, gli ingegneri Amazon hanno eseguito lo stesso script di addestramento su hardware differente, modificando soltanto la configurazione del dispositivo. Secondo AWS, i risultati hanno mostrato un andamento dell’apprendimento equivalente.
La compatibilità del codice PyTorch non equivale tuttavia alla compatibilità con CUDA. Le applicazioni che utilizzano direttamente librerie NVIDIA, kernel CUDA personalizzati o altre funzionalità specifiche della piattaforma possono richiedere adattamenti.
TorchNeuron riduce quindi la dipendenza dall’hardware NVIDIA per le applicazioni sviluppate attraverso le interfacce standard di PyTorch, mentre la portabilità delle componenti più specializzate rimane legata alle rispettive implementazioni.
Dal compilatore Neuron all’esecuzione nativa di PyTorch
TorchNeuron rappresenta un’evoluzione dell’AWS Neuron SDK, l’ambiente software sviluppato da Amazon per programmare e ottimizzare i propri acceleratori Trainium e Inferentia.
Le precedenti integrazioni con PyTorch utilizzavano principalmente un’architettura basata su XLA, che trasformava le operazioni del framework in grafi computazionali successivamente compilati per l’hardware AWS.
Il nuovo backend utilizza invece il meccanismo nativo di estensione dei dispositivi di PyTorch, identificato come PrivateUse1, e supporta sia l’esecuzione immediata delle operazioni, attraverso la modalità eager, sia la compilazione e l’ottimizzazione del codice mediante torch.compile.
La modalità eager consente di eseguire le operazioni durante lo sviluppo, facilitando sperimentazione e debugging, mentre la compilazione permette di ottimizzare l’esecuzione dei modelli per le caratteristiche dell’acceleratore.
L’integrazione nativa di PyTorch era stata introdotta in beta privata nel dicembre 2025, con Neuron SDK 2.27.0. L’annuncio del 19 ottobre 2026 segna il passaggio alla distribuzione open source di TorchNeuron.
Per l’addestramento distribuito, il backend supporta le API standard di PyTorch e si integra con TorchTitan, il framework dedicato all’addestramento di modelli di grandi dimensioni.
Tra le funzionalità disponibili figura Fully Sharded Data Parallelism (FSDP), che distribuisce parametri, gradienti e stati dell’ottimizzatore su più acceleratori, riducendo la memoria richiesta a ciascun dispositivo.
Gli sviluppatori che necessitano di ottimizzazioni specifiche possono inoltre utilizzare la Neuron Kernel Interface (NKI) per realizzare kernel personalizzati e sfruttare più direttamente le caratteristiche dei processori Trainium.
Questa possibilità rimane importante perché la portabilità del codice di alto livello, pur semplificando l’utilizzo di hardware differenti, non garantisce automaticamente le stesse prestazioni.
AWS interviene anche sull’ecosistema open source
Amazon sta contribuendo direttamente allo sviluppo di PyTorch per ridurre le dipendenze del framework da specifiche architetture hardware.
L’attività comprende modifiche al codice principale di PyTorch e la collaborazione con altri progetti open source utilizzati nello sviluppo e nell’esecuzione dei modelli AI.
Hugging Face ha introdotto il supporto nativo a Trainium nei propri strumenti, consentendo agli sviluppatori di utilizzare gli acceleratori AWS senza ricorrere necessariamente a codice specifico di Amazon.
AWS ha inoltre contribuito a vLLM, il framework open source dedicato all’inferenza dei modelli linguistici, rendendo disponibili anche kernel ottimizzati che possono essere utilizzati come riferimento per ulteriori sviluppi.
Amazon dichiara di verificare TorchNeuron a ogni compilazione attraverso test che coinvolgono centinaia di migliaia di modelli AI, per individuare eventuali problemi di compatibilità prima dell’utilizzo nei carichi di lavoro dei clienti.
L’investimento nell’ecosistema open source risponde a una precisa esigenza competitiva. Per rendere Trainium un’alternativa credibile alle GPU NVIDIA, Amazon deve assicurare che gli strumenti utilizzati quotidianamente dagli sviluppatori funzionino anche sui propri acceleratori.
La compatibilità con PyTorch, Hugging Face e vLLM consente di affrontare questo problema attraverso progetti condivisi, evitando di costruire un ambiente di sviluppo completamente separato.
Le prime applicazioni di TorchNeuron
Tra le organizzazioni che stanno utilizzando TorchNeuron figura Cartesia, specializzata in modelli AI per applicazioni vocali e interazione in tempo reale.
L’azienda ha eseguito su Trainium la propria pipeline di inferenza attraverso il supporto nativo a PyTorch, apportando modifiche limitate al codice.
Un altro utilizzatore è il Lieber Institute for Brain Development, istituto di ricerca biomedica che studia, fra le altre attività, nuove terapie per patologie neuropsichiatriche.
L’organizzazione utilizza modelli biologici, chimici e linguistici nelle attività di identificazione dei bersagli terapeutici e scoperta di farmaci. TorchNeuron permette ai ricercatori di sperimentare l’utilizzo di Trainium anche per applicazioni computazionalmente impegnative, comprese quelle legate alla dinamica molecolare.
Amazon indica inoltre possibili applicazioni nella robotica, nei sistemi di guida autonoma, nell’elaborazione video, nei world model e nei servizi finanziari.
I primi casi documentano la compatibilità del software con gli acceleratori AWS, mentre l’effettiva convenienza economica dipenderà dalle prestazioni ottenute nei diversi carichi di lavoro, dal livello di ottimizzazione e dai costi delle risorse cloud.
La competizione con NVIDIA si sposta sulla portabilità del software
Per Amazon, TorchNeuron si aggiunge agli investimenti nello sviluppo di processori proprietari avviati con l’acquisizione di Annapurna Labs nel 2015.
Con Trainium2 e Trainium3, AWS dispone di acceleratori progettati specificamente per l’addestramento e l’inferenza dei modelli AI, che propone attraverso la propria infrastruttura cloud.
La possibilità di utilizzare gli stessi strumenti PyTorch su differenti acceleratori può ridurre i costi di migrazione e consentire alle aziende di scegliere l’hardware in funzione delle prestazioni, della disponibilità e dei costi dei singoli carichi di lavoro.
È un cambiamento potenzialmente rilevante anche per gli operatori che sviluppano applicazioni AI su infrastrutture eterogenee, combinando GPU NVIDIA, acceleratori alternativi e processori progettati dai fornitori cloud.
La portabilità diventa particolarmente importante quando una stessa organizzazione utilizza modelli differenti, con requisiti computazionali che variano tra addestramento, fine-tuning e inferenza.
Per NVIDIA, la crescente disponibilità di backend alternativi rappresenta una sfida al vantaggio costruito attraverso CUDA. L’azienda conserva infatti una posizione dominante non soltanto grazie ai propri chip, ma anche perché gran parte dell’industria dell’intelligenza artificiale ha sviluppato competenze, strumenti e ottimizzazioni attorno alla sua piattaforma software.
La diffusione di PyTorch su architetture differenti potrebbe attenuare questa dipendenza, soprattutto per i carichi di lavoro che utilizzano API standard e non richiedono kernel specifici.
Rimane però una differenza sostanziale tra eseguire un modello su hardware alternativo e ottenere prestazioni competitive su larga scala. Compilatori, librerie di comunicazione, gestione della memoria e kernel ottimizzati continuano a influenzare l’efficienza complessiva dei sistemi AI.
Con TorchNeuron, Amazon interviene su uno degli elementi che hanno finora favorito NVIDIA: il costo tecnico del cambiamento. La competizione tra acceleratori potrà così dipendere in misura crescente dalle prestazioni e dal costo effettivo di addestramento e inferenza, anziché dalla necessità di preservare gli investimenti software già effettuati.