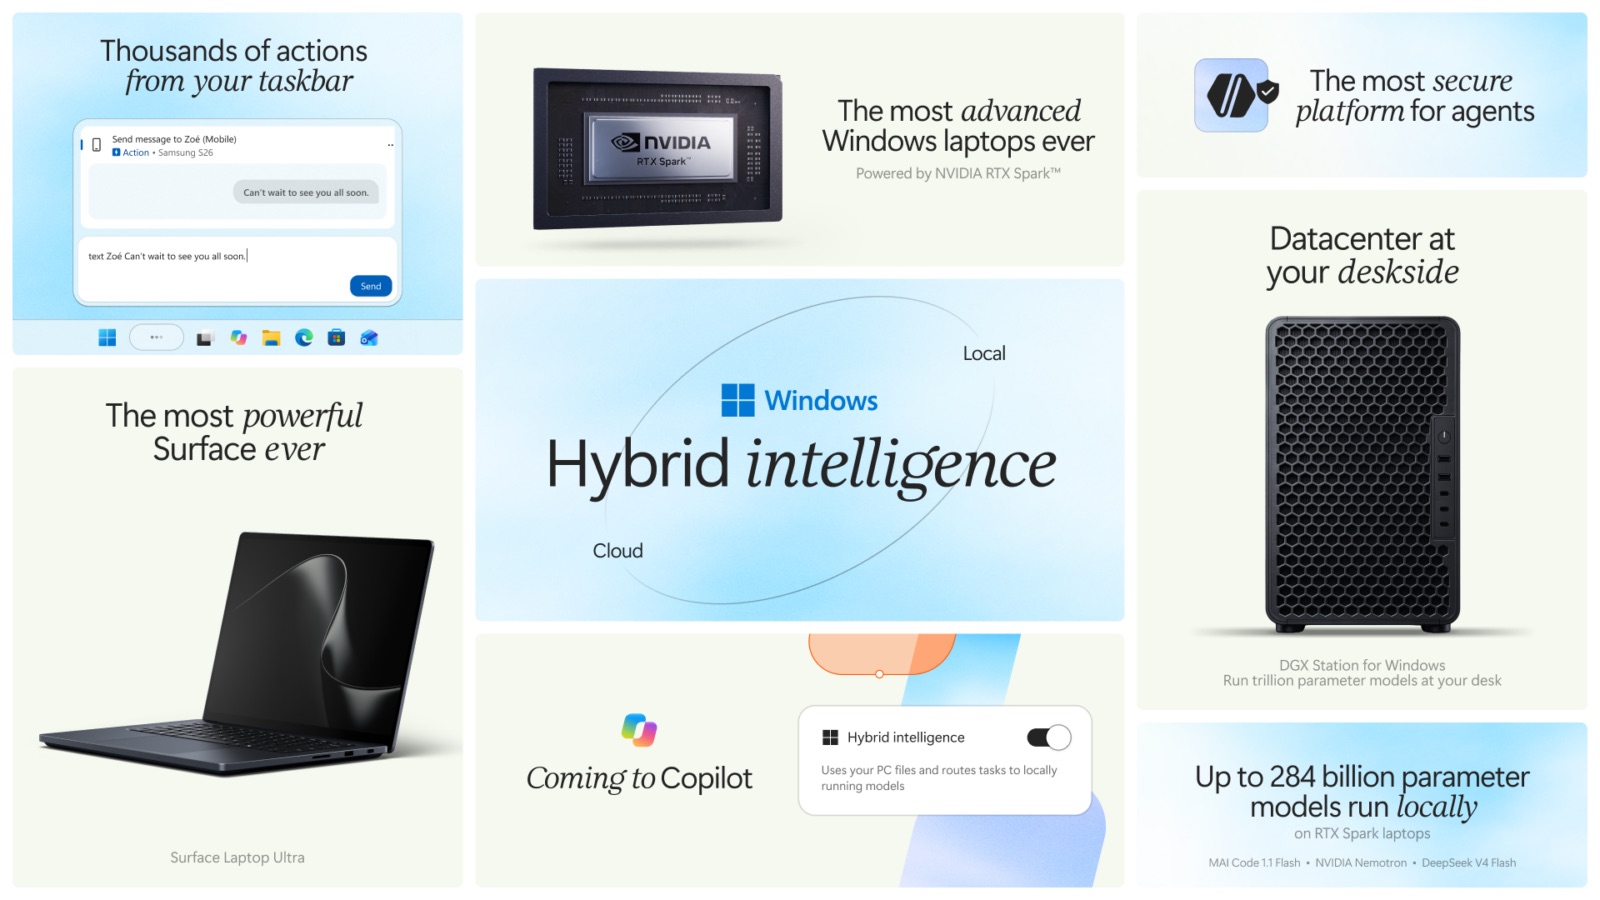
Microsoft sta trasformando Windows in una piattaforma per l’intelligenza artificiale ibrida, nella quale agenti autonomi, modelli eseguiti localmente e servizi cloud possono operare all’interno dello stesso ambiente, utilizzando le risorse di calcolo più appropriate per ciascuna attività. La strategia, denominata Hybrid Intelligence, interessa l’architettura del sistema operativo, con nuovi meccanismi di isolamento per gli agenti, strumenti di orchestrazione dell’inferenza e funzionalità che consentiranno a Copilot di utilizzare il contesto locale del PC.
L’annuncio Microsoft di ieri, presentato da Pavan Davuluri, Executive Vice President Windows + Devices, comprende Microsoft Execution Containers (MXC), ora generalmente disponibile, l’integrazione dei modelli locali in Windows ML, l’estensione di GitHub HydraFusion e nuove capacità operative per Copilot.
La distinzione tra elaborazione locale e remota assume un’importanza crescente con la diffusione degli agenti AI, che possono eseguire comandi, modificare file, utilizzare applicazioni e interagire con servizi esterni, anche attraverso attività prolungate che non richiedono una supervisione continua. Windows deve quindi gestire questi processi distinguendone identità, autorizzazioni e attività, oltre a distribuire i carichi di lavoro tra processore, GPU, NPU e infrastrutture cloud.
L’architettura coinvolge sia i dispositivi utilizzati quotidianamente sia i sistemi destinati all’esecuzione continuativa degli agenti, dai mini PC alle workstation per l’inferenza locale. Microsoft affianca alle nuove funzionalità software una generazione di computer basati su NVIDIA RTX Spark, tra cui Surface Laptop Ultra e Surface RTX Spark Dev Box, ai quali si aggiungeranno sistemi DGX Station per Windows.
Microsoft Execution Containers isola gli agenti AI dal resto del sistema
Microsoft Execution Containers (MXC) è una tecnologia open source che introduce un sistema di isolamento basato su policy per gli agenti AI, disponibile in versione stabile su Windows 11.
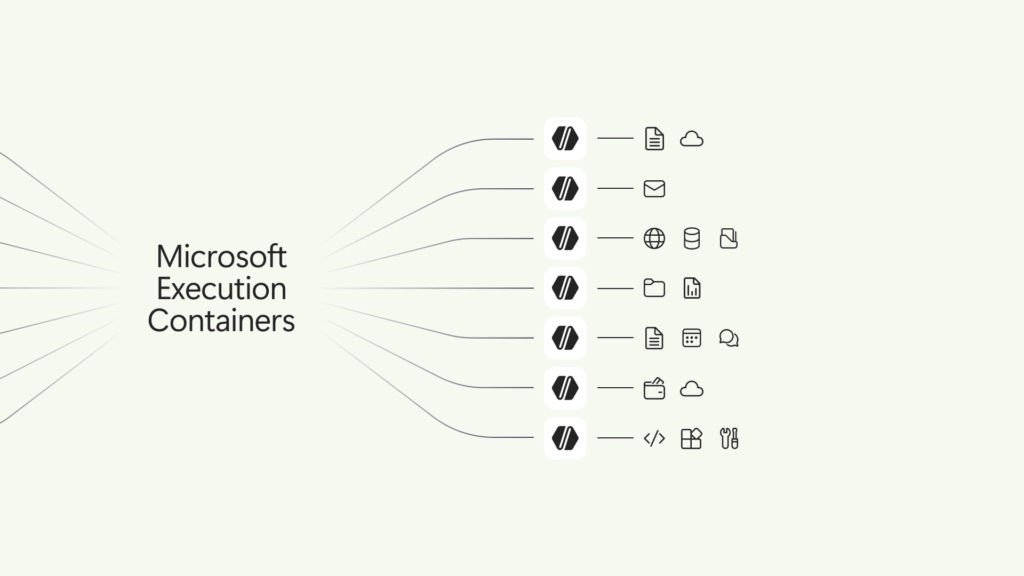
A differenza delle applicazioni tradizionali, gli agenti possono generare codice, decidere quali strumenti utilizzare e modificare la sequenza delle proprie attività in funzione dei risultati ottenuti. Questa autonomia comporta il rischio che accedano a risorse non necessarie o eseguano operazioni che eccedono le autorizzazioni previste.
MXC permette agli sviluppatori e agli amministratori IT di definire quali file, risorse di rete e funzionalità del sistema operativo possono essere utilizzati da un agente. Le autorizzazioni vengono applicate dall’ambiente di esecuzione, indipendentemente dalle decisioni del modello AI.
Un agente incaricato di modificare il codice di un sito web, per esempio, può ricevere accesso in lettura e scrittura al repository del progetto e agli strumenti di sviluppo necessari, oltre alla possibilità di consultare la configurazione del server di produzione, senza poterla modificare. Allo stesso agente può essere impedito di accedere ai documenti personali dell’utente o di stabilire connessioni di rete non autorizzate.
L’isolamento può essere applicato al codice generato dal modello, agli strumenti utilizzati, ai plugin, al sistema che coordina l’agente oppure all’intero ambiente di esecuzione.
Il progetto MXC è pubblicato su GitHub e utilizza uno schema di configurazione JSON comune, affiancato da SDK multipiattaforma. Le policy vengono tradotte nei meccanismi di isolamento disponibili sui differenti sistemi operativi.
Gli ambienti di isolamento disponibili
MXC offre diversi livelli di separazione, selezionabili in funzione dei requisiti di sicurezza e delle caratteristiche del carico di lavoro.
I process container sono disponibili su Windows 11, macOS e Linux e utilizzano i rispettivi meccanismi di sandboxing: AppContainer su Windows, Seatbelt su macOS e Bubblewrap su Linux. Consentono di isolare processi e strumenti con un impatto contenuto sui tempi di esecuzione.
I session container, disponibili esclusivamente su Windows 11, permettono agli agenti di operare in una sessione separata, con un account Windows distinto e isolamento di desktop, clipboard, interfaccia grafica e dispositivi di input. Sono destinati soprattutto agli agenti persistenti e alle automazioni che richiedono l’interazione con un ambiente desktop.
I WSL container (WSLc) permettono di eseguire su Windows 11 strumenti e carichi di lavoro che dipendono dall’ecosistema Linux, mentre le microVM, ancora sperimentali su Windows 11 e Linux, utilizzano la virtualizzazione hardware per ottenere una separazione più forte.
Anche Windows 365 supporta MXC in versione generalmente disponibile, consentendo di eseguire agenti isolati nei Cloud PC e mantenere separate le loro attività da quelle dell’utente.
I livelli di isolamento non offrono garanzie equivalenti: un container di processo, una sessione Windows separata e una microVM applicano meccanismi di sicurezza differenti, con conseguenze sulle prestazioni, sull’accesso alle risorse e sulla superficie di attacco.
Le policy MXC controllano file, rete, processi e interfaccia grafica
La configurazione di MXC permette di specificare separatamente le risorse accessibili e le operazioni consentite.
Le policy possono stabilire quali directory siano disponibili in lettura o scrittura, quali connessioni di rete siano autorizzate, quali comandi possano essere eseguiti e se l’agente possa interagire con l’interfaccia grafica.
Il controllo della rete comprende le connessioni in ingresso e in uscita, incluso l’accesso ai servizi esposti attraverso l’interfaccia loopback del sistema. La configurazione dei processi può definire il comando da eseguire, gli argomenti, la directory di lavoro e le variabili d’ambiente.
Su Windows, i process container MXC possono inoltre produrre report delle attività per individuare quali risorse un agente abbia tentato di utilizzare durante l’esecuzione.
Sono previste tre modalità operative: Enforcement applica le autorizzazioni definite e blocca gli accessi non consentiti, senza produrre un report delle attività. Learning mantiene attivi i blocchi, ma registra in un report JSON i tentativi di accesso negati, permettendo agli sviluppatori di identificare le risorse necessarie al funzionamento dell’agente. Permissive registra invece le operazioni che sarebbero state bloccate dalla policy MXC, consentendone l’esecuzione. Rimangono comunque applicabili le altre restrizioni imposte dal sistema operativo e dall’organizzazione.
Le modalità di osservazione delle attività sono specifiche dei process container MXC su Windows e consentono di definire progressivamente policy basate sul principio del minimo privilegio, senza concedere inizialmente all’agente un accesso indiscriminato alle risorse.
L’integrazione con Microsoft Intune, prevista prossimamente, permetterà agli amministratori IT di gestire centralmente le policy dei process container MXC su Windows 11, stabilendo anche le condizioni alle quali gli agenti possono creare nuovi ambienti isolati.
Le autorizzazioni definite dall’organizzazione potranno essere più restrittive di quelle previste dallo sviluppatore dell’agente. Quando una risorsa necessaria risulta bloccata, l’applicazione dovrà gestire il mancato accesso, richiedere un intervento autorizzativo quando previsto oppure utilizzare una procedura alternativa.
Microsoft Entra e Agent 365 distingueranno le attività degli agenti da quelle degli utenti
L’isolamento dell’esecuzione sarà affiancato da un sistema di identificazione degli agenti, sviluppato attraverso l’integrazione con Microsoft Entra e Microsoft Agent 365.
La distinzione tra identità dell’utente e identità dell’agente consentirà alle organizzazioni di attribuire le operazioni al soggetto che le ha effettivamente eseguite e applicare controlli specifici.
Se un agente viene compromesso oppure viola una policy, gli amministratori potranno limitarne l’accesso alle risorse protette senza necessariamente interrompere l’accesso dell’utente alle stesse risorse.
Agent 365 permetterà di identificare gli agenti attivi, monitorarne il comportamento, analizzare eventuali rischi e applicare policy individuali o di gruppo, estendendo ai sistemi locali le capacità di gestione già previste per gli agenti aziendali.
Queste funzionalità di identificazione e gestione centralizzata saranno introdotte progressivamente, mentre il livello di isolamento MXC è già disponibile.
L’ecosistema comprende agenti e strumenti che supportano MXC, tra cui OpenAI Codex, GitHub Copilot, OpenClaw, Replit, LM Studio, NVIDIA OpenShell e Unsloth AI.
NVIDIA ha integrato MXC in OpenShell, aggiungendo controlli sugli accessi ai file e ai servizi di inferenza, gestione delle credenziali, restrizioni avanzate sulle connessioni di rete e, per gli ambienti aziendali, funzionalità di auditing basate sul formato OCSF.
Hanno annunciato il supporto futuro anche Anthropic Claude Code, Box, Egnyte, Heidi Health, Hermes Agent di Nous Research, Manus, Perplexity, Raycast e Simular.
Meta Muse for Windows arriverà inoltre come applicazione nativa con integrazione MXC.
Windows ML estende l’esecuzione dei modelli locali con llama.cpp
L’architettura Hybrid Intelligence utilizza Windows ML per eseguire modelli AI attraverso le risorse di calcolo disponibili sul dispositivo, distribuendo i carichi di lavoro tra GPU, NPU e CPU.
Microsoft ha annunciato il supporto a llama.cpp in Windows ML, ampliando le possibilità di utilizzare modelli open source e di sperimentare nuove architetture senza dover gestire separatamente tutte le specificità dell’hardware.
L’integrazione si aggiunge al lavoro sull’ambiente di sviluppo AI di Windows, che comprende PyTorch e gli strumenti per utilizzare differenti acceleratori attraverso runtime comuni.
Il supporto a llama.cpp e PyTorch nell’ecosistema Windows ML rientra nell’ampliamento degli strumenti disponibili per gli sviluppatori che intendono distribuire modelli direttamente sui PC.
L’esecuzione locale consente di evitare il trasferimento dei dati al cloud per le elaborazioni che possono essere completate sul dispositivo, riducendo inoltre la dipendenza dalle risorse di inferenza remote. I benefici economici e prestazionali dipendono però dal modello utilizzato, dalla memoria disponibile e dal volume di richieste.
Un modello deve infatti poter essere caricato in memoria insieme alle strutture necessarie all’inferenza, mentre le applicazioni e il sistema operativo continuano a utilizzare le proprie risorse. La lunghezza del contesto incide ulteriormente sul consumo di memoria e sulle prestazioni.
MAI Code 1.1 Flash esegue localmente un modello da 137 miliardi di parametri
MAI Code 1.1 Flash è un modello Microsoft specializzato nello sviluppo software, basato su un’architettura mixture-of-experts con 137 miliardi di parametri complessivi, dei quali 6,8 miliardi attivi durante l’inferenza.
L’architettura permette di utilizzare soltanto una parte dei parametri per ogni elaborazione, riducendo il carico computazionale rispetto a un modello denso di dimensioni equivalenti.
Microsoft ne ha realizzato una versione ottimizzata per l’esecuzione locale attraverso tecniche di quantizzazione e speculative decoding.
La quantizzazione riduce la precisione numerica utilizzata per rappresentare i parametri. Nel caso di MAI Code 1.1 Flash, Microsoft utilizza una precisione media di circa 3,3 bit per peso, ottenendo una riduzione prossima all’80% rispetto alla versione originale.
I pesi del modello quantizzato occupano circa 53 GB, una quantità che rappresenta soltanto una parte della memoria necessaria durante l’inferenza. Devono infatti essere considerate anche la cache KV, che memorizza le informazioni utilizzate dal meccanismo di attenzione, le strutture del runtime e le risorse richieste dalle altre applicazioni.
Su Surface Laptop Ultra, Microsoft ha misurato un picco di utilizzo della memoria di 75,5 GB con una finestra di contesto di 256.000 token.
Con contesti di 64.000 e 128.000 token, la velocità di elaborazione del prompt raggiunge rispettivamente 923,5 e 769,8 token al secondo.
Lo speculative decoding contribuisce a migliorare la velocità di generazione: un modello ausiliario propone sequenze di token che vengono successivamente verificate dal modello principale. Il procedimento richiede memoria aggiuntiva, ma può ridurre il tempo necessario per produrre una risposta.
La valutazione delle prestazioni comprende benchmark specifici per lo sviluppo software, nei quali conta la capacità di completare correttamente le attività e non soltanto la velocità di generazione dei token.
| Benchmark | MAI Code 1.1 Flash cloud | MAI Code 1.1 Flash locale | GPT-OSS 120B |
| SWE-bench Verified | 72,6% | 70,8% | 32,0% |
| Terminal-Bench 2.1 | 62,9% | 66,29% | 23,6% |
La versione quantizzata mantiene prestazioni vicine a quelle del modello originale su SWE-bench Verified e ottiene un punteggio superiore su Terminal-Bench 2.1.
Per il confronto con GPT-OSS 120B è stata utilizzata la versione GGUF distribuita da Unsloth. I test sono stati eseguiti il 5 ottobre 2026 su Windows ARM64 con runtime llama.cpp CUDA e DFlash2 sliding-window speculative decoding.
L’esecuzione locale di MAI Code 1.1 Flash è destinata inizialmente ai sistemi dotati di capacità computazionale e memoria sufficienti, compresi i nuovi PC basati su NVIDIA RTX Spark.
Microsoft prevede inoltre l’utilizzo di altri modelli di grandi dimensioni, tra cui un futuro NVIDIA Nemotron da oltre 70 miliardi di parametri, quantizzato a 2 bit per richiedere poco più di 20 GB di memoria per i pesi, e DeepSeek V4 Flash, con 284 miliardi di parametri.
GitHub HydraFusion sceglierà tra inferenza locale e cloud
GitHub HydraFusion è il sistema di orchestrazione utilizzato da GitHub per selezionare uno o più modelli AI in funzione delle caratteristiche di una richiesta, bilanciando prestazioni, costi e latenza.
Finora applicato ai modelli disponibili nel cloud, sarà esteso all’esecuzione locale sui PC Windows.
GitHub Copilot potrà quindi assegnare un’attività a un modello installato sul dispositivo quando questo dispone delle capacità necessarie, ricorrendo invece ai modelli remoti per le richieste che richiedono maggiori risorse o funzionalità differenti.
Durante una sessione articolata in più interazioni, HydraFusion potrà considerare il contesto dell’attività e lo stato della cache, mantenendo le informazioni già elaborate quando possibile.
Gli sviluppatori avranno due modalità di utilizzo: con la modalità Auto, Copilot sceglierà automaticamente tra inferenza locale e cloud; in alternativa, sarà possibile selezionare esplicitamente un modello locale, mantenendo il controllo sulla destinazione delle elaborazioni.
La selezione diretta comprenderà MAI Code 1.1 Flash attraverso Windows ML, ma anche modelli esposti mediante endpoint locali compatibili con le API OpenAI.
L’orchestrazione sarà disponibile in GitHub Copilot CLI, nell’app GitHub Copilot e in Visual Studio Code, con una preview sperimentale prevista entro ottobre 2026.
L’inferenza locale non comporta necessariamente un funzionamento completamente offline. Un agente può utilizzare un modello installato sul PC e continuare a interagire con repository remoti, server MCP, servizi esterni e altre risorse cloud.
GitHub Copilot utilizza MXC per isolare comandi e strumenti
L’integrazione tra GitHub Copilot e MXC permette di applicare restrizioni ai processi eseguiti dagli agenti, senza concedere automaticamente loro tutte le autorizzazioni dell’utente.
Su Windows, GitHub Copilot utilizza il livello BaseContainer del backend ProcessContainer. Su macOS il meccanismo corrispondente è Seatbelt, mentre su Linux viene utilizzato Bubblewrap.
Questi sistemi permettono di eseguire gli strumenti all’interno di un ambiente isolato senza richiedere necessariamente una macchina virtuale o un’immagine container separata.
Quando il sandboxing è attivo, i comandi di shell e, per impostazione predefinita, i server MCP locali e i language server vengono eseguiti all’interno del processo isolato.
I controlli sugli strumenti integrati per la gestione dei file funzionano diversamente. Questi strumenti vengono eseguiti all’interno di GitHub Copilot e le loro richieste sono verificate dal sistema che governa l’agente, in base alle autorizzazioni effettive. Non si tratta quindi dello stesso isolamento imposto dal sistema operativo ai processi separati.
Anche i server MCP remoti rimangono esterni alla sandbox locale. Quando sono previsti controlli sulle loro connessioni, GitHub Copilot applica le verifiche direttamente all’interno del proprio processo.
La distinzione permette di comprendere quali operazioni siano soggette alle restrizioni del sistema operativo e quali dipendano invece dai controlli applicativi dell’agente.
Nella CLI di GitHub Copilot, le impostazioni del sandboxing possono essere modificate attraverso il comando /sandbox.
Le automazioni di Copilot possono utilizzare modelli locali e repository isolati
Le nuove capacità di GitHub Copilot consentono di configurare agenti incaricati di eseguire attività ricorrenti, utilizzando un modello locale e un ambiente di lavoro con autorizzazioni specifiche.
Un esempio riguarda la produzione automatica di un dashboard HTML giornaliero per la gestione delle attività di sviluppo.
L’automazione può essere configurata nell’app GitHub Copilot, associando un progetto a una sessione isolata e definendo le operazioni da eseguire.
Nel caso illustrato da Microsoft, l’agente utilizza le informazioni relative alle issue e alle pull request del repository pubblico github/copilot-sdk per produrre una dashboard di triage.
Il report comprende le attività aperte, chiuse e integrate, gli elementi aggiornati recentemente, quelli rimasti inattivi, le etichette, gli autori, gli assegnatari e l’anzianità delle attività.
L’agente genera un file dashboard/index.html con CSS e SVG incorporati e aggiorna un archivio history.json, mantenendo i risultati degli ultimi sette giorni.
L’automazione può essere programmata per l’esecuzione quotidiana, per esempio alle 9:00, e configurata per utilizzare MAI Code 1.1 Flash come modello locale.
Il sandboxing viene attivato nelle impostazioni del progetto attraverso l’opzione Sandbox new sessions. Nella configurazione predefinita, la directory di lavoro dispone delle autorizzazioni necessarie per leggere e modificare i file del progetto, mentre l’accesso alle altre risorse del sistema è limitato.
Le restrizioni possono essere ulteriormente adattate, per esempio mantenendo i repository sorgente in sola lettura e impedendo ai processi di test di utilizzare la rete.
Dopo la configurazione, l’automazione può essere avviata manualmente per verificare il risultato e successivamente eseguita secondo la pianificazione definita.
Il file HTML generato e gli altri artefatti della sessione rimangono disponibili per la consultazione.
Copilot utilizzerà il contesto locale del PC ed eseguirà operazioni in Windows
Microsoft sta preparando tre capacità di Copilot sui Copilot+ PC, basate sull’architettura Hybrid Intelligence.
Local Context consentirà all’assistente, con l’autorizzazione dell’utente, di utilizzare informazioni presenti sul computer, inclusi file e attività recenti. Copilot potrà individuare documenti pertinenti a una richiesta e impiegarli per completare il lavoro.
Local Actions permetterà di eseguire operazioni direttamente in Windows, come organizzare file, analizzare informazioni diagnostiche, risolvere problemi di configurazione, scrivere codice e completare procedure articolate.
Local Models consentirà invece di assegnare determinate elaborazioni ai modelli installati sul PC, utilizzando quelli cloud quando necessario.
Queste capacità saranno integrate nelle tre esperienze Home, Code e Autopilot, presentate da Microsoft il 25 settembre.
In Home, Copilot potrà recuperare i documenti utilizzati recentemente e organizzarli in materiali pronti per la collaborazione. L’ambiente riunisce inoltre Chat, Cowork e le funzionalità di Word, Excel e PowerPoint integrate nell’applicazione Copilot.
In Code, l’assistente potrà generare applicazioni Windows native a partire da istruzioni in linguaggio naturale, eseguire codice attraverso ambienti isolati MXC e utilizzare modelli locali per le attività compatibili. La tecnologia sottostante deriva dall’ambiente di sviluppo di GitHub Copilot.
Autopilot è concepito come un agente personale persistente e proattivo, capace di continuare a lavorare per conto dell’utente mentre quest’ultimo svolge altre attività. L’integrazione con Windows gli consentirà di utilizzare il contesto locale, eseguire azioni sul dispositivo e scegliere le risorse AI disponibili.
Home e Code sono in fase di distribuzione iniziale attraverso il programma Frontier di Microsoft, mentre Autopilot è previsto in anteprima privata.
Le funzionalità aggiuntive basate su Hybrid Intelligence cominceranno a essere distribuite nei prossimi mesi sui Copilot+ PC, con disponibilità variabile in funzione del dispositivo, del mercato e della piattaforma hardware.
Windows Search eseguirà operazioni direttamente dalla barra delle applicazioni
Windows Search introduce migliaia di azioni richiamabili direttamente dalla ricerca nella barra delle applicazioni, attraverso istruzioni in linguaggio naturale.
Gli utenti potranno modificare impostazioni e avviare operazioni senza dover necessariamente aprire un’applicazione o navigare tra differenti schermate.
Tra le funzioni previste figurano l’attivazione della modalità scura, la disattivazione delle notifiche, l’attivazione della modalità aereo, la regolazione della luminosità e la disattivazione dell’audio.
Sarà possibile anche intervenire sull’organizzazione delle finestre, per esempio minimizzandole tutte oppure modificandone la disposizione sul desktop.
La ricerca potrà essere utilizzata anche per inviare messaggi.
Microsoft prevede inoltre un’integrazione facoltativa con Copilot, che consentirà di ricevere risposte direttamente nell’interfaccia di ricerca e continuare eventualmente la conversazione nell’applicazione completa.
Le nuove azioni di Windows Search hanno iniziato a essere distribuite il 7 ottobre agli iscritti al programma Windows Insider nel canale sperimentale. L’integrazione facoltativa con Copilot arriverà inizialmente in alcuni mercati entro la fine dell’anno.
OpenClaw avrà un gateway Windows nativo per gli agenti sempre attivi
Microsoft ha annunciato nuove procedure di configurazione per i mini desktop PC utilizzati come sistemi sempre attivi, destinati all’esecuzione di agenti che svolgono attività prolungate.
Le nuove procedure permetteranno di installare e configurare gli agenti attraverso pochi passaggi, riducendo la necessità di intervenire manualmente attraverso terminale e file di configurazione.
Per OpenClaw è previsto un gateway Windows nativo che semplifica l’installazione e l’esecuzione degli agenti, insieme all’integrazione MXC per isolarne le attività.
Microsoft intende estendere progressivamente queste modalità di configurazione ad altri dispositivi Windows.
La diffusione dell’inferenza locale è già significativa nell’ecosistema Copilot+ PC: Microsoft indica oltre 2.000 miliardi di inferenze eseguite localmente ogni mese e afferma che più del 40% dei laptop attualmente prodotti per il mercato business appartiene alla categoria Copilot+.
L’orchestrazione tra modelli locali e cloud permetterà di utilizzare queste risorse anche per attività agentiche che richiedono più chiamate ai modelli, l’esecuzione di strumenti e l’accesso a dati presenti sul computer.
Aggiornamenti, interfaccia e affidabilità restano parte dell’evoluzione di Windows
Microsoft sta intervenendo anche sulle componenti tradizionali del sistema operativo, attraverso modifiche alla gestione degli aggiornamenti, al menu Start, alla barra delle applicazioni e agli strumenti di ricerca.
Il lavoro comprende miglioramenti alla personalizzazione e al controllo di Windows Update, alla qualità dei driver e all’affidabilità delle periferiche, sviluppati insieme ai partner hardware.
Proseguono inoltre gli interventi sugli strumenti destinati agli sviluppatori, con ottimizzazioni dell’ambiente Windows e dell’esecuzione delle applicazioni.
Questi aggiornamenti affiancano l’introduzione delle capacità AI, che richiedono al sistema operativo di gestire processi autonomi di lunga durata, controllare l’accesso alle risorse e coordinare applicazioni, modelli e strumenti attraverso differenti ambienti di esecuzione.