Un agente AI può nascere intorno a poche chiamate a un modello, ma trasformarlo in un’applicazione capace di funzionare stabilmente in produzione richiede compute, persistenza dei dati, autenticazione, gestione dei file, coordinamento dei processi, esecuzioni di lunga durata e infrastruttura web. Con Volcano, Kong riunisce questi componenti in una sola piattaforma gestita.
Annunciato il 30 settembre durante l’API + AI Summit 2026, Volcano viene definito da Kong come agentic infrastructure: un ambiente destinato sia agli agenti AI sia alle applicazioni che li incorporano. La piattaforma comprende funzioni gestite, workflow durevoli, database PostgreSQL, autenticazione, servizi realtime, file storage, hosting frontend, observability e primitive di coordinamento distribuito.
L’iniziativa estende così il raggio d’azione di Kong. L’azienda ha costruito gran parte della propria offerta intorno alla connettività e alla governance delle API e, più recentemente, del traffico generato da modelli, MCP e comunicazioni agent-to-agent. Volcano interviene invece sul livello nel quale gli agenti e le applicazioni vengono eseguiti e mantengono il proprio stato.
Kong è una società software specializzata in API management, connettività e governance dei servizi applicativi. Le sue origini sono italiane: i cofondatori Augusto “Aghi” Marietti e Marco Palladino avviarono nel 2009 a Milano Mashape, marketplace per API da cui sarebbe poi nata Kong Inc. nel 2017. Oggi Marietti è CEO e Palladino CTO. La società ha progressivamente ampliato l’offerta dal gateway open source verso API management, service connectivity, developer portal, AI Gateway e strumenti per la comunicazione tra agenti e servizi. La piattaforma cloud Kong Konnect riunisce queste funzioni in un ambiente gestito, mentre Volcano estende ora il perimetro verso compute, stato e servizi applicativi per workload agentici.
“Volcano ci consente di costruire nell’era dell’AI con una piattaforma davvero chiavi in mano”, afferma Marco Palladino. “Gli sviluppatori non dovrebbero assemblare manualmente l’infrastruttura necessaria per trasformare un agente AI in un’applicazione di produzione. Stiamo riunendo queste capacità in un’unica piattaforma, così che possano concentrarsi sulle esperienze e sulle applicazioni anziché sull’infrastruttura sottostante”.
Dalla chiamata al modello all’infrastruttura dell’agente
La differenza emerge soprattutto quando un prototipo deve diventare un servizio operativo. Un agente che svolge attività persistenti può dover conservare dati tra un’esecuzione e l’altra, elaborare file, autenticare utenti, aspettare ore o giorni prima di riprendere un workflow, coordinarsi con altri processi oppure impedire che due worker intervengano contemporaneamente sulla stessa risorsa.
Volcano raccoglie questi servizi nello stesso progetto applicativo, accessibile attraverso dashboard, CLI, SDK, API e server MCP.
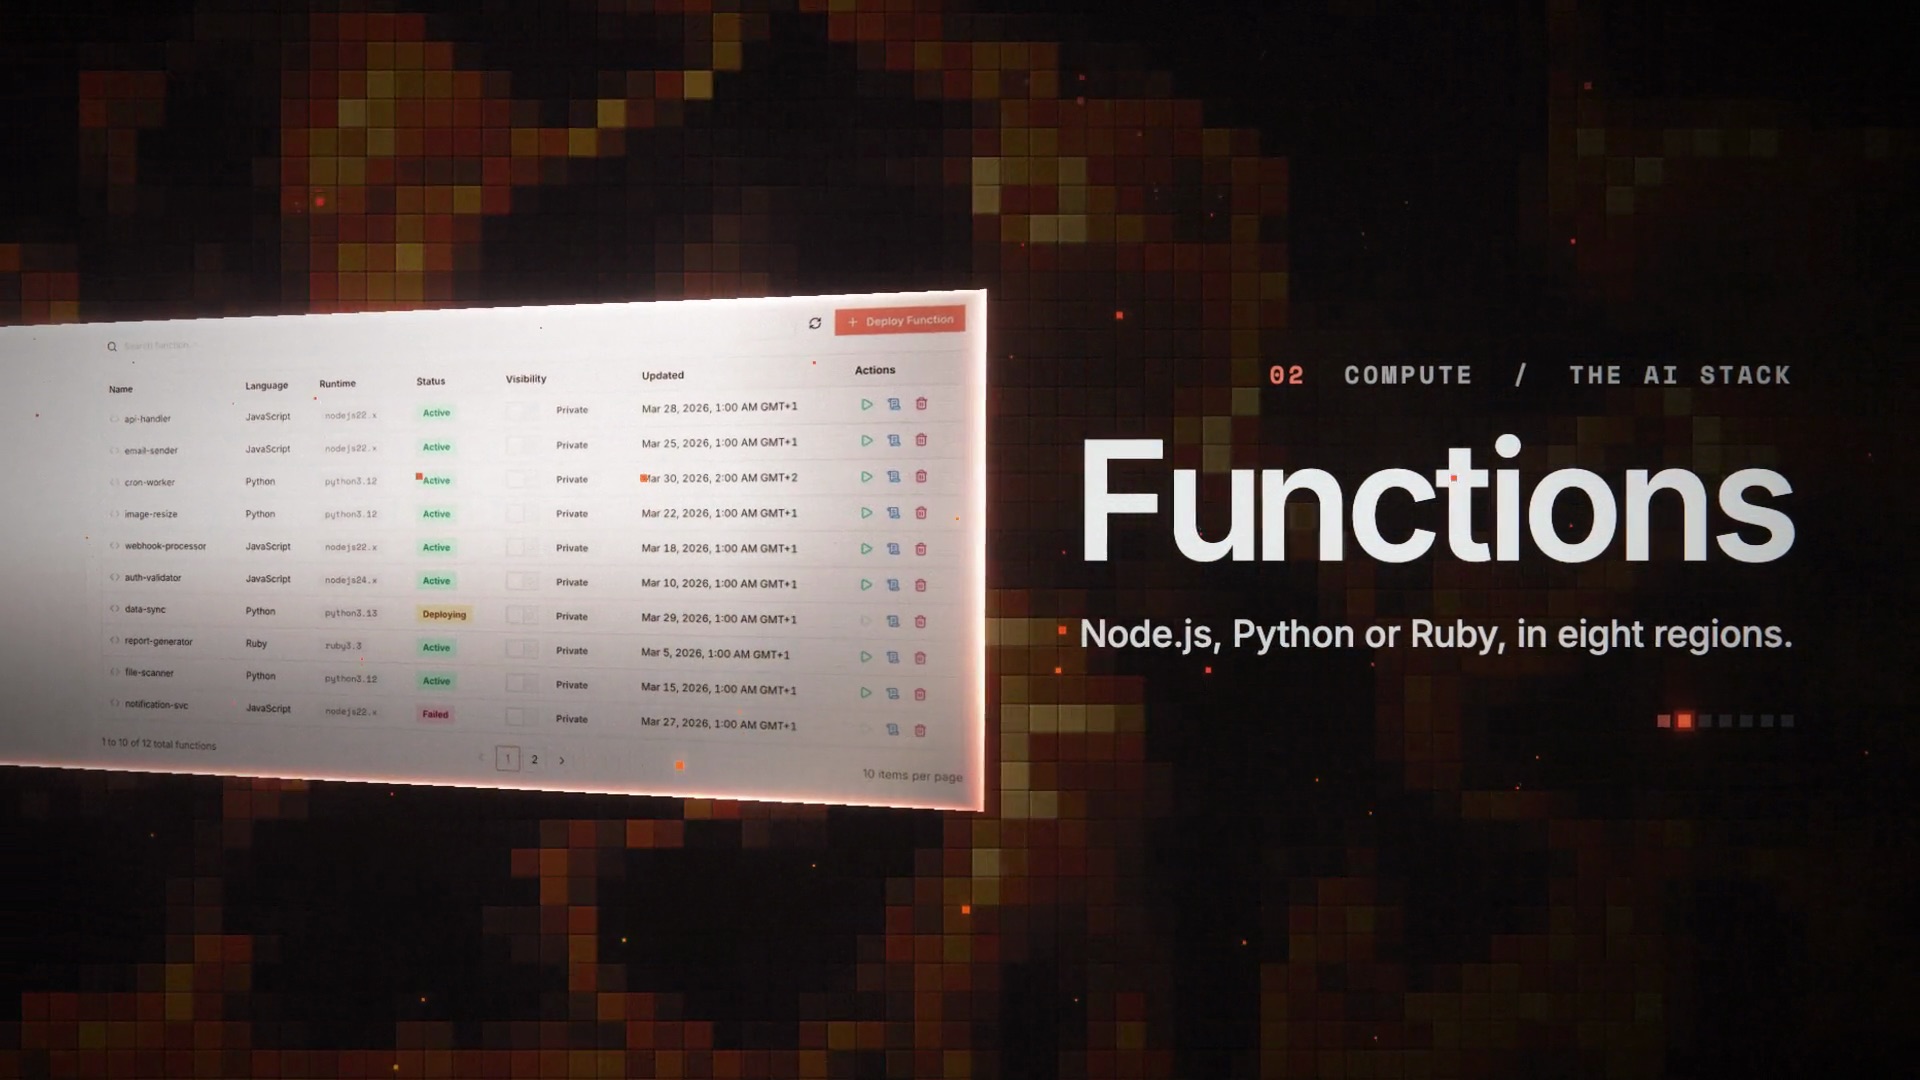
Per l’esecuzione del codice sono disponibili funzioni in JavaScript/TypeScript, Python e Ruby, distribuite nelle regioni configurate per il progetto e invocabili tramite HTTP o scheduler. Il runtime gestisce l’autoscaling e, nei piani che lo prevedono, il geofencing, così da mantenere l’esecuzione nelle regioni richieste dai workload soggetti a vincoli di localizzazione dei dati.
Build, frontend, funzioni e servizi di backend producono inoltre log consultabili dalla piattaforma, introducendo un livello di observability direttamente nell’ambiente di esecuzione.
Accanto alle funzioni standard ci sono le durable functions, pensate per processi che non possono essere confinati nella durata di una singola richiesta. Il runtime registra il completamento dei diversi passaggi del workflow e consente di riprendere l’esecuzione dall’ultimo step completato dopo un’interruzione.
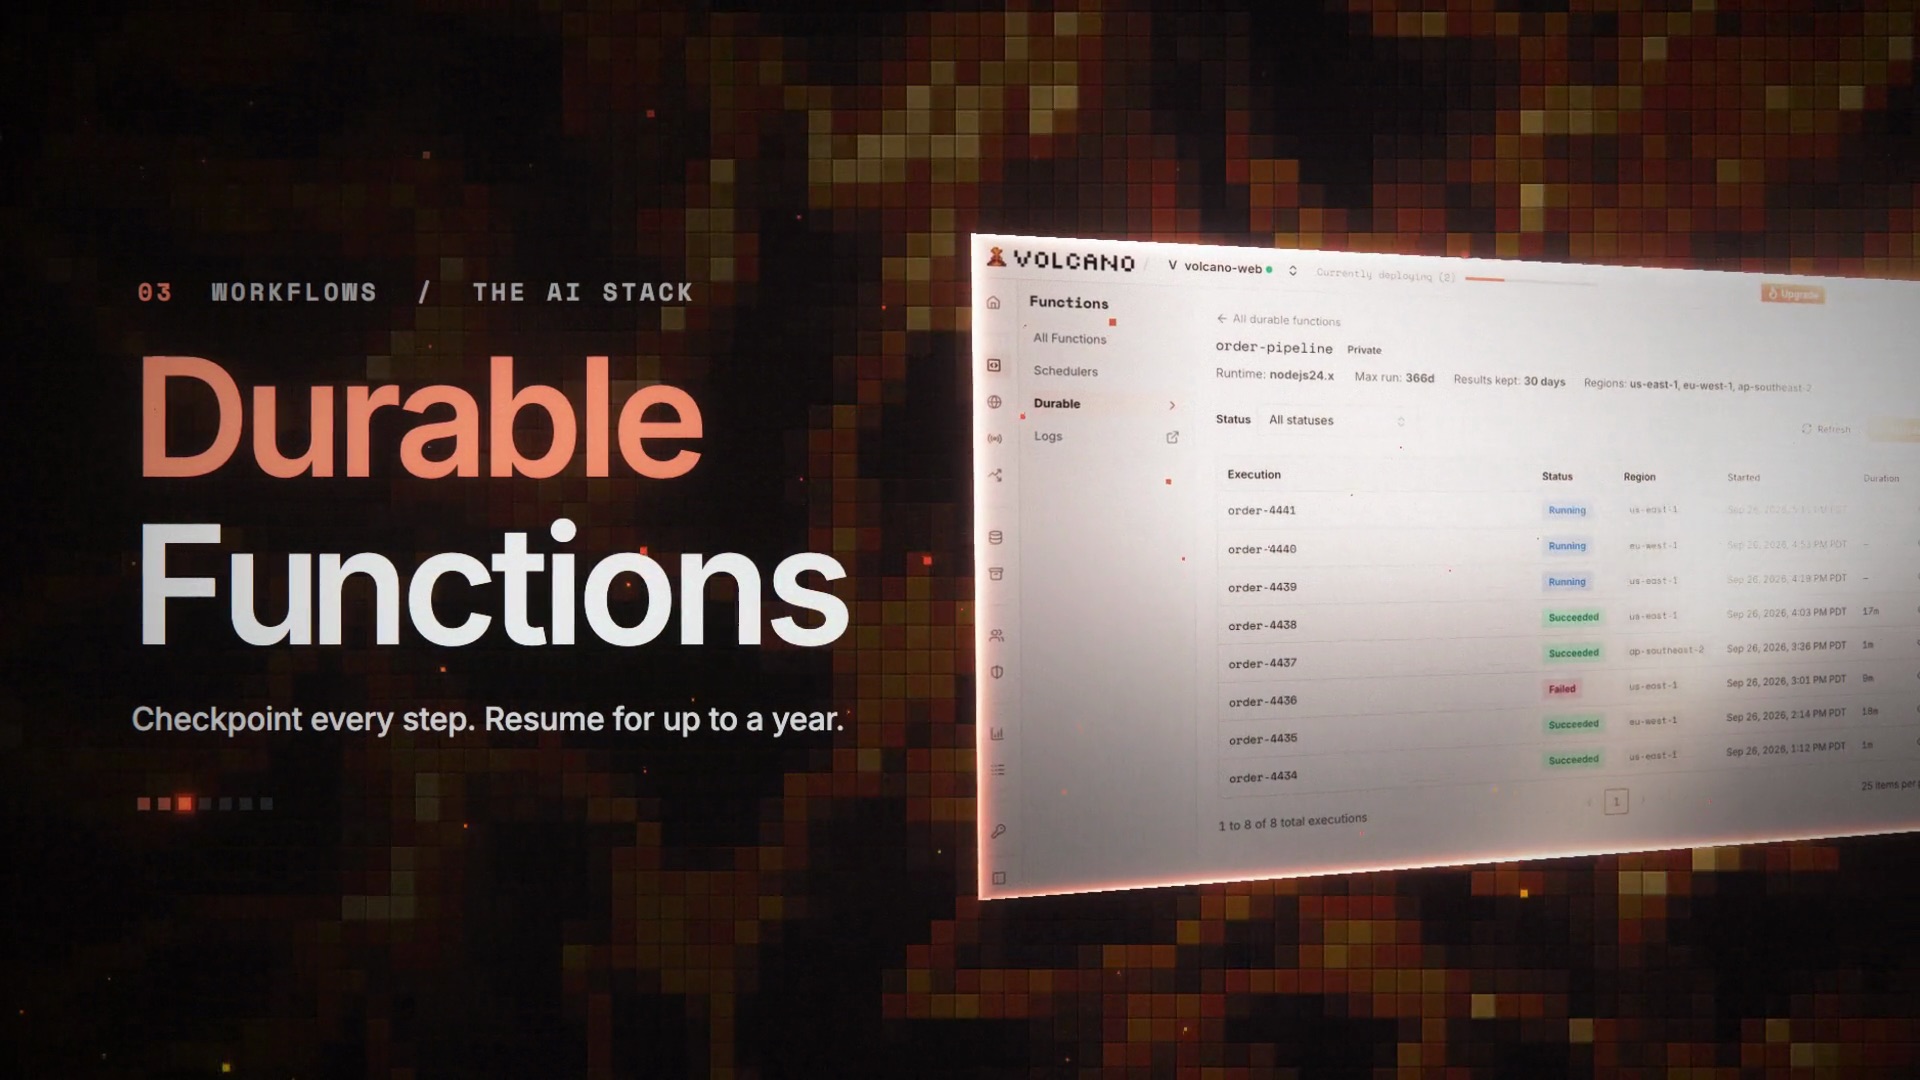
Una singola esecuzione durevole può proseguire fino a 366 giorni, con supporto per attese, retry, avvii idempotenti e pianificazioni cron. Un agente può quindi sospendere un’attività in attesa di un evento esterno e riprenderla successivamente senza mantenere continuamente attivo il processo che l’ha avviata.
PostgreSQL entra nello stato operativo degli agenti
Alla componente di esecuzione Kong affianca PostgreSQL gestito, con scalabilità automatica, row-level security, accesso diretto al database, backup, branching e supporto per workload vettoriali.
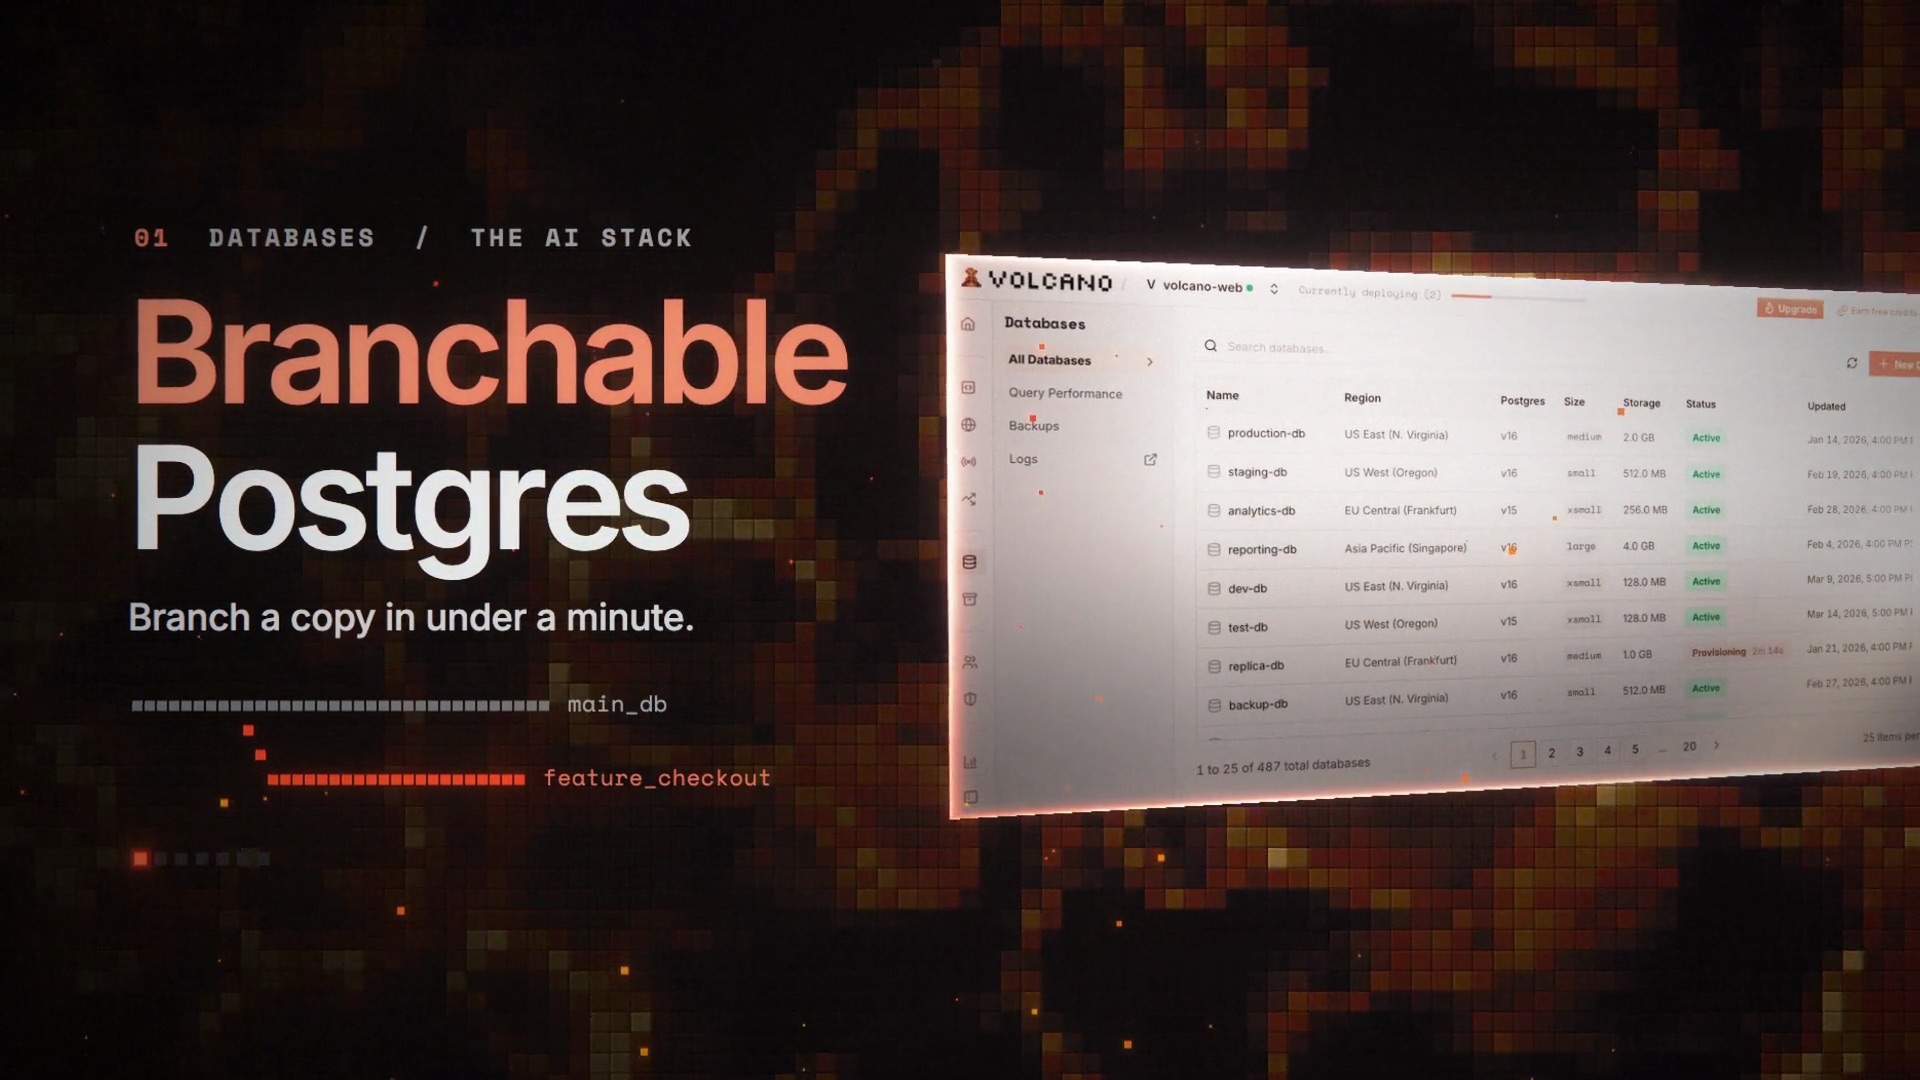
Il branching del database consente di creare una diramazione isolata sulla quale applicare modifiche senza intervenire immediatamente sull’istanza di origine.
Il meccanismo si presta in particolare ai workflow dei coding agent: un agente può lavorare su un ambiente separato, modificare schema e dati, verificare il risultato e successivamente eliminare la branch senza intervenire direttamente sul database utilizzato dall’applicazione.
Questa impostazione risponde a una caratteristica sempre più importante dello sviluppo agentico: se è il software stesso a creare codice, modificare configurazioni e distribuire applicazioni, anche le risorse sottostanti devono poter essere create e manipolate programmaticamente, con ambienti isolabili e riproducibili.
Claude Code, Codex e Cursor possono operare direttamente sulla piattaforma
Volcano integra Claude Code, OpenAI Codex e Cursor, oltre ad altri strumenti di coding agentico.
La piattaforma espone le proprie capacità non soltanto attraverso interfacce destinate allo sviluppatore, ma anche tramite skill, plugin e server MCP utilizzabili dagli agenti. Un coding agent può quindi intervenire direttamente sul progetto, distribuire funzioni, lavorare sul database e configurare i servizi necessari all’applicazione.
Palladino sintetizza questa impostazione affermando che con Volcano è possibile passare “da zero a un agente in produzione con un solo prompt”.
L’ambiente diventa così una superficie operativa per l’agente: non più soltanto qualcosa di preparato preventivamente da un amministratore, ma un insieme di risorse che il software può configurare mentre costruisce o modifica un’applicazione.
Identità, realtime e storage condividono lo stesso progetto
Volcano comprende anche diversi servizi normalmente forniti da piattaforme distinte.
Il sistema di authentication as a service supporta email e password, Google, GitHub, Microsoft e Apple, oltre agli utenti anonimi che possono essere successivamente convertiti in account permanenti.
L’identità non rimane confinata al servizio di autenticazione. La stessa sessione viene riconosciuta da PostgreSQL, funzioni e storage: le policy del database possono utilizzare primitive come auth.uid(), le funzioni ricevono l’identità dell’utente già verificata e le regole dello storage possono applicare gli stessi criteri. L’autorizzazione può quindi essere applicata direttamente nel livello che conserva o elabora i dati, senza dover essere ricostruita separatamente in ogni componente.
Il servizio Realtime distribuisce mediante WebSocket le modifiche provenienti da PostgreSQL e offre broadcast e presence tracking. Oltre alle applicazioni collaborative, questi meccanismi possono servire al coordinamento di agenti e processi che devono reagire allo stesso insieme di eventi.
Lo storage utilizza bucket con policy di accesso in stile row-level security. Senza policy esplicite l’accesso viene negato, mentre le regole possono essere definite separatamente per lettura, inserimento, aggiornamento ed eliminazione dei file.
Sul fronte applicativo, la piattaforma può infine distribuire frontend Next.js, statici o server-rendered, mentre le funzioni vengono eseguite dal runtime gestito.
Il coordinamento diventa parte dell’infrastruttura agentica
Una parte meno visibile riguarda il coordinamento tra processi.
Volcano include distributed locks, lease rinnovabili che consentono di assicurare che una sola istanza possa lavorare su una determinata risorsa. Un fencing token permette inoltre alla risorsa protetta di verificare quale processo detenga effettivamente il lock.
La stessa logica di coordinamento viene utilizzata per la leader election dei job, così da evitare esecuzioni concorrenti indesiderate nei workflow distribuiti.
Queste primitive diventano particolarmente utili negli ambienti agentici, dove più worker o agenti possono tentare di intervenire contemporaneamente sullo stesso task, sullo stesso record o sulla stessa fase di un processo.
Kong prevede inoltre capacità di coordinamento più ampie per agenti singoli e gruppi di agenti, comprese queue e approvazioni umane, indicate al momento come coming soon. Anche il sandboxing del compute, destinato a isolare ulteriormente i workload eseguiti dagli agenti, è previsto in una fase successiva.
Gli agenti richiedono un ambiente operativo più completo
Volcano arriva mentre l’offerta per l’AI agentica sta cambiando forma. La prima generazione di strumenti si è concentrata soprattutto sull’orchestrazione: collegare un modello a tool e API, mantenere il contesto, suddividere un’attività in passaggi e coordinare eventualmente più agenti.
Quando questi sistemi vengono spostati in produzione, servono però anche compute, filesystem, stato, identità, accesso alla rete, scheduling, retry e isolamento tra sessioni.
Amazon Bedrock AgentCore Runtime segue questa direzione offrendo ambienti di esecuzione dedicati agli agenti. Il runtime serverless basato su microVM può mantenere una sessione attiva fino a otto ore; le AgentCore Runtime Instances estendono la durata fino a 14 giorni, possono utilizzare istanze GPU e permettono a più agenti di condividere lo stesso ambiente.
Il filesystem può sopravvivere agli stop e alle successive riprese della sessione, conservando codice, pacchetti installati, file di progetto, cache e checkpoint. AgentCore può quindi diventare l’ambiente di lavoro dell’agente, anziché limitarsi a ricevere richieste dirette al modello.
Anche Microsoft Foundry Agent Service tratta gli agenti come applicazioni software da ospitare. Gli Hosted Agents sono applicazioni agentiche containerizzate eseguite sull’infrastruttura gestita da Microsoft e ricevono, per ogni sessione, una sandbox isolata a livello di macchina virtuale.
Il filesystem $HOME e i file associati alla sessione vengono mantenuti quando il compute viene disattivato per inattività e ripristinati alla ripresa. Microsoft gestisce il ciclo di vita dell’ambiente e il provisioning delle risorse, mentre lo sviluppatore controlla il codice dell’agente e può scegliere il framework con cui realizzarlo.
Il passaggio diventa ancora più evidente con gli agenti always-on. OpenAI Dots, basati su GPT-6 Astra, dispongono ciascuno di un proprio computer nel cloud e possono continuare a lavorare sugli obiettivi dell’utente nel tempo.
Ogni dot può utilizzare browser e strumenti collegati, lavorare continuativamente e delegare parti del compito a subagenti. Attraverso l’ecosistema dei plugin può inoltre collegarsi a oltre 4.000 applicazioni e utilizzare gli strumenti necessari per svolgere le attività assegnate.
Dots non è una piattaforma infrastrutturale concorrente di Volcano: è un prodotto agentico destinato all’utente finale. Mostra però il lato applicativo dello stesso cambiamento. Se un agente deve operare continuativamente, utilizzare software e riprendere attività nel tempo, deve disporre di risorse che vadano oltre la sola inferenza.
AgentCore e Foundry espongono questo livello direttamente agli sviluppatori; Dots lo incorpora in un prodotto già pronto all’uso. Volcano appartiene al primo gruppo, ma amplia ulteriormente il perimetro.
Kong affianca infatti al compute PostgreSQL, autenticazione, storage, realtime, hosting frontend, observability e primitive di coordinamento, avvicinando Volcano a una piattaforma applicativa completa.
Si sta così delineando uno stack nel quale il modello fornisce le capacità di reasoning, framework e SDK organizzano logica e strumenti, mentre un ulteriore livello gestisce esecuzione, stato e servizi applicativi.
L’infrastruttura semplifica l’esecuzione, non la scelta di cosa affidare agli agenti
La diffusione di queste piattaforme riduce una parte consistente della complessità tecnica. Non risolve però la questione più importante per le imprese: quali processi conviene effettivamente trasformare in workflow agentici e quale rapporto esiste tra autonomia, costo e valore prodotto.
Un’analisi Gartner pubblicata nel settembre 2026, basata su 107 deployment di agentic AI, individua nella specializzazione uno dei principali discriminanti economici. Gartner prevede che entro il 2028 l’80% del ROI tangibile dell’agentic AI proverrà da agenti specializzati e specifici per dominio, anziché da agenti general purpose.
La maggiore facilità di implementazione non rende quindi automaticamente conveniente assegnare a un agente un processo ampio o scarsamente definito. La selezione del caso d’uso e la delimitazione del compito diventano parte della progettazione economica oltre che tecnica.
Anche il costo del compute e dei modelli va valutato sul workflow completo. Nell’analisi sull’“Inference Paradox”, Gartner prevede che il costo di inferenza per workflow agentico aumenti di oltre cinque volte entro il 2028. La riduzione del prezzo unitario dell’inferenza viene assorbita dalla maggiore complessità delle applicazioni, che utilizzano sequenze più lunghe, più token e più passaggi di reasoning.
Usare il modello più capace e il massimo livello di autonomia per ogni attività può quindi produrre un costo sproporzionato rispetto al valore ottenuto. Un’architettura agentica deve anche decidere quali passaggi affidare a un agente, quali a modelli più piccoli e quali continuare a eseguire attraverso software deterministico.
McKinsey affronta lo stesso problema partendo dalla unit economics dei workflow agentici. Il parametro proposto non è il prezzo del singolo agente o della singola inferenza, ma il fully loaded cost necessario a completare un’attività end-to-end combinando agenti, sistemi deterministici e persone.
In un caso di customer service bancario analizzato da McKinsey, per esempio, i token rappresentano soltanto il 20-25% dei costi variabili, mentre la supervisione umana arriva al 70-75%. Un workflow può inoltre coinvolgere più agenti e sistemi tradizionali insieme a diversi gruppi di persone incaricati della verifica e della gestione delle eccezioni.
La convenienza dipende quindi dal volume delle operazioni, dalla loro ripetibilità, dal costo delle eccezioni, dal grado di supervisione necessario e dalla possibilità di riutilizzare gli stessi componenti su più processi. Cambiando prezzi e capacità dei modelli, può inoltre cambiare nel tempo anche il punto nel quale l’automazione agentica diventa economicamente preferibile.
Il collo di bottiglia si sposta così dalla realizzazione tecnica alla scelta del processo: stabilire quale parte richieda realmente autonomia e se il valore generato superi il costo complessivo di compute, modelli, integrazione, supervisione e governance.
Kong estende la propria strategia oltre la connettività
Volcano è progettato per integrarsi con Kong Konnect, senza sostituire il livello di connettività e governance già sviluppato dall’azienda.
La separazione dei ruoli è significativa. Con AI Gateway e Agent Gateway, Kong sta costruendo l’infrastruttura attraverso la quale imprese e sviluppatori possono controllare il traffico verso modelli, API, strumenti MCP e altri agenti. Volcano aggiunge invece l’ambiente nel quale possono vivere codice, stato, workflow e servizi applicativi.
La strategia AI Connectivity annunciata da Kong all’inizio del 2026 puntava già a un livello comune di governance per API, eventi, chiamate agli LLM, connessioni MCP e comunicazioni agent-to-agent. Volcano estende ora questa architettura verso il compute e il backend delle applicazioni che generano quel traffico.
Per Kong significa passare dal controllo dei collegamenti tra i componenti dell’AI stack a una presenza anche nel livello sul quale una parte di quei componenti viene effettivamente eseguita.
Da Volcano SDK alla nuova piattaforma infrastrutturale
Il nome Volcano riprende quello di un precedente progetto Kong annunciato nel 2025, ma il perimetro si è ampliato in modo sostanziale. Il Volcano SDK era stato sviluppato per ridurre il codice necessario a orchestrare modelli e strumenti e operava quindi soprattutto sul livello della logica agentica.
La nuova piattaforma Volcano si sposta invece sull’infrastruttura applicativa: fornisce i servizi sui quali possono essere eseguiti agenti e applicazioni, indipendentemente dal framework utilizzato per costruirne la logica.
L’evoluzione riflette anche l’ampliamento del problema affrontato. L’orchestrazione stabilisce come un agente ragiona, chiama strumenti e combina diversi passaggi; la piattaforma deve garantire che quel processo possa continuare a operare, mantenere stato, utilizzare dati e interagire con utenti e altri servizi.
Disponibilità e prezzi partono dal piano gratuito
Volcano è già disponibile con un piano Hobby gratuito e un piano Superagent destinato agli ambienti di produzione.
Hobby comprende fino a 100.000 richieste mensili condivise tra funzioni e frontend, 100.000 eventi realtime, 512 MB di storage e 1 GB di database, oltre a quote specifiche per le durable functions.
Superagent parte da 17 dollari al mese con pagamento annuale, include 1.000 crediti mensili e aumenta i limiti per compute, durable functions, database, realtime e storage. Aggiunge inoltre funzionalità come geofencing, scheduler e custom domain. È previsto anche un livello Enterprise con SLA e capacità personalizzate.
Con Volcano, Kong entra quindi in uno spazio nel quale tendono a sovrapporsi categorie finora distinte: agent runtime, backend as a service e piattaforma cloud applicativa. Il punto non è più soltanto rendere possibile l’esecuzione di un agente, ma capire dove questa architettura produca un vantaggio sufficiente a giustificarne costi e complessità.