Inception ha presentato Mercury 3, un nuovo modello linguistico basato sulla diffusione che raggiunge 1.068 token al secondo sulle GPU NVIDIA, con una velocità di generazione dichiarata da quattro a otto volte superiore a quella di modelli ottimizzati per la risposta rapida come GPT-6 Luna di OpenAI e Claude Haiku 5.5 di Anthropic.
Mercury 3 utilizza un’architettura alternativa alla generazione autoregressiva adottata dalla maggior parte degli LLM commerciali: anziché produrre il testo un token alla volta, elabora e perfeziona più token contemporaneamente. Questa capacità di generazione parallela riduce i tempi di inferenza e può migliorare l’efficienza delle applicazioni nelle quali il modello deve rispondere rapidamente o eseguire numerose operazioni consecutive.
La nuova versione dispone di una finestra di contesto da un milione di token, rispetto ai 260.000 di Mercury 2.5, e ottiene risultati competitivi nei benchmark di ragionamento, programmazione e utilizzo degli strumenti esterni.
Inception, la startup fondata da tre ricercatori universitari
Con sede a Palo Alto, in California, Inception è stata fondata nel 2024 da Stefano Ermon, italiano laureato all’Università di Padova e docente di Informatica a Stanford, insieme ad Aditya Grover della UCLA e Volodymyr Kuleshov della Cornell University.
La startup, guidata da Ermon, ha raccolto 50 milioni di dollari di finanziamenti da investitori che comprendono Menlo Ventures, Mayfield, NVentures di NVIDIA, M12 di Microsoft, Snowflake Ventures e Databricks Investment.
L’attività di ricerca dei fondatori si concentra sui diffusion language model (dLLM), che applicano alla generazione di testo e codice principi già utilizzati nell’intelligenza artificiale per produrre immagini e video. In questi sistemi, il modello parte da una sequenza di token mascherati e la perfeziona progressivamente, potendo elaborare più posizioni in parallelo anziché seguire l’ordine sequenziale degli LLM tradizionali.
Questa differenza architetturale costituisce la base tecnologica della famiglia Mercury, introdotta commercialmente nel febbraio 2025.
Come funziona la generazione del testo attraverso la diffusione
Gli LLM autoregressivi producono il testo attraverso una successione di predizioni: ogni nuovo token dipende da quelli generati in precedenza. Sebbene i calcoli necessari per determinare ciascun token possano sfruttare il parallelismo delle GPU, la dipendenza tra le successive predizioni impone un’elaborazione sequenziale durante la generazione.
Nei modelli a diffusione, invece, il processo comincia da una rappresentazione iniziale incompleta del testo, che viene trasformata attraverso una serie di passaggi di raffinamento. A ogni iterazione, il sistema può aggiornare contemporaneamente più token, sfruttando il parallelismo anche nella fase di generazione.
La diffusione, quindi, non consiste semplicemente nel produrre una prima risposta e correggerla successivamente, ma costituisce il meccanismo con il quale il modello costruisce il testo. Nel caso degli LLM basati su token discreti, il processo utilizza tipicamente sequenze mascherate che vengono progressivamente completate.
Il vantaggio rispetto all’approccio autoregressivo dipende dal numero di iterazioni necessarie, dall’efficienza dell’implementazione e dalle caratteristiche dell’hardware. La generazione parallela può ridurre sensibilmente la latenza, ma richiede che il modello riesca a produrre risposte accurate attraverso un numero contenuto di passaggi.
Inception aveva già applicato questa tecnologia alla prima generazione di Mercury, dimostrando la possibilità di raggiungere velocità superiori ai 1.000 token al secondo. La principale questione ancora aperta riguardava la scalabilità dell’architettura, cioè la possibilità di aumentare le dimensioni del modello e affrontare attività più complesse mantenendo elevata la velocità.
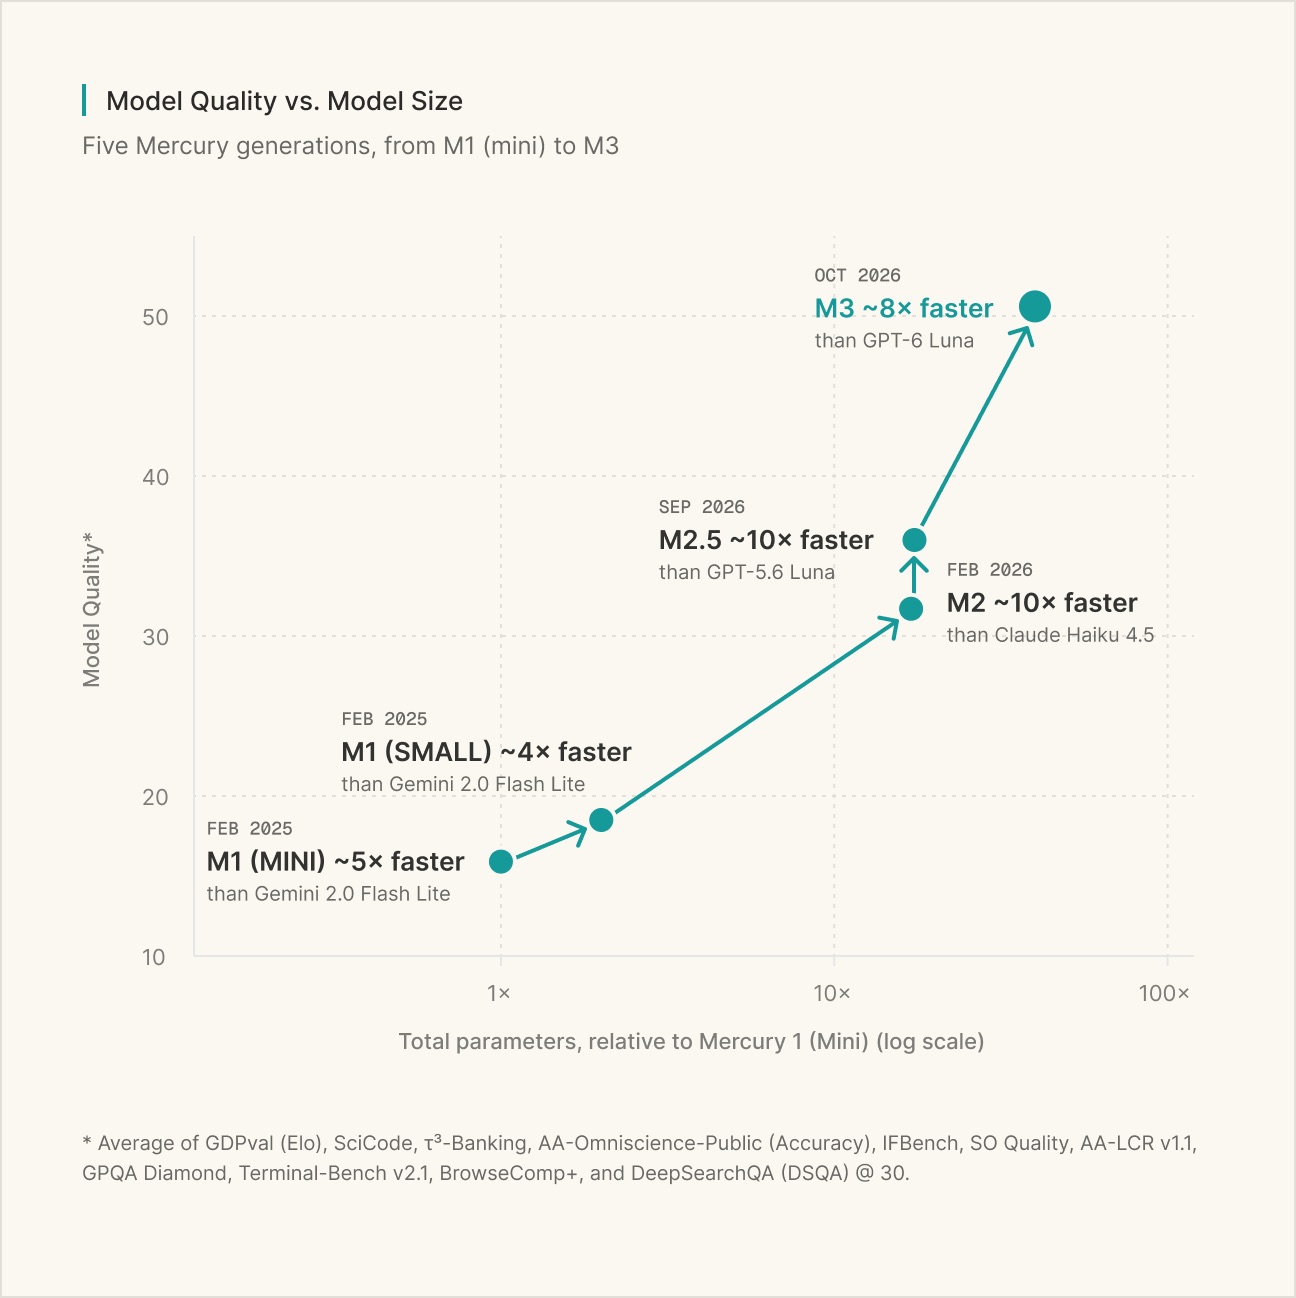
Mercury 3 ha oltre 40 volte i parametri della prima generazione
Mercury 3 dispone di un numero complessivo di parametri oltre 40 volte superiore a quello di Mercury 1, pur mantenendo una velocità di generazione comparabile.
Inception non ha comunicato il numero assoluto dei parametri, ma dichiara che le prestazioni aggregate sui benchmark sono aumentate di circa tre volte rispetto a Mercury 1 mini.
La crescita delle capacità del modello senza un corrispondente rallentamento della generazione costituisce un risultato importante per i dLLM, perché suggerisce la possibilità di applicare anche a questa architettura principi di scaling analoghi a quelli che hanno guidato lo sviluppo dei sistemi autoregressivi.
Un modello capace di produrre testo molto rapidamente, ma limitato a operazioni semplici, avrebbe infatti un campo applicativo relativamente ristretto. Mercury 3 estende invece l’impiego della diffusione a ragionamento, programmazione, analisi di documenti e attività agentiche, mantenendo il throughput come principale elemento distintivo.
Mercury 3 a confronto con GPT-6 Luna e Claude Haiku 5.5
I benchmark pubblicati da Inception confrontano Mercury 3 con GPT-6 Luna e Claude Haiku 5.5, due modelli progettati per offrire un rapporto competitivo tra qualità delle risposte, latenza e costo.
Nelle dodici prove presentate, Mercury 3 ottiene il risultato migliore in otto, con vantaggi particolarmente significativi nel rispetto delle istruzioni, nella programmazione agentica e in alcune valutazioni di ragionamento.
Il modello di Inception supera entrambi i concorrenti in IFBench, utilizzato per verificare la capacità di rispettare istruzioni complesse, e in SWE-Bench Atlas, dedicato alla risoluzione di problemi di sviluppo software. Ottiene inoltre risultati superiori in GPQA Diamond, che misura la capacità di rispondere a domande scientifiche di livello avanzato.
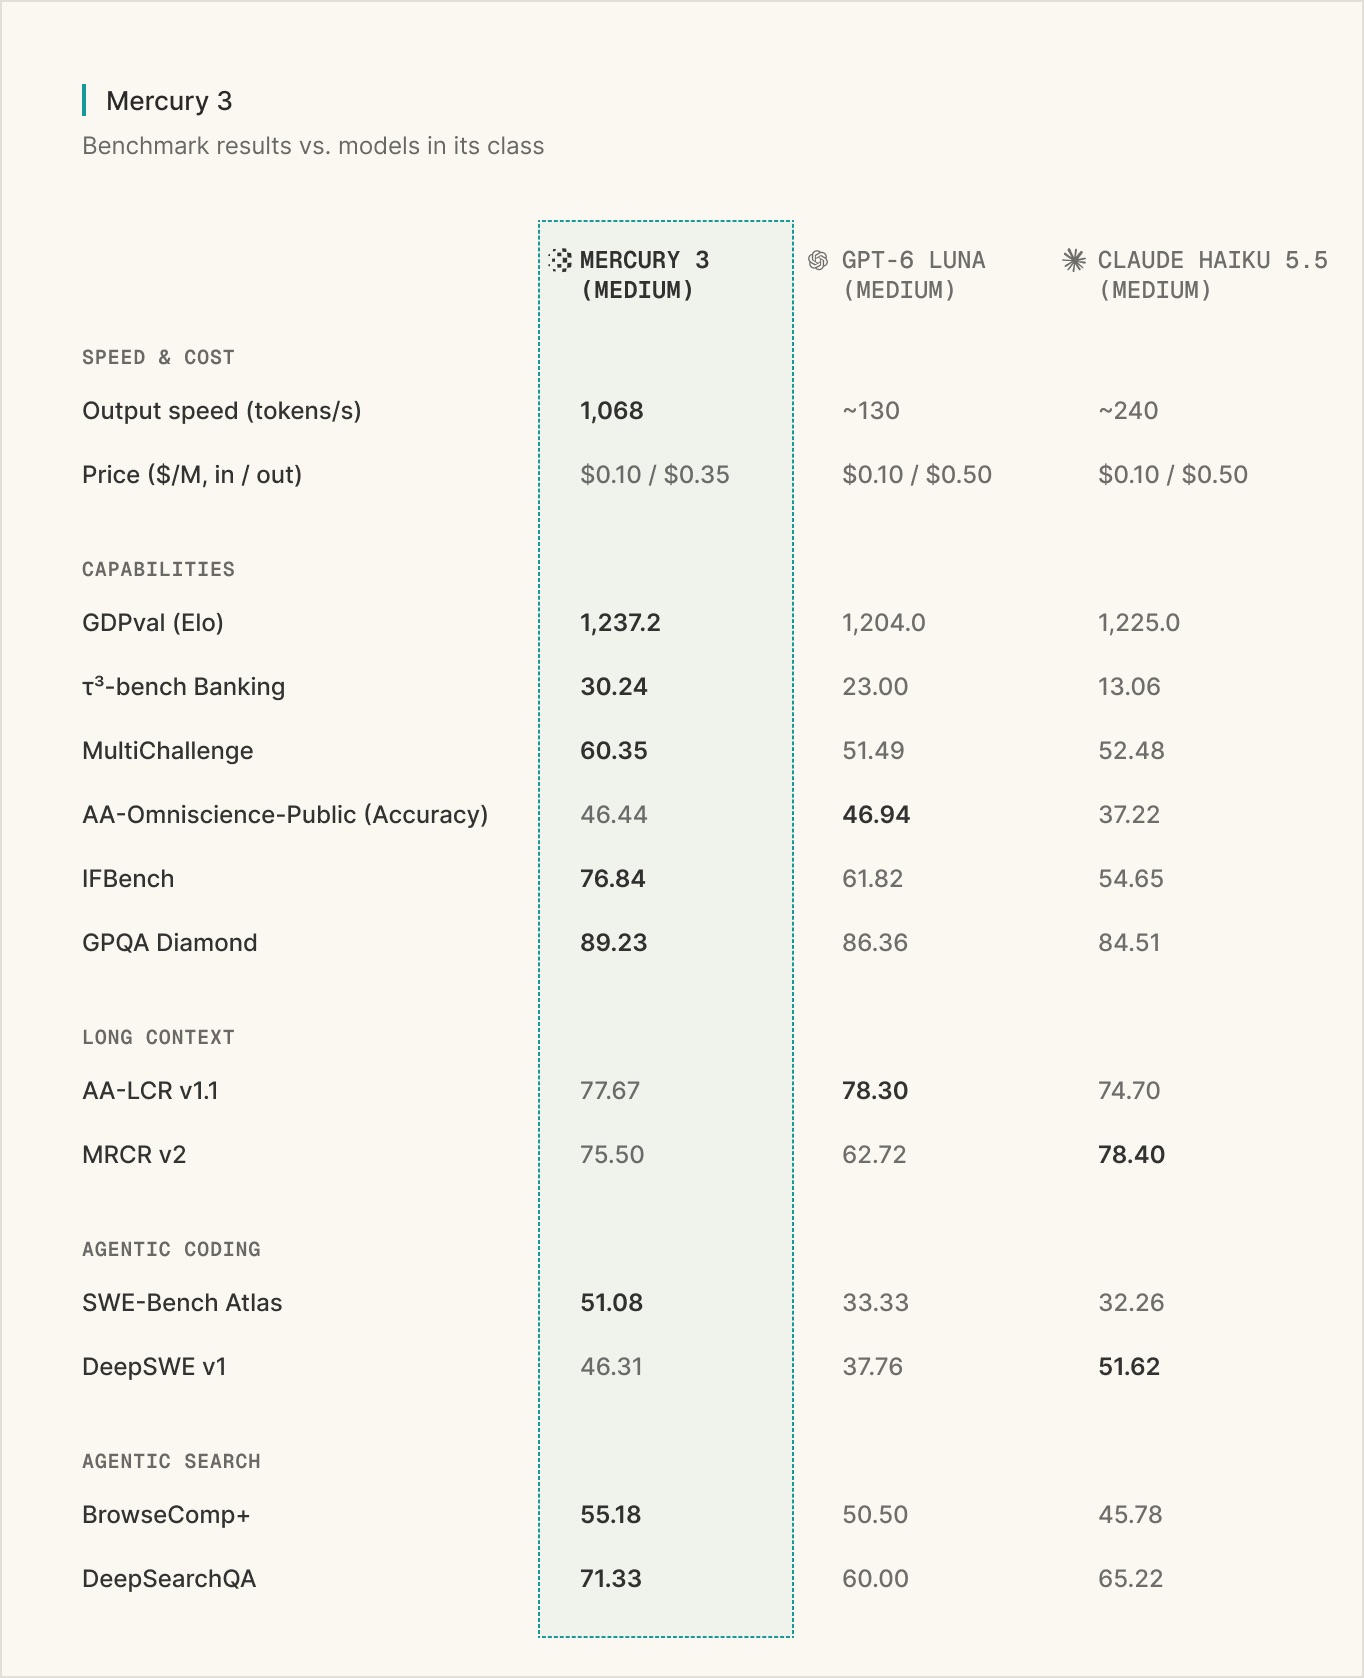
Il vantaggio non è uniforme. Claude Haiku 5.5 mantiene risultati migliori in DeepSWE, relativo ad attività di programmazione più articolate, e in MRCR v2, che valuta il recupero delle informazioni all’interno di contesti lunghi. GPT-6 Luna supera Mercury 3 in alcune prove di conoscenza e ragionamento su contesti estesi.
Il confronto sulla velocità è particolarmente netto: Mercury 3 raggiunge 1.068 token al secondo, contro circa 240 di Claude Haiku 5.5 e 130 di GPT-6 Luna, secondo le misurazioni pubblicate da Inception.
Si tratta tuttavia di risultati ottenuti dal produttore con specifiche configurazioni di esecuzione, che richiedono conferme attraverso benchmark indipendenti. Il throughput misura inoltre la velocità con cui vengono generati i token, mentre il tempo necessario per completare una richiesta dipende anche dall’elaborazione del prompt, dalla latenza iniziale e dalle eventuali operazioni esterne.
Gli agenti AI possono ridurre il tempo necessario per completare le attività
Gli agenti AI che utilizzano browser, API e strumenti esterni eseguono spesso sequenze articolate di operazioni. Il modello interpreta lo stato dell’applicazione, decide l’azione successiva, interagisce con uno strumento, analizza il risultato e ripete il procedimento fino a completare il compito.
In questi workflow, anche differenze relativamente contenute nei tempi di inferenza possono accumularsi lungo decine di passaggi consecutivi.
Nei test condotti da Inception su 50 attività di navigazione web basate su Mind2Web, Mercury 3 ha completato correttamente il 50% dei compiti, superando GPT-6.1-Sol nelle condizioni sperimentali adottate.
Il confronto è stato effettuato mantenendo invariati il numero di passaggi dell’agente e il volume di token utilizzati. Secondo Inception, il modello ha raggiunto il risultato con un costo per token sensibilmente inferiore.
La riduzione della latenza può consentire agli agenti di completare più rapidamente le attività oppure di effettuare verifiche e tentativi aggiuntivi entro lo stesso intervallo di tempo. Il beneficio effettivo dipende anche dalla velocità delle applicazioni esterne, perché le richieste a siti web e servizi API possono rappresentare una parte rilevante della durata complessiva del processo.
Le prime applicazioni nella formazione, nella ricerca e nell’assistenza clienti
Alcuni partner di Inception hanno già adottato Mercury 3 per applicazioni nelle quali la rapidità delle risposte incide direttamente sull’esperienza dell’utente.
TinyFish AI utilizza il modello per agenti che navigano sul web, raccolgono informazioni e completano attività attraverso più siti e strumenti.
Nella formazione, RevisionDojo, piattaforma educativa sviluppata da General Learning, lo impiega per fornire suggerimenti, correzioni e spiegazioni durante le sessioni di studio. Michael Tong, cofondatore e CTO della società, riferisce che il tempo necessario per ottenere un feedback è sceso a circa un secondo, mantenendo una qualità paragonabile o superiore a quella dei modelli precedentemente utilizzati.
La compatibilità con le API esistenti ha inoltre permesso di sostituire il modello senza modificare sostanzialmente l’architettura dell’applicazione.
Octen AI ha sperimentato Mercury 3 nelle applicazioni di ricerca destinate anche agli smart glasses, dove una risposta che richiede diversi secondi compromette la naturalezza dell’interazione.
Nei test condotti attraverso la propria Sense API, Octen ha misurato una mediana di 0,9 secondi per la generazione e di 2,2 secondi per l’intera risposta, comprese le altre operazioni della pipeline. La ricerca iniziale richiedeva circa 80 millisecondi, mentre l’elaborazione del modello linguistico rappresentava la componente più onerosa in termini di tempo.
Nell’assistenza clienti, Lorikeet ha valutato Mercury 3 per agenti conversazionali attivi attraverso voce, chat ed email, anche per organizzazioni soggette a requisiti normativi stringenti. Nei test preliminari, l’azienda ha rilevato miglioramenti sia nella latenza sia nelle valutazioni di qualità rispetto ai modelli precedentemente impiegati.
Mercury Voice e Mercury Decide per applicazioni specializzate
Inception ha sviluppato anche due modelli specializzati per esigenze applicative differenti.
Mercury Voice è ottimizzato per le interazioni vocali in tempo reale, nelle quali assume particolare importanza il time to first answer token (TTFAT), ovvero il tempo necessario prima che il modello inizi a generare la risposta.
Ridurre questo intervallo permette di limitare le pause durante una conversazione e di rendere più naturale l’interazione con un assistente vocale. Mercury Voice è già utilizzato da Audivi AI, Altur e OpenCall.
Mercury Decide è invece destinato alle attività di classificazione ad alto volume, nelle quali occorre elaborare rapidamente grandi quantità di richieste e assegnarle a categorie definite. Inception dichiara risultati superiori a quelli di Jev nei benchmark JevBench e LegalBench.
La disponibilità di modelli specializzati permette agli sviluppatori di selezionare tecnologie differenti in funzione delle caratteristiche del processo, riservando i modelli generalisti alle attività che richiedono capacità più ampie.
Disponibilità, integrazione API e prezzi di Mercury 3
Mercury 3 è disponibile attraverso la piattaforma API di Inception e i servizi OpenRouter, Baseten e Vercel.
Le API compatibili con OpenAI consentono agli sviluppatori di utilizzare Mercury 3 nelle applicazioni esistenti mantenendo le interfacce di comunicazione già adottate, mentre la chat di Inception permette di sperimentare direttamente il modello.
Il listino prevede 0,20 dollari per milione di token in ingresso e 0,70 dollari per milione di token in uscita. Durante il periodo promozionale di lancio, i prezzi sono dimezzati rispettivamente a 0,10 e 0,35 dollari, con uno sconto del 90% sui token in ingresso recuperati dalla cache.
Inception mette inoltre a disposizione 100 milioni di token gratuiti per sperimentare le API.
Per le organizzazioni che richiedono infrastrutture dedicate sono previste capacità di calcolo riservate, scalabilità automatica, controlli di conformità e politiche configurabili per la conservazione dei dati.
La diffusione amplia le alternative per lo sviluppo delle applicazioni AI
La generazione autoregressiva ha dominato lo sviluppo degli LLM grazie alla qualità raggiunta, alla maturità degli strumenti software e agli investimenti nelle infrastrutture di addestramento e inferenza. La sua natura sequenziale continua però a imporre vincoli alla velocità di generazione, particolarmente evidenti nelle applicazioni interattive.
L’evoluzione di Mercury dimostra che le architetture a diffusione possono raggiungere capacità competitive anche in attività complesse, offrendo un diverso rapporto tra qualità, latenza e risorse computazionali.
Per le aziende che sviluppano applicazioni AI, questa diversificazione tecnologica rafforza l’importanza di architetture software indipendenti dal singolo LLM, capaci di selezionare e sostituire i modelli in funzione delle caratteristiche richieste da ciascuna attività.
Un sistema agentico può, per esempio, affidare a un modello particolarmente rapido le interazioni frequenti e le operazioni meno complesse, riservando modelli più onerosi alle decisioni che richiedono ragionamenti approfonditi. API compatibili e livelli di orchestrazione consentono di adottare questa impostazione senza vincolare l’intera applicazione all’evoluzione tecnologica e commerciale di un unico fornitore.