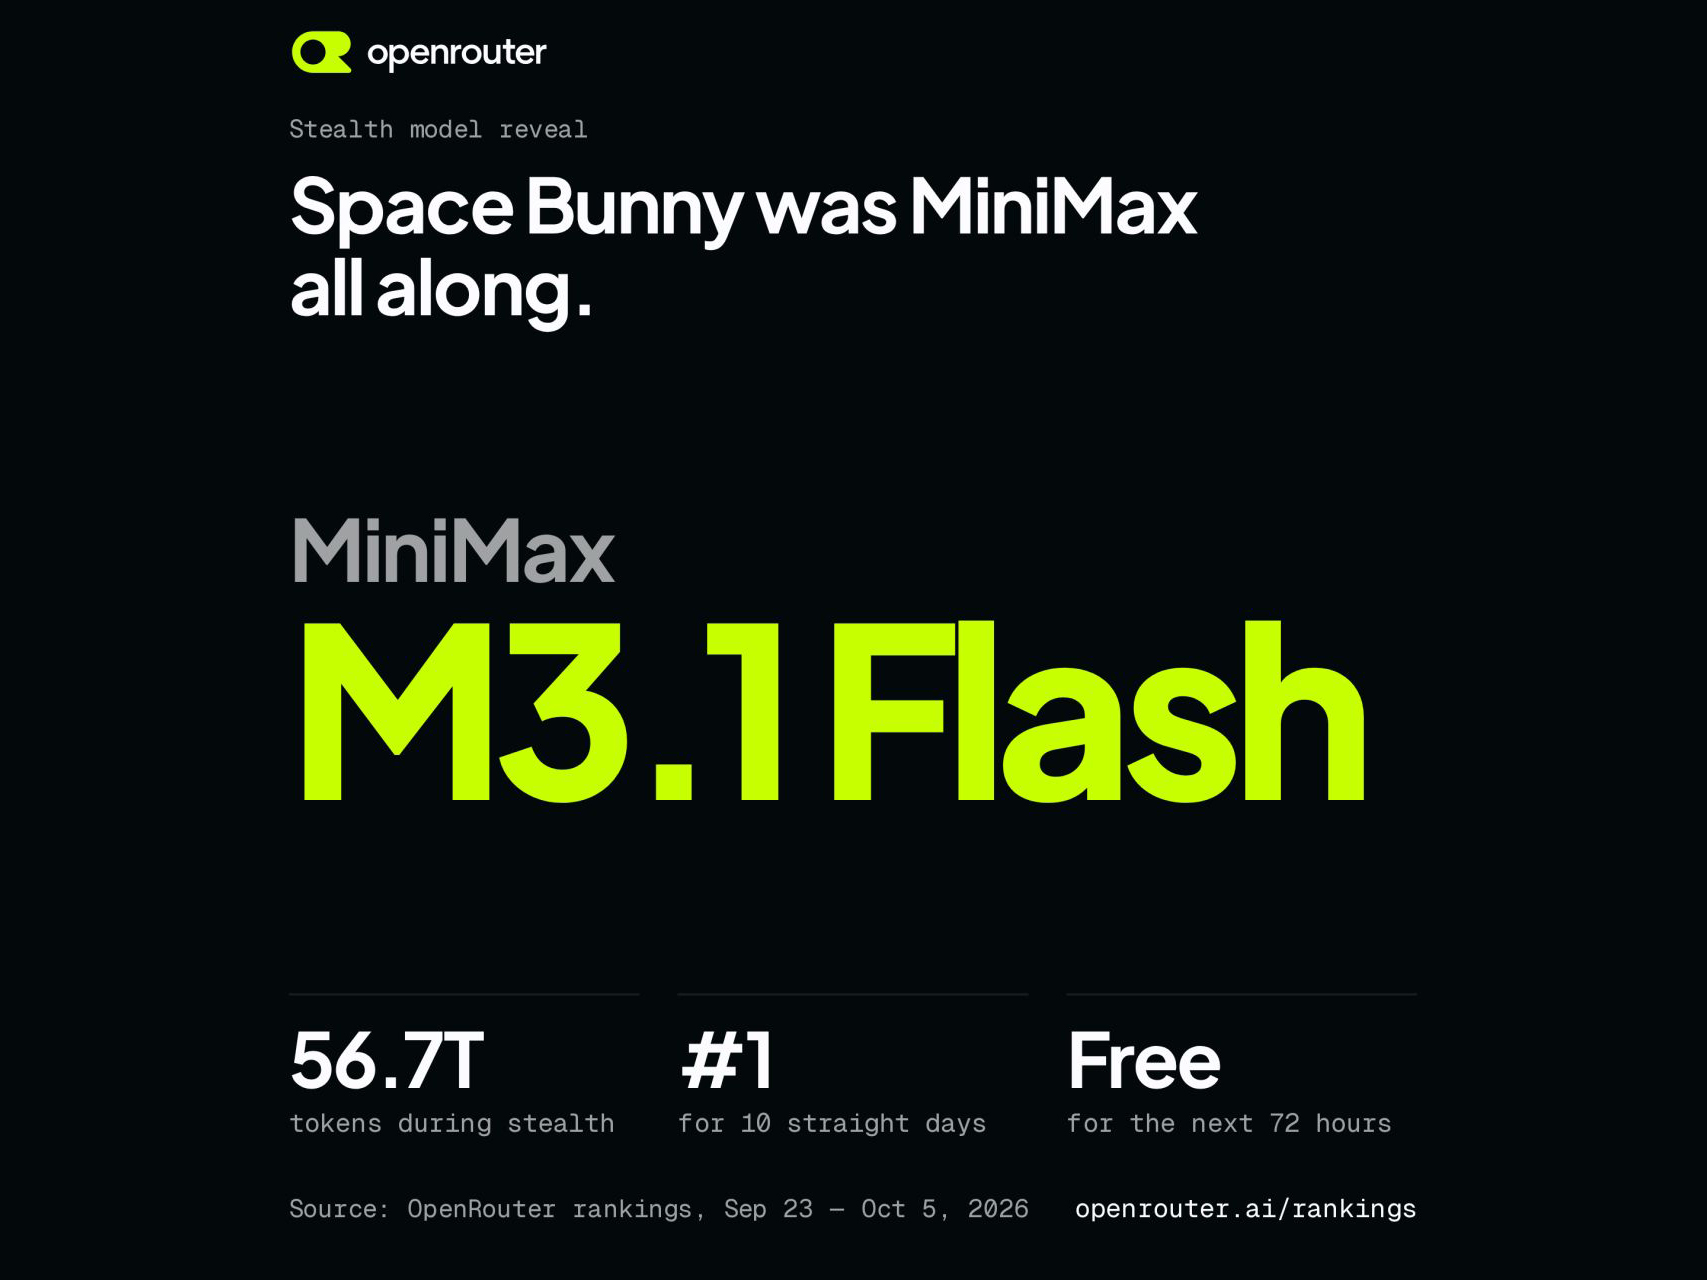
Completare un processo aziendale attraverso più applicazioni, sviluppare e verificare codice, operare sul computer e individuare vulnerabilità sono le attività al centro di MiniMax M3.1 Flash, il nuovo modello AI di MiniMax. L’aggiornamento migliora le capacità di pianificazione e di esecuzione di lunghe sequenze di operazioni, con un’inferenza online quasi tre volte più veloce e una riduzione del 70% del costo complessivo nei task agentici rispetto al modello precedente, secondo i dati dell’azienda. È già disponibile attraverso le API MiniMax, M Plan e MiniMax Code; i pesi saranno pubblicati successivamente.
A svilupparlo è MiniMax, azienda cinese di intelligenza artificiale con sede a Shanghai, fondata all’inizio del 2022 da Yan Junjie, già dirigente di SenseTime. La sua attività comprende modelli propri per testo, programmazione, immagini, video, voce e musica, disponibili attraverso applicazioni e API per imprese e sviluppatori. Tra i prodotti figurano MiniMax Code per lo sviluppo software e le attività degli agenti, Hailuo AI per la generazione video e Talkie per le conversazioni con personaggi virtuali.
Una versione preliminare di M3.1 Flash era già disponibile gratuitamente con il nome Space Bunny Alpha su OpenRouter, il gateway per l’accesso ai modelli AI per il quale Stripe ha annunciato un accordo di acquisizione. OpenRouter riunisce centinaia di modelli accessibili attraverso un’unica API. Gli sviluppatori possono così integrare e confrontare modelli diversi nelle proprie applicazioni usando un’interfaccia comune. Il servizio gestisce inoltre l’instradamento delle richieste tra i fornitori che ospitano i modelli, con criteri di scelta legati a prezzo, velocità e disponibilità e il passaggio automatico a un altro fornitore in caso di problemi. Gli utenti potevano utilizzare Space Bunny senza sapere che fosse stato sviluppato da MiniMax. Durante questa fase Space Bunny aveva elaborato complessivamente oltre 200.000 miliardi di token, le unità in cui i modelli AI suddividono i contenuti da elaborare.
Automazione, programmazione e sicurezza: i risultati dei benchmark
Nell’automazione aziendale, il 62,8% su Automation-Bench v1.0.6 colloca M3.1 Flash davanti agli altri modelli del confronto pubblicato da MiniMax. Il test comprende processi reali che attraversano più applicazioni SaaS, dalle vendite al marketing, dalle operations all’assistenza clienti, fino a finanza e risorse umane. Su BankerToolBench, che richiede pianificazione su più passaggi, coerenza tra documenti, conformità finanziaria e chiamate concatenate agli strumenti, i 76,2 punti eguagliano Opus 5 e superano GPT-5.6 Sol, a 74,6.
Il 73,7% su DeepSWE v1.1 segnala prestazioni vicine a Opus 5 (74%) e GPT-5.6 Sol (73%), mentre DeepSeek V4.1 Flash-1017 raggiunge il 77%. Il benchmark richiede di comprendere il codice, sviluppare funzionalità, correggere problemi e verificare il lavoro con test, mettendo alla prova la capacità di sostenere lunghe sequenze di operazioni. Nell’uso del computer, OSWorld V2 misura l’esecuzione di compiti tra applicazioni e Agents’ Last Exam (ALE) considera attività professionali complesse: con 61,7 e 29,6 punti, M3.1 Flash risulta primo tra i modelli cinesi in entrambe le prove, ma resta sotto Opus 5 (70,6 e 32,2) e GPT-5.6 Sol (65,7 e 30,6).
Per la scoperta e la validazione delle vulnerabilità, l’82,2% su CyberGym si confronta con l’84,5% di GLM-5.3, l’83,6% di GPT-5.6 Sol e l’80% di Kimi-K3. Le valutazioni interne di MiniMax coprono inoltre revisione del codice, correzione delle vulnerabilità, penetration test, analisi del malware e reverse engineering. Completano il quadro le prove di gestione del contesto e di capacità generali, tra cui BabyVision con strumenti e HLE senza strumenti.
| Benchmark | MiniMax M3.1 Flash | DeepSeek V4.1 Flash-1017 | DeepSeek V4.1 Flash | Kimi-K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
| Automation-Bench v1.0.6 | 62,8 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| BankerToolBench | 76,2 | — | 73,7 | 69,1 | 74,5 | 74,6 | 76,2 |
| GDP pdf AA | 20,8 | — | 12,8 | 22,0 | 11,2 | 27,2 | 21,6 |
| Terminal Bench 4.0 | 38,1 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| LOCA-Bench 256K | 60,3 | — | — | 49,7 | 50,3 | 60,0 | 53,7 |
| Agents’ Last Exam | 29,6 | — | — | 28,3 | — | 30,6 | 32,2 |
| OSWorld 2.0 | 61,7 | — | 54,3 | 58,3 | — | 65,7 | 70,6 |
| PostTrain Bench v1.1 | 39,3 | — | 30,5 | 36,6 | 37,5 | 36,2 | 40,4 |
| DeepSWE v1.1 | 73,7 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| NL2Repo-Bench | 61,2 | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| SWE Refactor Bench | 23,0 | — | 11,8 | 19,5 | 10,4 | 28,5 | 31,0 |
| CyberGym | 82,2 | — | — | 80,0 | 84,5 | 83,6 | — |
| BabyVision con strumenti | 91,0 | 92,5 | 89,6 | 85,7 | — | 88,9 | 94,1 |
| HLE senza strumenti | 43,4 | 44,0 | 39,2 | 43,5 | 42,3 | 49,5 | 55,6 |
| CharXiv RQ | 82,5 | — | 69,0 | 84,8 | — | 85,2 | 83,7 |
I risultati provengono dal confronto pubblicato da MiniMax e usano le scale dei rispettivi benchmark; il grassetto indica il valore più alto di ogni riga e il trattino un risultato non disponibile. I modelli e le versioni sono quelli inclusi nella tabella dell’azienda. Tra le condizioni principali, Automation-Bench comprende 600 task pubblici, DeepSWE utilizza mini SWE agent 2.4.5 con un contesto massimo di 512K token e CyberGym Claude Code 2.1.263 con un milione di token. ALE adotta l’insieme completo nell’impostazione ufficiale Overall, OSWorld la versione completa 0808 e HLE il sottoinsieme di 2.158 domande testuali: configurazioni e sottoinsiemi vanno mantenuti coerenti nei confronti.
Velocità, prezzi API e costo delle attività
L’aumento di efficienza deriva da un impiego più spinto della sparsità, cioè da meccanismi che selezionano le parti del calcolo da attivare. Nell’uso quotidiano l’output può superare 200 token al secondo, con una velocità mediana, o P50, stabilmente superiore a 170 token al secondo. Il token è l’unità in cui il modello suddivide ed elabora i contenuti; la mediana indica il valore centrale delle velocità osservate.
Il listino API internazionale prevede, per ogni milione di token, 0,15 dollari per l’input, 0,60 dollari per l’output e 0,015 dollari per l’input già presente in cache. Quest’ultima tariffa riguarda il riutilizzo di contenuti in ingresso conservati dal servizio.
Il costo di un’attività dipende anche dalla quantità di token e dalle operazioni necessarie a completarla. Nei grafici di MiniMax, il rapporto tra prestazioni e spesa viene quindi valutato su Automation-Bench, DeepSWE e ALE. Su Automation-Bench il punteggio passa dal 52,8% con livello di elaborazione low al 57,7% con medium, al 59,2% con high, al 61,2% con xhigh e al 62,8% con max. Su DeepSWE i livelli high, xhigh e max raggiungono rispettivamente il 68,1%, il 72,1% e il 73,7%.
Per ALE il grafico associa il 29,6% di attività superate a un costo totale stimato di 111 dollari sull’insieme di 152 task, usando Claude Code e il livello max. Si tratta del costo dell’intera valutazione, distinto dal costo medio per singolo task usato negli altri due grafici. Le comparazioni Automation-Bench e ALE fanno riferimento ai dati pubblici del 18 ottobre 2026; quella DeepSWE alla classifica del 22 settembre 2026, con conversione dei costi al cambio di un dollaro per 6,6862 yuan. Il grafico Automation-Bench utilizza Claude Code e, per DeepSeek V4.1 Flash-1017, tariffe di picco pari a 0,30 dollari per l’input, 1,20 per l’output e 0,006 per l’input in cache ogni milione di token; per gli altri modelli adotta i prezzi ufficiali.
Disponibilità e prossimi rilasci
M3.1 Flash è disponibile attraverso le API MiniMax, l’abbonamento M Plan e MiniMax Code, di cui è disponibile il client desktop. I pesi del modello saranno pubblicati successivamente. MiniMax ha inoltre anticipato una versione Pro orientata alle capacità più avanzate, mentre Flash rappresenta la linea dedicata all’equilibrio tra efficienza e capacità operative.