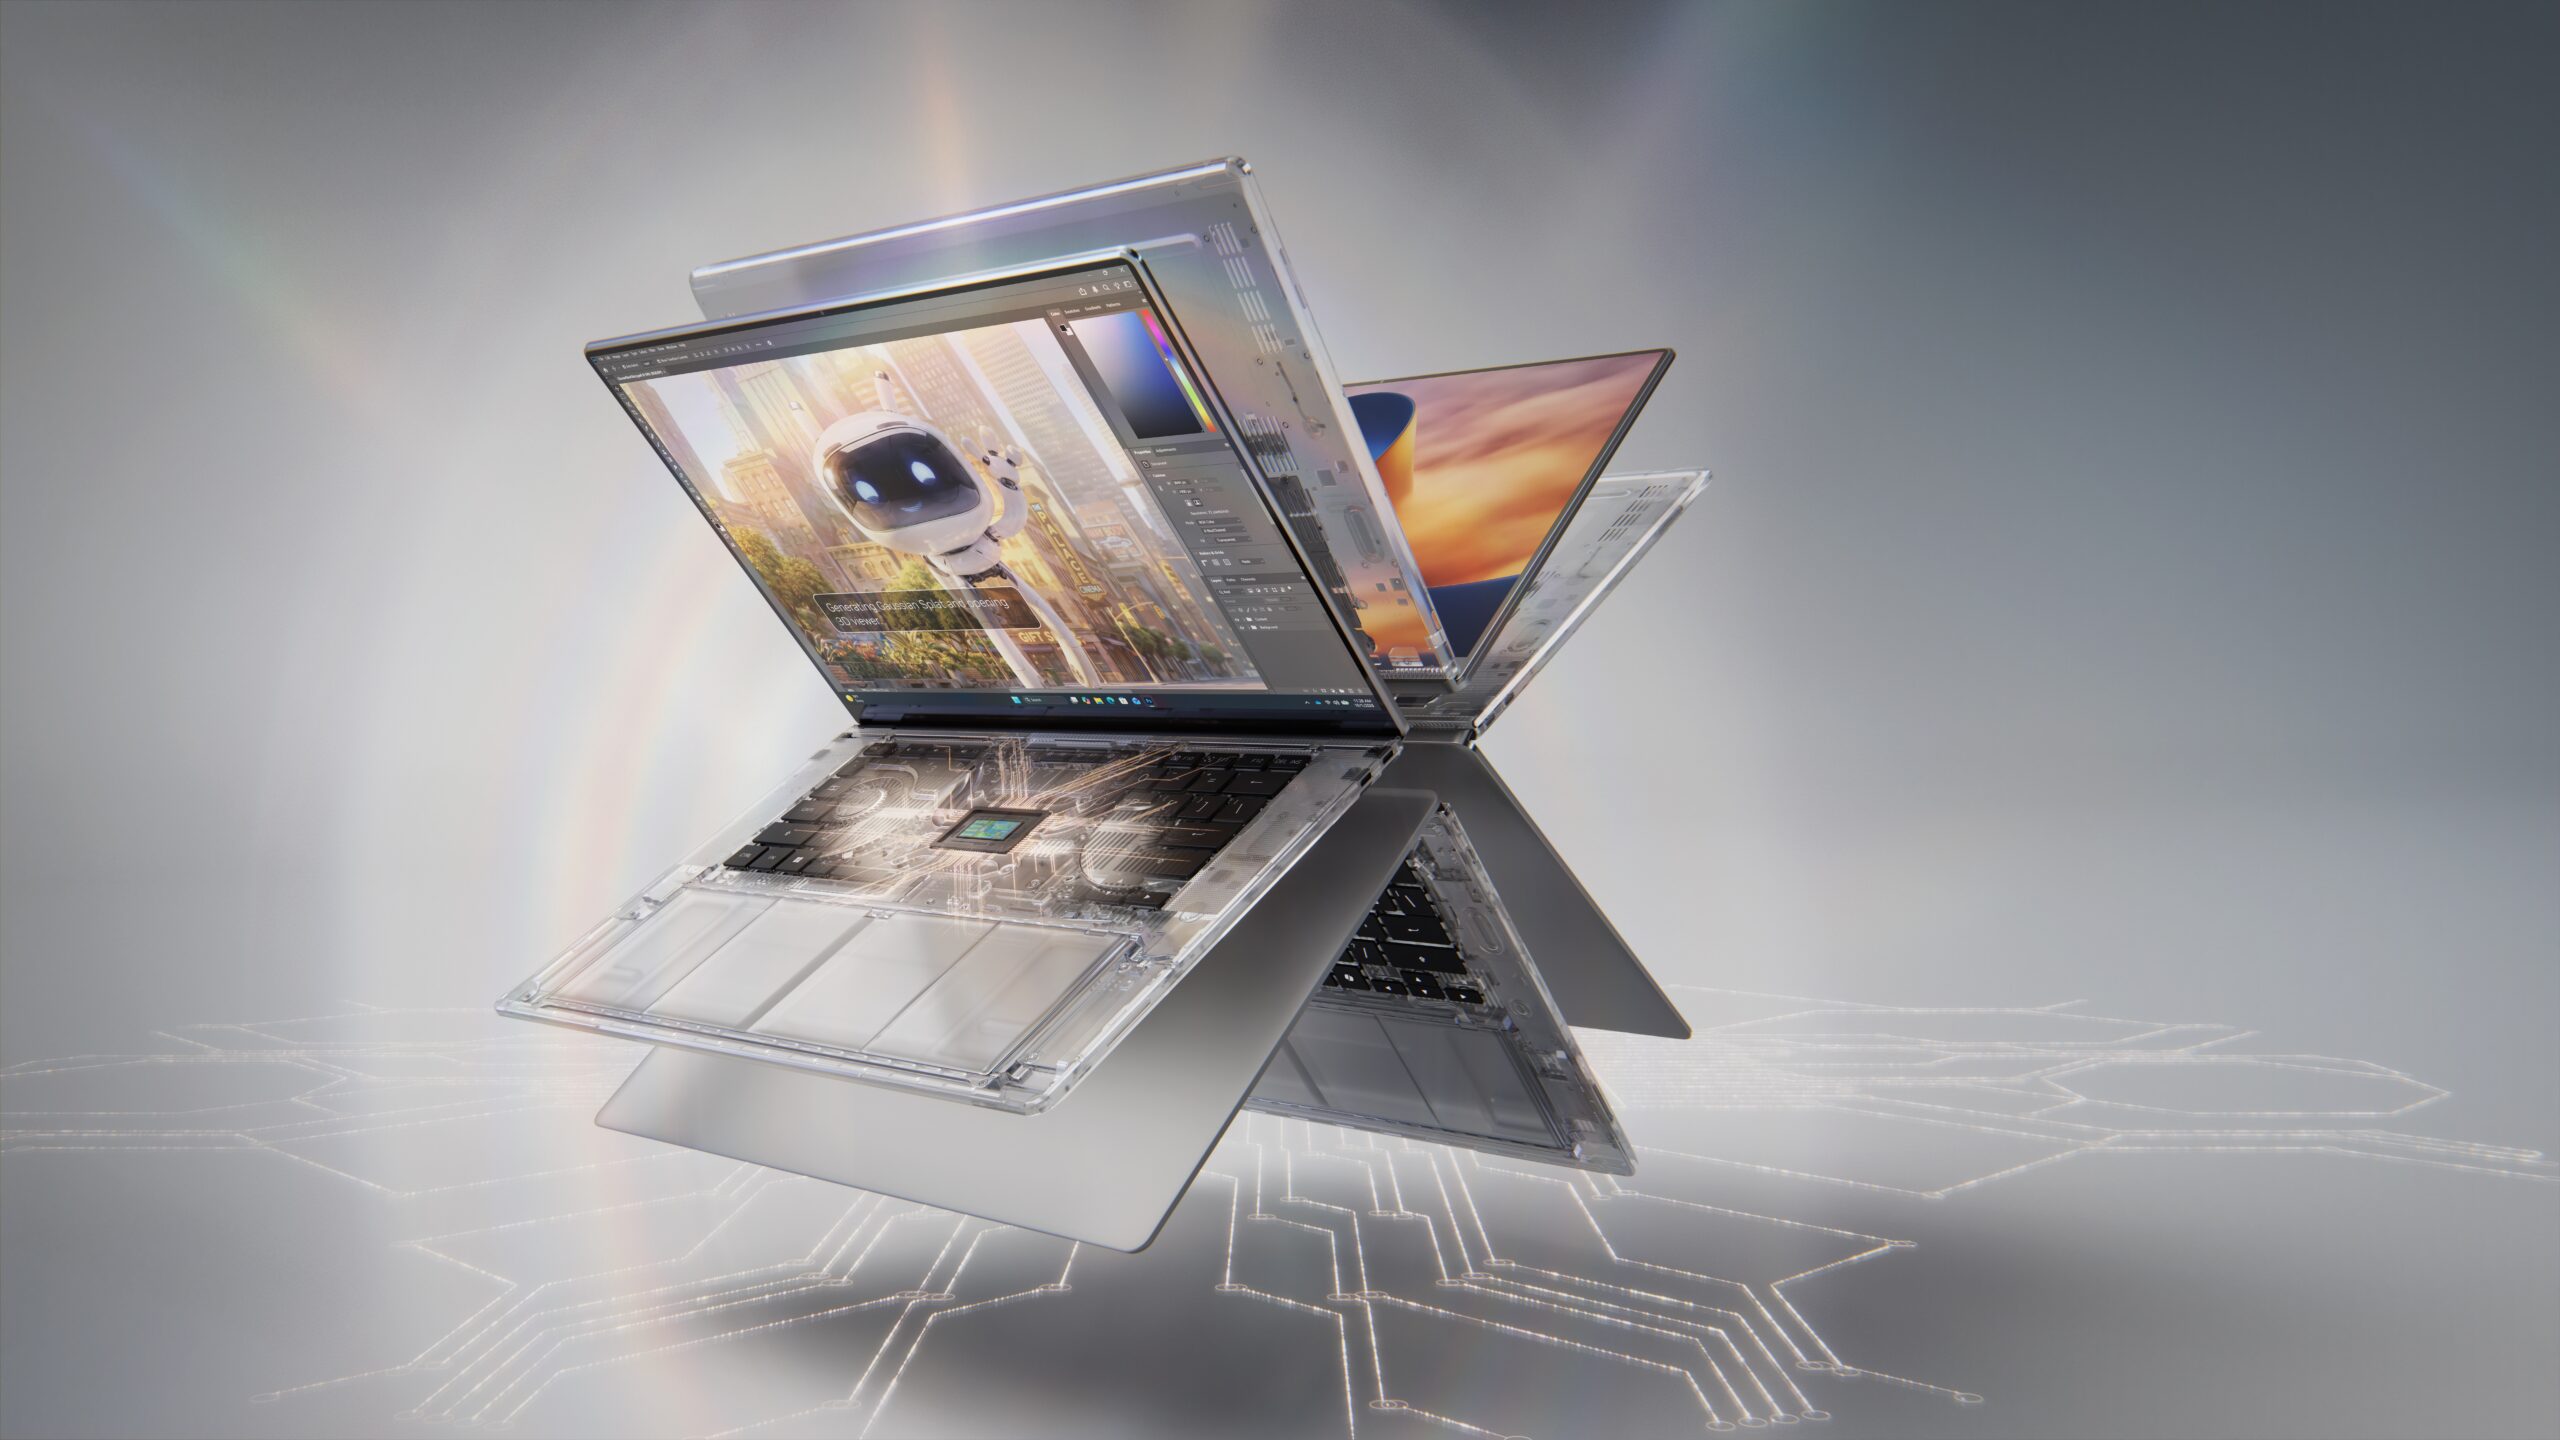
L’intelligenza artificiale eseguita direttamente sul computer, compresi i modelli linguistici di grandi dimensioni e gli agenti capaci di utilizzare applicazioni e strumenti software, è al centro della nuova generazione di PC Windows basati su NVIDIA RTX Spark, disponibili dal 16 ottobre attraverso ASUS, Dell, HP, Lenovo, Microsoft e MSI.
La piattaforma combina una CPU NVIDIA Grace e una GPU Blackwell RTX in un unico superchip, con una memoria unificata fino a 128 GB e una capacità di calcolo dichiarata di 1 petaflop nelle operazioni AI a precisione FP4. Questa dotazione permette di eseguire modelli normalmente associati a workstation specializzate, mantenendo le funzionalità grafiche e multimediali delle GPU RTX.
Con RTX Spark, NVIDIA estende ai notebook Windows l’impostazione architetturale già adottata con DGX Spark, affiancandovi il supporto alle applicazioni professionali, agli strumenti per la produzione di contenuti e ai videogiochi. La piattaforma beneficia inoltre del lavoro svolto insieme a Microsoft su CUDA nativo per Windows on Arm, sugli ambienti di esecuzione degli agenti autonomi e sulla distribuzione dell’inferenza tra computer locali e servizi cloud.
I primi sistemi partono da 2.599 dollari, con configurazioni e prezzi differenti a seconda del produttore e del mercato.
Grace e Blackwell RTX nello stesso chip, con 128 GB di memoria unificata
L’architettura di NVIDIA RTX Spark riunisce una CPU Grace basata su Arm e una GPU Blackwell RTX, collegate attraverso l’interconnessione NVLink-C2C. MediaTek ha collaborato alla progettazione della CPU, contribuendo all’ottimizzazione dei consumi, delle prestazioni e della connettività.
La GPU utilizza i Tensor Core di quinta generazione e raggiunge una capacità di calcolo di 1 petaflop in FP4, formato numerico a quattro bit impiegato per ridurre la quantità di memoria e le operazioni necessarie durante l’inferenza dei modelli quantizzati. Il dato indica il picco teorico raggiungibile in determinate condizioni di elaborazione, mentre le prestazioni effettive dipendono anche dalle caratteristiche del modello, dalla velocità della memoria e dal carico di lavoro.
La memoria LPDDR5X unificata, fino a 128 GB e accessibile sia alla CPU sia alla GPU, adotta un’impostazione architetturale già familiare agli utenti Apple, che la utilizzano nei Mac con chip della serie M fin dall’introduzione dell’M1 nel 2020. CPU e GPU condividono uno stesso spazio di memoria, superando la tradizionale separazione tra RAM di sistema e VRAM delle schede grafiche dedicate e riducendo la necessità di trasferire continuamente i dati tra le due componenti.
Per l’esecuzione dei modelli linguistici, che devono mantenere in memoria i propri parametri, la cache utilizzata per elaborare il contesto e le strutture necessarie alla generazione delle risposte, i 128 GB condivisi permettono di ospitare modelli sensibilmente più grandi rispetto a quelli che trovano spazio nella VRAM di una normale GPU per notebook, lasciando risorse disponibili anche per le applicazioni e gli strumenti richiamati dagli agenti.
La piattaforma comprende l’ecosistema di accelerazione NVIDIA, da CUDA e TensorRT alle tecnologie grafiche OptiX, DLSS, Reflex e G-SYNC, insieme alla codifica e decodifica video hardware. Le risorse di calcolo possono essere impiegate tanto per i carichi AI quanto per le applicazioni tradizionali, permettendo di utilizzare lo stesso computer per sviluppo software, produzione multimediale e attività quotidiane.
Nemotron 3.5 Bolt e i modelli linguistici eseguiti sul PC
Tra i modelli ottimizzati per RTX Spark figura NVIDIA Nemotron 3.5 Bolt 74B-A9B, basato su un’architettura mixture-of-experts (MoE) con 74 miliardi di parametri complessivi, dei quali circa 9 miliardi vengono attivati durante l’elaborazione di ciascun token.
Destinato soprattutto alle applicazioni agentiche, nelle quali la generazione del testo si accompagna alla selezione di strumenti, all’esecuzione di operazioni e alla pianificazione di attività articolate in più passaggi, Nemotron 3.5 Bolt è disponibile in una configurazione quantizzata a bassa precisione che occupa circa 24 GB di memoria, rendendone possibile l’esecuzione locale sui sistemi RTX Spark compatibili.
L’architettura MoE contribuisce a contenere il carico computazionale, poiché soltanto una parte dei parametri interviene in ciascuna fase dell’elaborazione, mentre la memoria deve comunque conservare i pesi degli esperti che possono essere richiamati. I 128 GB condivisi consentono quindi di ospitare modelli con un numero elevato di parametri complessivi, senza che tutti debbano essere elaborati simultaneamente.
La quantizzazione e la disponibilità di memoria permettono inoltre di eseguire più componenti AI contemporaneamente, per esempio un modello linguistico affiancato da sistemi di ricerca documentale, elaborazione delle immagini o riconoscimento vocale.
Gli sviluppatori possono utilizzare strumenti come llama.cpp, vLLM, Ollama e LM Studio, sfruttando l’accelerazione CUDA e le ottimizzazioni disponibili per le GPU NVIDIA.
Gli agenti AI personali e la distribuzione dell’inferenza tra più computer
NVIDIA ha collaborato con i partner software per predisporre procedure guidate che semplificano l’installazione e la configurazione di agenti come GitHub Copilot, Hermes, OpenClaw, Perplexity, Pi e WorkBuddy, riducendo la necessità di intervenire manualmente attraverso la riga di comando.
Gli agenti possono utilizzare modelli locali per elaborare documenti, codice e altre informazioni, richiamando applicazioni e strumenti esterni per automatizzare attività articolate in più operazioni consecutive.
Con NVIDIA PAIR, software open source compatibile con Windows, Linux e macOS, le risorse di inferenza possono essere condivise anche con altri dispositivi collegati alla rete locale. Un notebook RTX Spark può così elaborare le richieste provenienti da computer meno potenti, che accedono ai modelli attraverso la rete senza doverli eseguire direttamente.
PAIR individua le risorse disponibili, configura i motori di inferenza e indirizza le richieste, supportando llama.cpp e il download dei modelli da Hugging Face. Gli utenti possono quindi dedicare un computer all’esecuzione dei modelli AI e continuare a utilizzare gli altri dispositivi per le normali attività.
NVIDIA Switchyard, libreria open source per l’instradamento delle richieste, consente invece agli agenti di scegliere tra modelli locali e servizi cloud in funzione delle caratteristiche del compito.
La rapidità con cui evolvono le prestazioni degli LLM e le frequenti modifiche delle politiche tariffarie dei fornitori rendono sempre più importante separare il funzionamento delle applicazioni AI dalla scelta di uno specifico modello. Attraverso Switchyard, l’orchestrazione degli agenti può essere organizzata in modo da selezionare risorse differenti in base alla complessità delle richieste, alla latenza, ai costi e ai requisiti di riservatezza.
Le attività più frequenti possono essere affidate ai modelli locali, riservando il ricorso al cloud alle elaborazioni che richiedono capacità superiori o funzionalità specializzate. La possibilità di sostituire o affiancare modelli differenti permette inoltre di adattare le applicazioni all’evoluzione dell’offerta senza doverne modificare continuamente la logica di funzionamento.
OpenShell e Microsoft Execution Containers per controllare gli agenti
Gli agenti AI che operano direttamente sul PC possono accedere a documenti, applicazioni, credenziali e risorse di rete, eseguendo sequenze di istruzioni generate dinamicamente dai modelli linguistici. Il controllo delle autorizzazioni e l’isolamento dei processi diventano quindi necessari per limitarne l’accesso alle risorse del sistema.
NVIDIA e Microsoft hanno lavorato all’integrazione tra NVIDIA OpenShell e Microsoft Execution Containers, combinando ambienti di esecuzione isolati con meccanismi di gestione delle autorizzazioni degli agenti.
OpenShell offre controlli sulle credenziali, sui permessi e sulle operazioni eseguibili, mentre Microsoft Execution Containers sfrutta le funzionalità di isolamento di Windows per delimitare l’ambiente nel quale gli agenti possono operare.
Le due tecnologie consentono di applicare restrizioni granulari all’accesso ai file, alle applicazioni e alle connessioni di rete, contenendo i rischi associati all’esecuzione autonoma di operazioni potenzialmente sensibili.
GitHub Copilot e OpenClaw supportano già Microsoft Execution Containers, mentre per Hermes è prevista entro ottobre un’integrazione più completa con i controlli di OpenShell.
NVIDIA mette inoltre a disposizione componenti software che permettono agli agenti compatibili di utilizzare applicazioni e librerie come Broadcast, RTX Remix e Omniverse. Attraverso queste interfacce, un agente può modificare le impostazioni di elaborazione audio durante una trasmissione oppure applicare automaticamente effetti a una serie di registrazioni, sfruttando le funzionalità delle applicazioni NVIDIA.
CUDA e PyTorch nativi su Windows on Arm
RTX Spark amplia l’ecosistema di sviluppo AI su Windows on Arm, grazie al lavoro congiunto di NVIDIA e Microsoft per rendere disponibili strumenti finora utilizzati prevalentemente in ambienti Linux o Windows x86.
Tra le novità figurano PyTorch con supporto CUDA nativo per Windows on Arm, una distribuzione Python specifica per questa architettura e un installer Conda dedicato.
Secondo NVIDIA, il 97% dei 15.000 pacchetti Python più diffusi dispone già di versioni compatibili, facilitando il trasferimento su RTX Spark di applicazioni e flussi di lavoro esistenti.
Attraverso Windows Subsystem for Linux, gli sviluppatori possono inoltre utilizzare gli strumenti Linux abitualmente impiegati per l’addestramento e l’inferenza dei modelli, mantenendo Windows come sistema operativo principale e sfruttando le GPU attraverso CUDA.
Lo sviluppo, la verifica e l’esecuzione delle applicazioni AI possono così avvenire sullo stesso computer, con la possibilità di trasferire successivamente i carichi verso workstation RTX o infrastrutture GPU cloud.
Il progetto open source NVIDIA Skills fornisce inoltre agli agenti istruzioni e strumenti per utilizzare le librerie CUDA-X, consentendo loro di generare, ottimizzare e verificare codice accelerato dalle GPU attraverso funzionalità specializzate.
Adobe Photoshop, Premiere e le applicazioni creative
RTX Spark si rivolge anche ai professionisti della grafica, del video e della produzione tridimensionale, che possono utilizzare la memoria unificata per progetti di grandi dimensioni senza essere vincolati esclusivamente alla capacità della VRAM delle schede grafiche dedicate.
NVIDIA indica tra le possibilità della piattaforma l’elaborazione di video 8K con campionamento colore 4:2:2 e il rendering di scene 3D fino a 90 GB, operazioni che tradizionalmente richiedono workstation dotate di notevoli quantità di memoria grafica.
Adobe sta adattando Photoshop, Premiere e Substance 3D alla nuova architettura, sfruttando TensorRT per accelerare le funzionalità basate sull’intelligenza artificiale. In Premiere, le ottimizzazioni riguardano anche la riproduzione, il rendering, gli effetti e la correzione del colore, mentre Photoshop beneficia dell’accelerazione nelle operazioni di elaborazione e modifica delle immagini.
Le versioni beta di Photoshop e Premiere con supporto nativo a RTX Spark sono disponibili dal debutto dei nuovi sistemi, mentre gli aggiornamenti di Substance 3D arriveranno successivamente.
NVIDIA Broadcast 2.3 consente di applicare la rimozione del rumore di fondo e i profili vocali Studio Voice anche a registrazioni già esistenti, estendendo agli interventi di postproduzione le funzionalità finora utilizzate principalmente nelle comunicazioni e nelle trasmissioni in diretta.
Le nuove funzionalità RTX Video, disponibili inizialmente in beta, comprendono la super risoluzione fino a 4K e la generazione di fotogrammi intermedi. Attraverso i nodi RTX Video per ComfyUI, è possibile trasformare sequenze video generate dall’AI a 15 fotogrammi al secondo in contenuti a 60 fps e applicare la conversione HDR, effettuando le elaborazioni localmente.
L’accelerazione grafica Blackwell RTX comprende inoltre le tecnologie DLSS 5, ray tracing, G-SYNC e Reflex. NVIDIA dichiara prestazioni superiori a 100 fotogrammi al secondo a risoluzione 1440p nei videogiochi compatibili, sfruttando le tecnologie di rendering e generazione dei fotogrammi.
Tra i titoli supportati al debutto figurano Cyberpunk 2077, Fortnite, Gears of War: E-Day, Marvel Rivals, World of Warcraft e NBA 2K27, quest’ultimo con il supporto alla tecnologia 3D-Guided Neural Rendering di DLSS 5.
I primi notebook NVIDIA RTX Spark disponibili da ASUS, Dell, HP, Lenovo, Microsoft e MSI
La commercializzazione di RTX Spark inizia il 16 ottobre attraverso i siti dei produttori e i principali rivenditori internazionali, con una gamma di notebook destinati a sviluppatori, professionisti creativi e utenti che desiderano eseguire modelli AI localmente.
| Produttore | Modelli RTX Spark |
| ASUS | ProArt P14, ProArt P16 |
| Dell | XPS 16 |
| HP | OmniBook Ultra, OmniBook X 14 |
| Lenovo | Yoga Pro 9n |
| Microsoft | Surface Laptop Ultra |
| MSI | Prestige N16 Flip AI+, Prestige N16 |
Il prezzo di partenza comunicato da NVIDIA è di 2.599 dollari, con listini e configurazioni differenti a seconda dei mercati. Per l’Europa, il Surface Laptop Ultra for Business offre un primo riferimento commerciale: nello store Microsoft irlandese è proposto a partire da 3.259 euro.
RTX Spark condivide con NVIDIA DGX Spark l’architettura Grace-Blackwell e la memoria unificata, ma amplia il campo di utilizzo rispetto al sistema compatto progettato principalmente per lo sviluppo e l’inferenza AI in ambiente Linux. Grazie a Windows e alle tecnologie grafiche RTX, i nuovi notebook possono essere utilizzati anche per le applicazioni professionali, la produzione multimediale e i videogiochi.
La gamma DGX Spark si amplia a sua volta con una configurazione da 64 GB di memoria unificata, disponibile dal 23 ottobre attraverso Acer, ASUS, Dell, Gigabyte, HP e MSI.