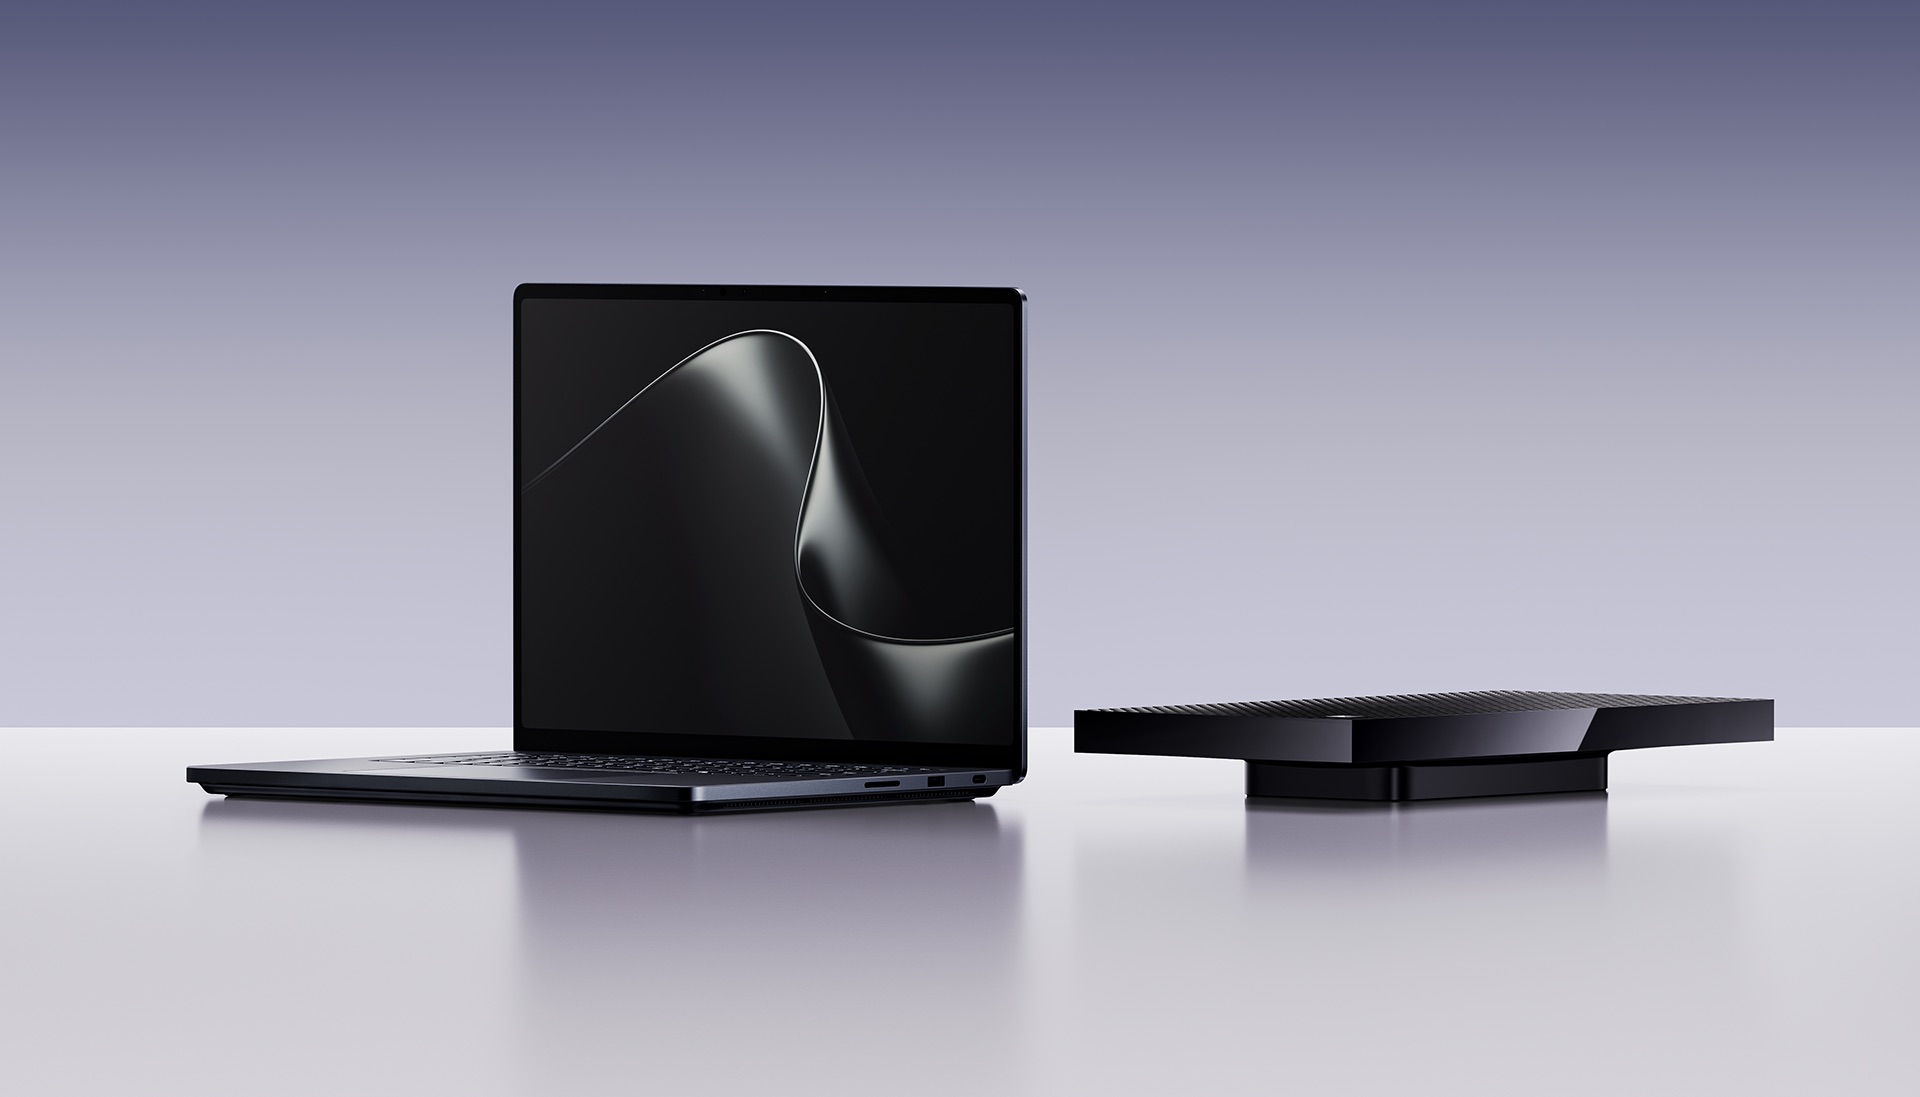
Con Surface Laptop Ultra, Microsoft inaugura una nuova generazione di portatili Windows basati sulla piattaforma NVIDIA RTX Spark, progettati per eseguire localmente modelli di intelligenza artificiale con oltre 120 miliardi di parametri. Il nuovo computer, sviluppato con NVIDIA a partire dal processore e disponibile con un massimo di 128 GB di memoria unificata, segna un’evoluzione importante per la famiglia Surface, finora caratterizzata dall’impiego di processori Intel, AMD e Qualcomm, e rappresenta il primo risultato commerciale di una collaborazione che estende l’architettura NVIDIA Grace Blackwell ai PC Windows.
Il progetto risale alla presentazione di RTX Spark del 31 maggio 2026, quando Microsoft e NVIDIA avevano anticipato una nuova categoria di computer destinati a sviluppatori, professionisti della creazione digitale e applicazioni agentiche. L’annuncio comprendeva già Surface Laptop Ultra e una famiglia di dispositivi di ASUS, Dell, HP, Lenovo e MSI, ma lasciava ancora aperti diversi dettagli commerciali.
Il 7 ottobre Microsoft ha comunicato configurazioni, prezzi e disponibilità dei nuovi Surface, inserendoli nella strategia Windows Hybrid Intelligence, che combina l’elaborazione locale con i servizi cloud e introduce nuovi meccanismi di sicurezza per gli agenti autonomi. Surface Laptop Ultra sarà disponibile dal 16 ottobre, con prezzi a partire da 2.599 dollari, mentre la configurazione con 128 GB di memoria raggiungerà 5.899 dollari.
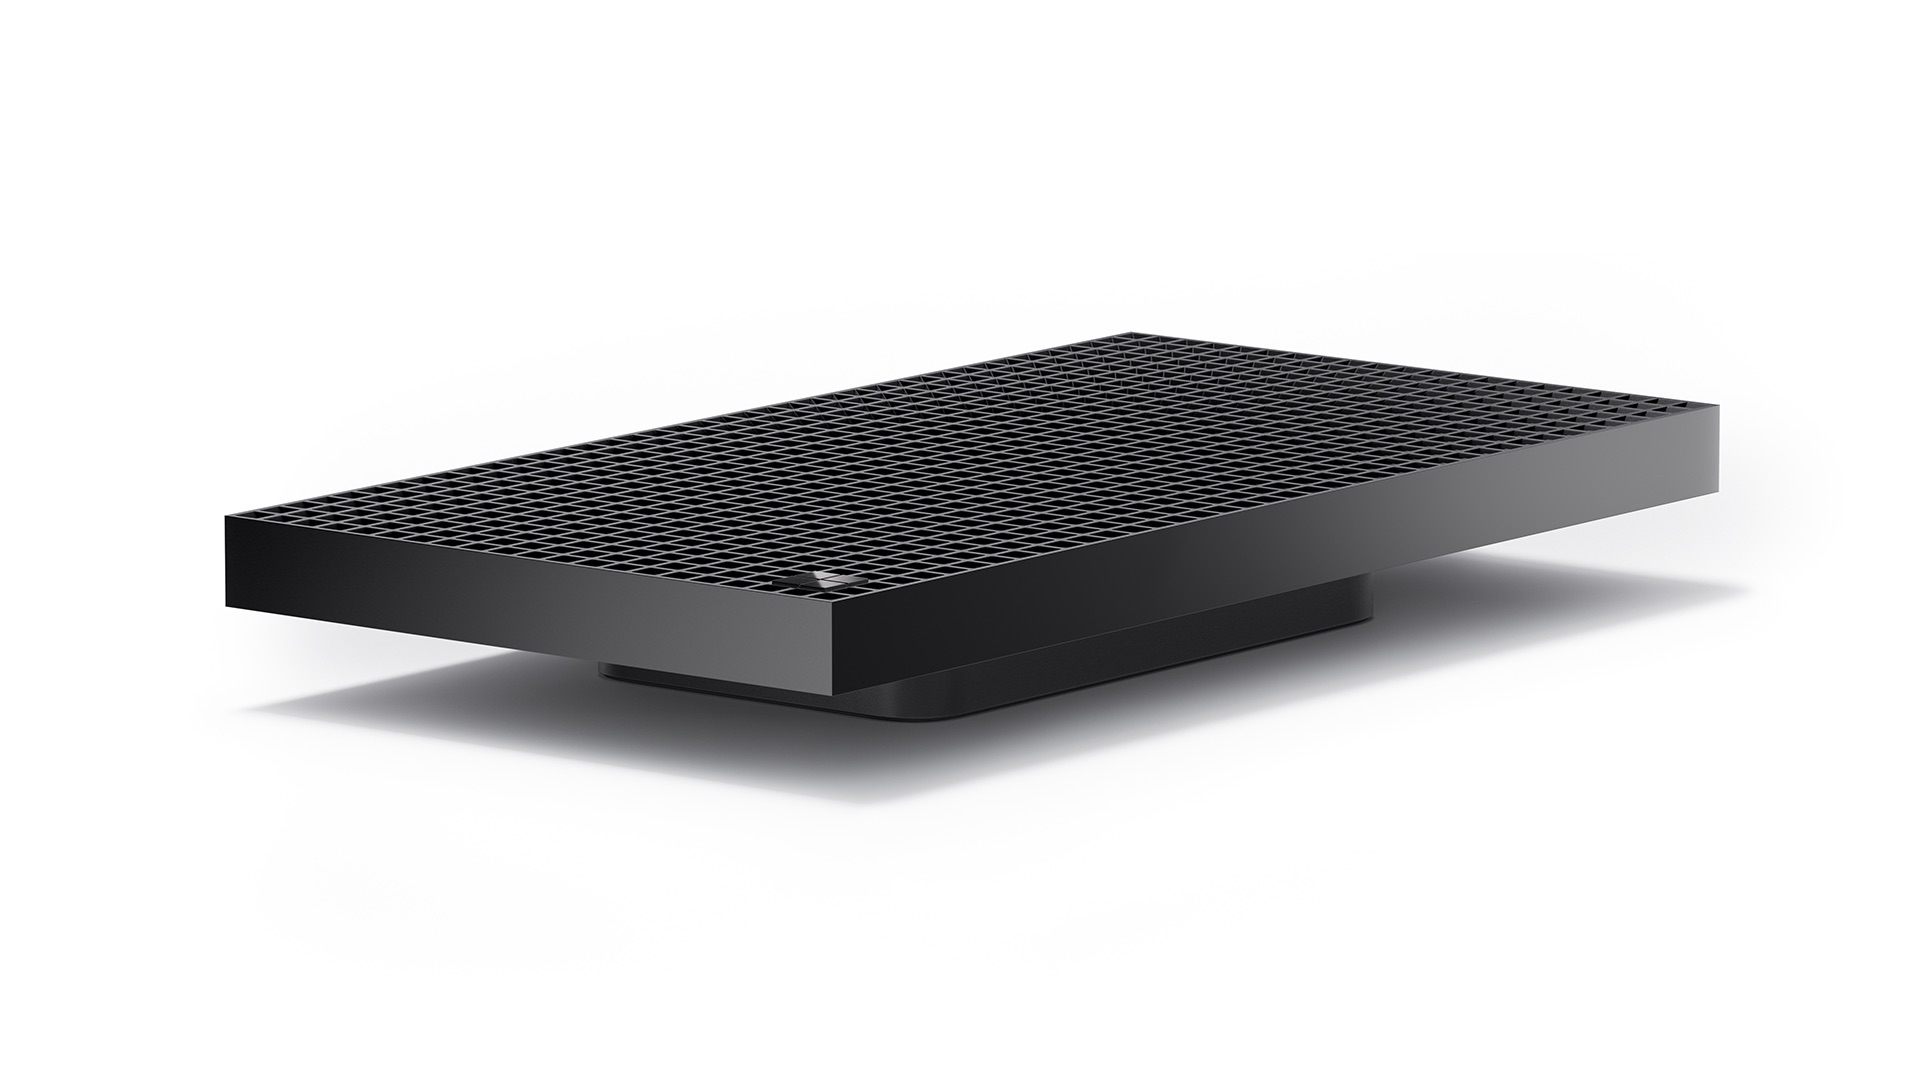
Accanto al portatile arriva Surface RTX Spark Dev Box, un computer desktop da 5.999 dollari destinato allo sviluppo AI, al quale si affiancheranno workstation basate su NVIDIA DGX Station, capaci di eseguire modelli fino a mille miliardi di parametri. È una gamma che copre esigenze differenti, dall’inferenza individuale ai sistemi condivisi da gruppi di sviluppatori e agenti AI.
Con RTX Spark, NVIDIA estende Grace Blackwell ai portatili Windows
RTX Spark combina una GPU NVIDIA Blackwell con un massimo di 6.144 core, una CPU Grace basata su architettura Arm con un massimo di 20 core e fino a 128 GB di memoria unificata, raggiungendo una capacità di calcolo AI di un petaflop nelle operazioni a precisione ridotta previste dalla piattaforma.
La differenza rispetto ai comuni portatili con GPU dedicata riguarda soprattutto l’organizzazione della memoria. Nei sistemi tradizionali, i modelli AI devono spesso essere caricati nella memoria video dell’acceleratore, la cui capacità è generalmente molto inferiore a quella della RAM di sistema. Se i pesi del modello e le strutture necessarie all’inferenza superano lo spazio disponibile, diventa necessario trasferire parte dei dati tra memoria video e RAM, con conseguenze sulle prestazioni.
L’architettura di RTX Spark consente invece alla CPU Grace e alla GPU Blackwell di accedere a uno spazio di memoria condiviso, permettendo di caricare modelli di grandi dimensioni senza dipendere esclusivamente dalla capacità della memoria video dedicata.
Per sfruttare questa architettura, Microsoft e NVIDIA hanno modificato diversi componenti di Windows, intervenendo sulla quantità di memoria di sistema accessibile dalla GPU, sulla gestione delle pagine di memoria condivisa e sulla distribuzione dei processi tra i core della CPU.
Il sistema operativo utilizza Workload Profile Scheduling (WPS) per assegnare i carichi di lavoro ai core Grace e Microsoft Power and Thermal Framework (MPTF) per gestire consumi e dissipazione termica, cercando di mantenere prestazioni sostenute durante le elaborazioni prolungate. NVIDIA ha inoltre integrato TensorRT nell’ambiente Windows ML, mentre gli sviluppatori possono utilizzare CUDA e gli strumenti di inferenza già diffusi nell’ecosistema NVIDIA.
Queste ottimizzazioni erano state anticipate a maggio, insieme agli interventi sull’emulatore Prism, necessario per eseguire sui processori Arm le applicazioni Windows compilate per architettura x86.
Surface Laptop Ultra nasce intorno al superchip NVIDIA
Microsoft ha sviluppato Surface Laptop Ultra partendo dalle caratteristiche di RTX Spark, con una progettazione congiunta che ha coinvolto componenti elettronici, struttura meccanica, sistema di raffreddamento e gestione dell’alimentazione.
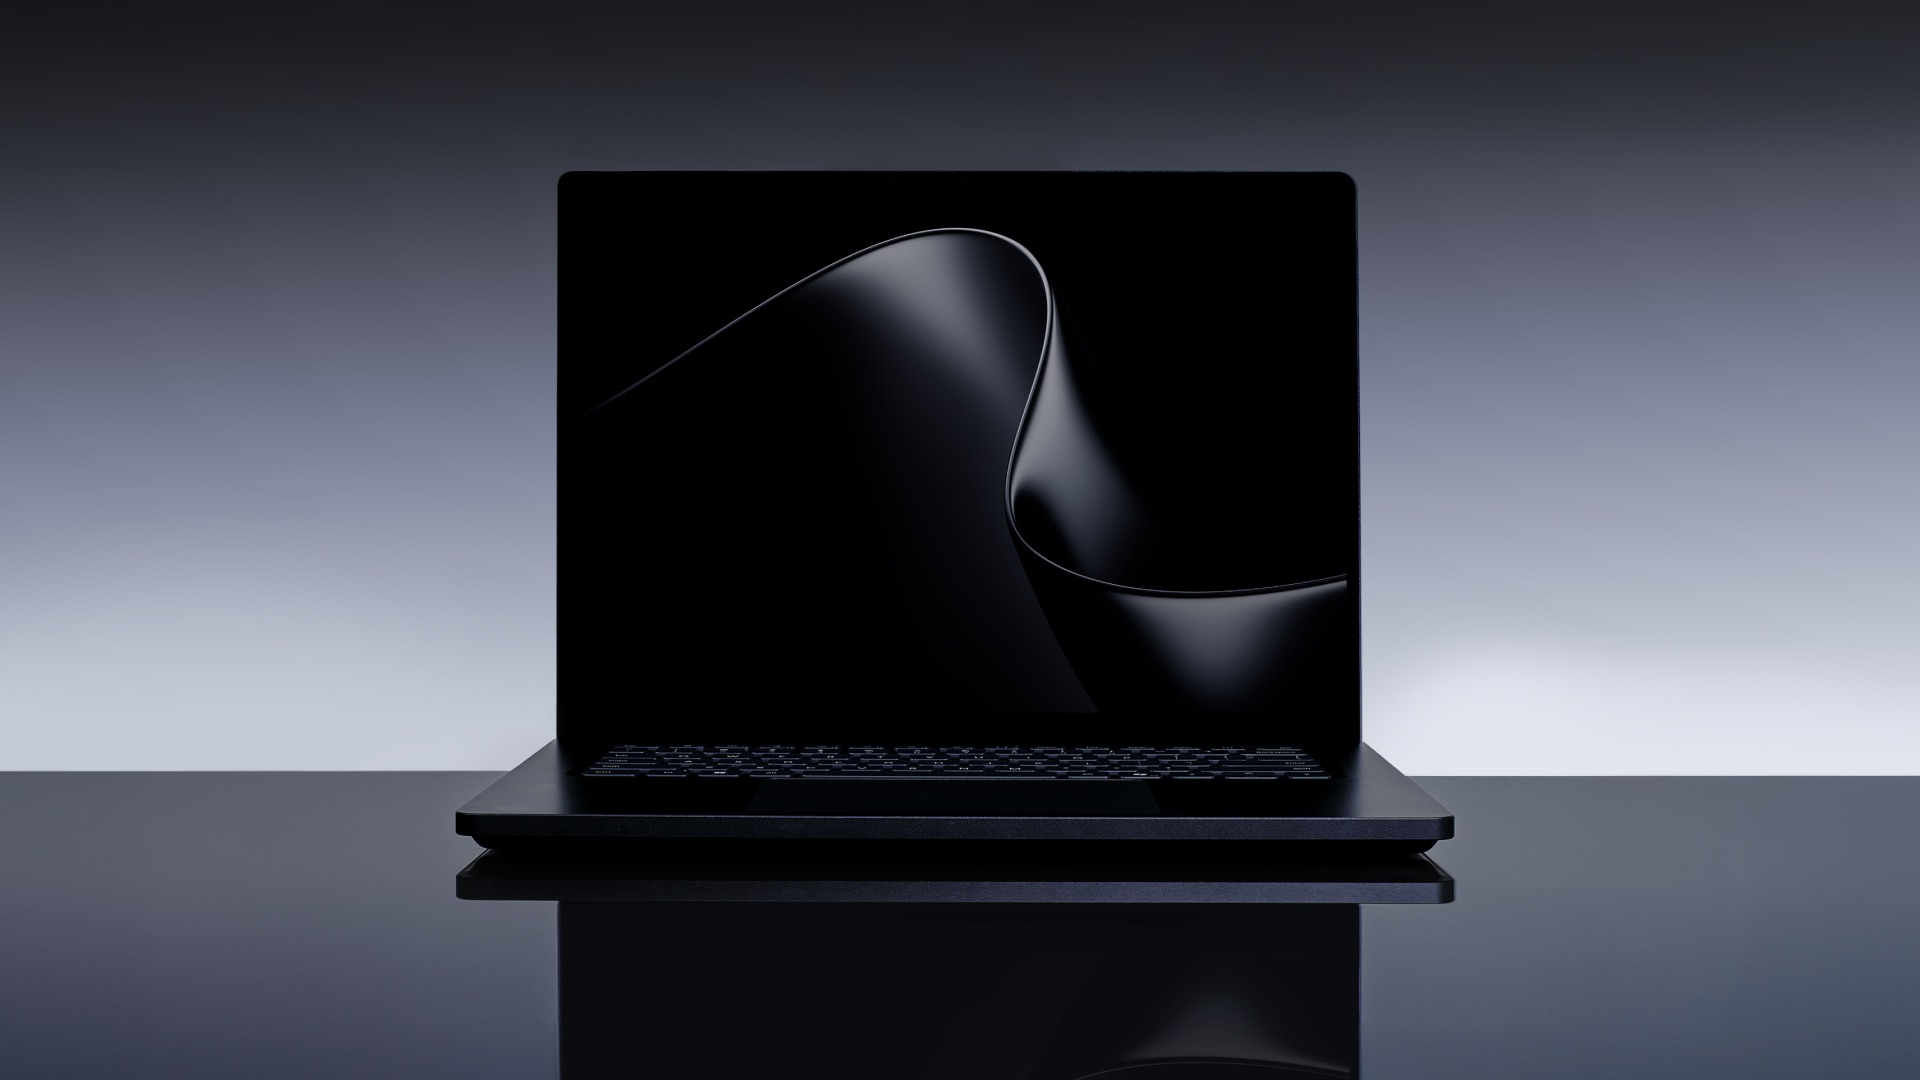
Il risultato è un portatile con display touchscreen PixelSense Ultra da 15 pollici, uno chassis spesso meno di 18 millimetri e un peso inferiore a 2,04 kg, progettato per sostenere carichi computazionali che nei notebook tradizionali possono essere limitati dalle temperature operative.
Il nuovo sistema termico offre, secondo Microsoft, una capacità di dissipazione fino a 2,5 volte superiore rispetto agli attuali Surface Laptop. Il dato assume particolare rilevanza nell’esecuzione degli agenti AI e dei modelli linguistici, perché le elaborazioni possono impegnare CPU, GPU e memoria per periodi prolungati, anziché produrre soltanto brevi picchi di attività.
Lo schermo supporta contenuti HDR e raggiunge una luminosità di picco che Microsoft indica come superiore del 25% a quella del MacBook Pro M5 utilizzato per il confronto. Il trackpad aptico è stato ampliato del 30% rispetto al Surface Laptop di ottava generazione, mentre l’unità di archiviazione è rimovibile e sostituibile.
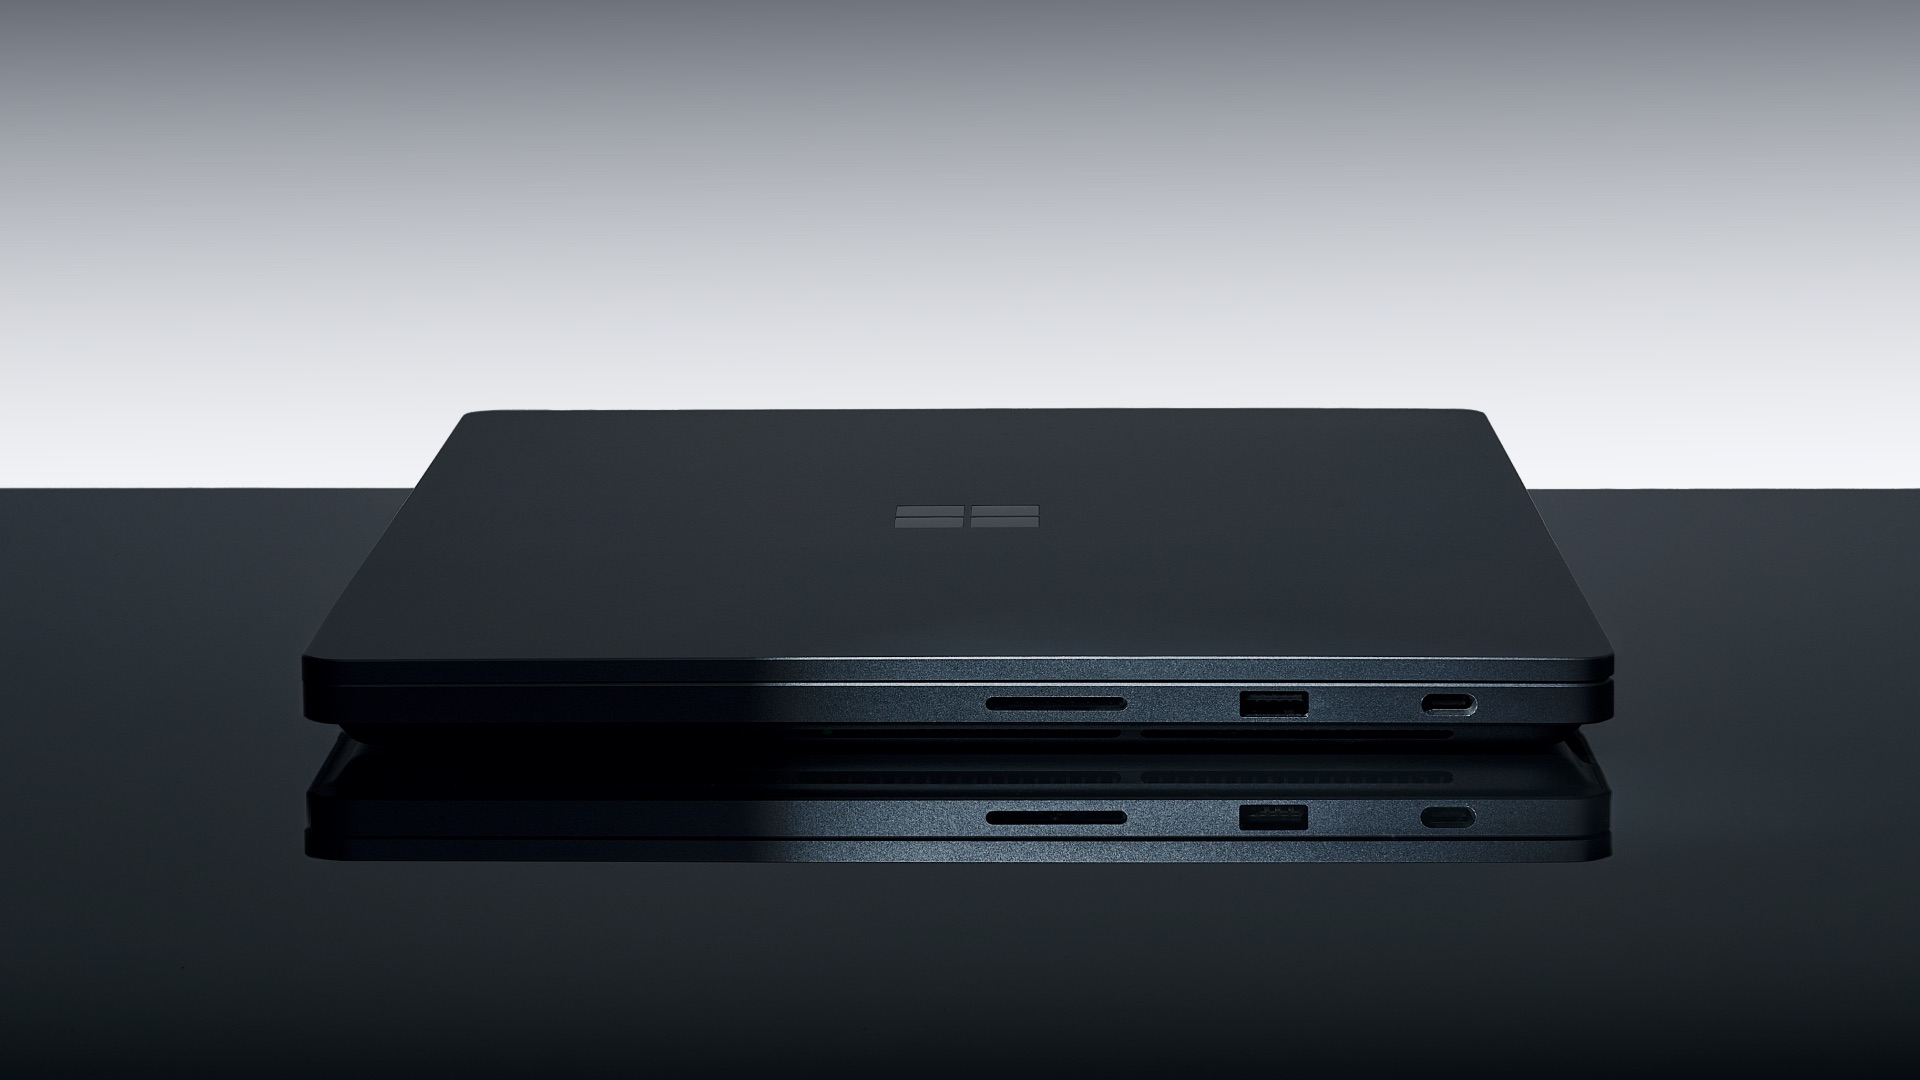
Una novità riguarda la connessione Magnetic Connect, che introduce un sistema di ricarica magnetica integrato in una normale porta USB-C. Il cavo incluso si aggancia magneticamente al connettore destro e si sgancia in caso di trazione accidentale, ma la stessa porta rimane utilizzabile per trasferire dati, collegare periferiche o gestire un’uscita video.
La dotazione comprende altre due porte USB-C, HDMI, USB-A, un lettore di schede SD e un connettore audio da 3,5 mm. Il computer può gestire fino a tre monitor esterni 4K e viene proposto nelle colorazioni Platinum e Nightfall.
Le configurazioni arrivano a 128 GB di memoria unificata e 1 TB di archiviazione, con prezzi che raggiungono 5.899 dollari nel mercato statunitense.
I 128 GB di memoria permettono di eseguire modelli AI con oltre 120 miliardi di parametri
La disponibilità di memoria condivisa è decisiva per utilizzare modelli di intelligenza artificiale di grandi dimensioni direttamente sul PC, soprattutto quando le applicazioni devono mantenere in memoria contesti molto estesi.
Microsoft ha illustrato le capacità della piattaforma attraverso MAI Code 1.1 Flash, modello specializzato nello sviluppo software che utilizza un’architettura mixture-of-experts con 137 miliardi di parametri complessivi, dei quali 6,8 miliardi attivi durante l’inferenza.
La versione destinata all’esecuzione locale utilizza tecniche di quantizzazione che riducono la precisione numerica media a circa 3,3 bit per peso, diminuendo di quasi l’80% la memoria necessaria a conservarne i parametri.
I pesi del modello quantizzato occupano circa 53 GB, ma questa quantità non coincide con il consumo di RAM durante l’esecuzione, perché devono essere considerate anche la cache KV, utilizzata dal meccanismo di attenzione, le strutture del runtime e le risorse necessarie alle altre applicazioni.
Su Surface Laptop Ultra, Microsoft ha registrato un picco di utilizzo della memoria di 75,5 GB con una finestra di contesto di 256.000 token, mentre con contesti di 64.000 e 128.000 token la velocità di elaborazione del prompt ha raggiunto rispettivamente 923,5 e 769,8 token al secondo.
I risultati dei benchmark mostrano che la quantizzazione può conservare buona parte delle capacità del modello originale: MAI Code 1.1 Flash ha ottenuto il 70,8% su SWE-bench Verified, rispetto al 72,6% della versione cloud in BF16, e il 66,29% su Terminal-Bench 2.1, contro il 62,9% della versione cloud.
Le prestazioni dipendono comunque dal runtime, dalla lunghezza del contesto, dal modello e dalle risorse disponibili. Un computer con 128 GB di memoria può ospitare modelli impossibili da caricare integralmente su sistemi meno capienti, ma la quantità di RAM non determina da sola la velocità di generazione dei token.
La gamma dei modelli previsti per RTX Spark comprenderà anche un futuro NVIDIA Nemotron con oltre 70 miliardi di parametri, quantizzato a 2 bit per richiedere poco più di 20 GB di memoria per i pesi, e DeepSeek V4 Flash, con 284 miliardi di parametri.
Surface RTX Spark Dev Box è il desktop per sviluppare e sperimentare con l’AI locale
La stessa piattaforma NVIDIA viene utilizzata da Surface RTX Spark Dev Box, un sistema desktop compatto che Microsoft propone a 5.999 dollari per sviluppatori, ingegneri AI e gruppi di lavoro impegnati nella sperimentazione con modelli locali.
Il dispositivo dispone di 128 GB di memoria unificata e fino a un petaflop di capacità di calcolo AI, con risorse sufficienti per eseguire modelli che superano i 120 miliardi di parametri e utilizzare finestre di contesto estese.
Rispetto al portatile, la Dev Box rinuncia alla mobilità e concentra le risorse in un ambiente desktop che può rimanere disponibile per attività di sviluppo, valutazione e ottimizzazione dei modelli, compresi i processi agentici che eseguono ripetutamente codice e verificano i risultati.
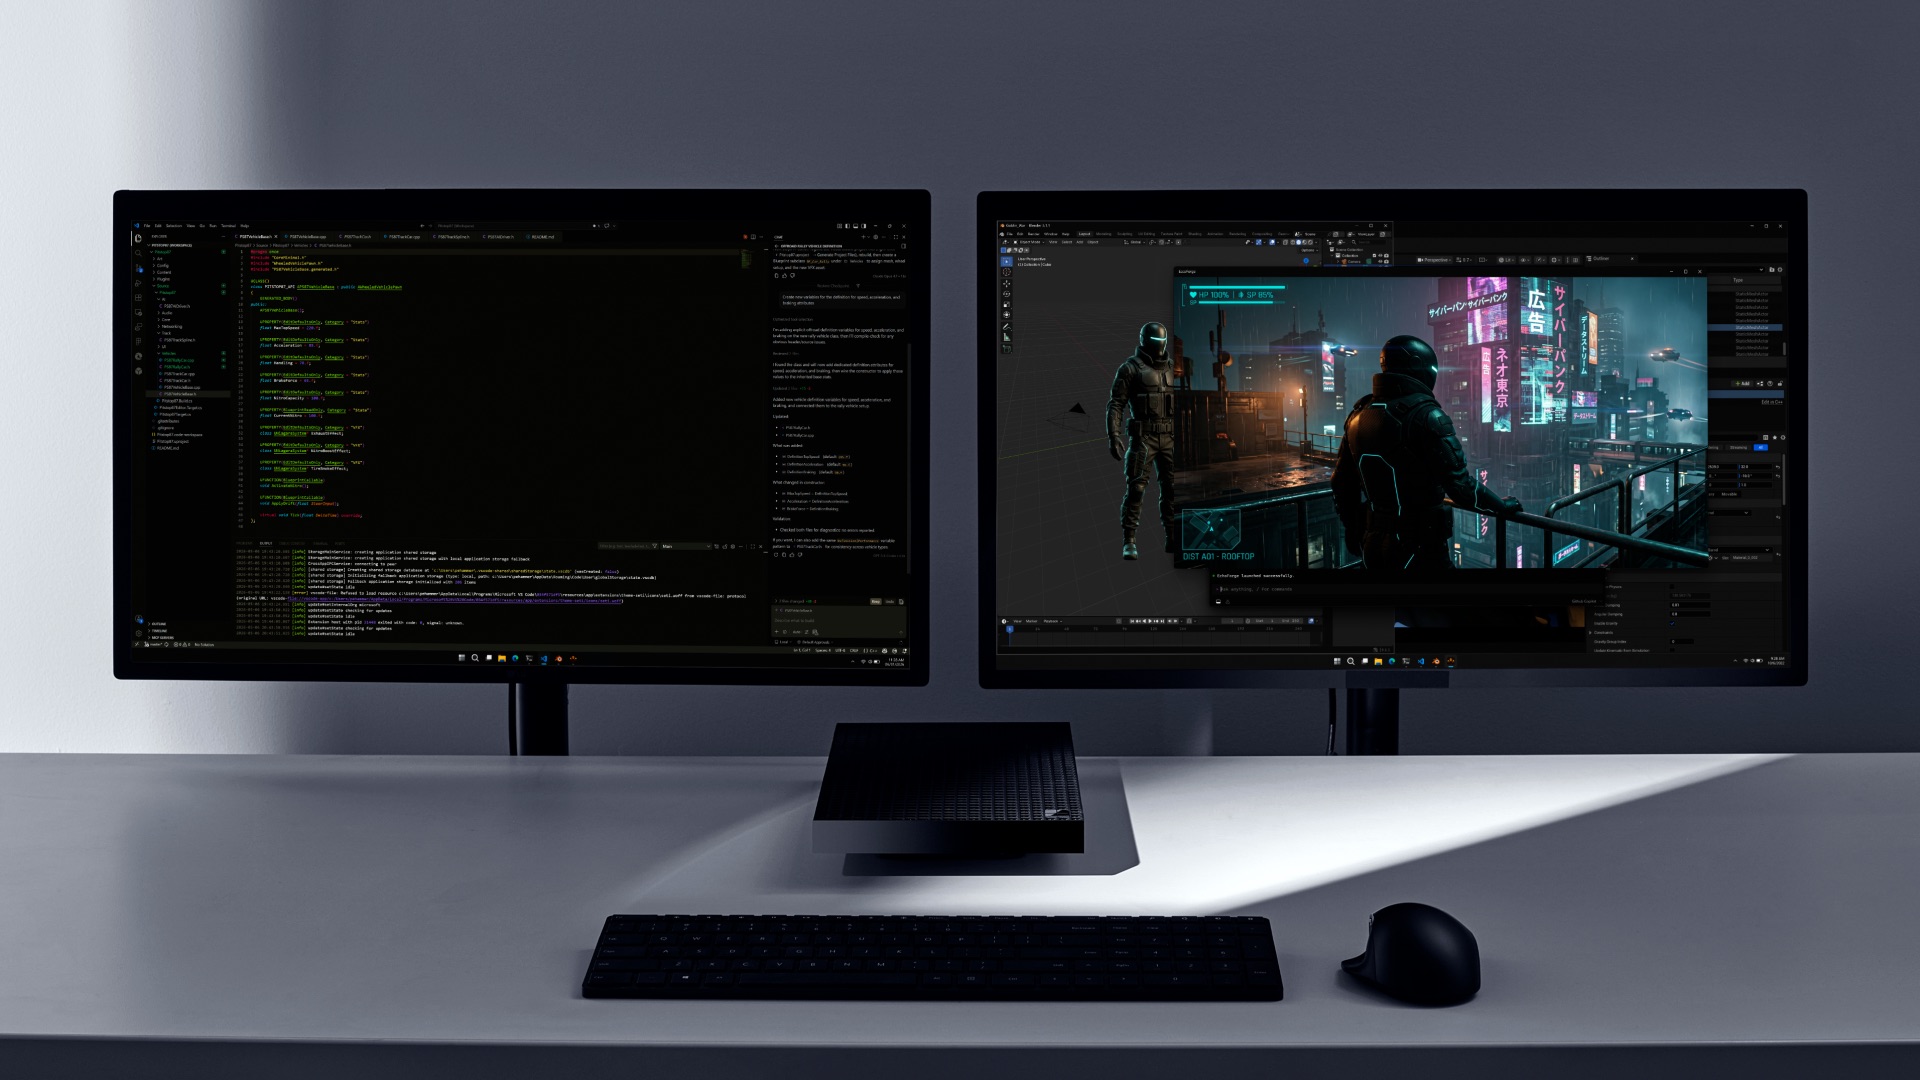
Microsoft la colloca nella famiglia Project Zenith e la distribuisce con Windows 11 Pro e un ambiente di sviluppo che comprende Visual Studio Code, Git, GitHub CLI, GitHub Copilot, Python, Node.js, PowerShell 7 e Windows Subsystem for Linux 2 con supporto GPU.
Gli sviluppatori possono utilizzare Windows ML, TensorRT e gli strumenti NVIDIA per eseguire modelli localmente, mentre AI Toolkit per Visual Studio Code consente di effettuare conversione, quantizzazione, fine-tuning e valutazione delle prestazioni.
L’integrazione con Microsoft Foundry permette inoltre di trasferire verso il cloud i modelli e i processi sviluppati in locale, quando le esigenze di capacità computazionale o distribuzione lo richiedono.
Sul piano della sicurezza, il dispositivo supporta BitLocker, Microsoft Defender e gli strumenti aziendali Microsoft Entra ID e Intune. Gli agenti AI possono utilizzare Microsoft Execution Containers (MXC) per eseguire comandi e strumenti in ambienti isolati, con limitazioni sugli accessi ai file e alle risorse di rete.
Surface RTX Spark Dev Box sarà disponibile negli Stati Uniti a partire da novembre 2026.
ASUS, Dell, HP, Lenovo e MSI completano la prima generazione RTX Spark
Surface Laptop Ultra è il primo portatile Microsoft basato su RTX Spark, ma la piattaforma NVIDIA è stata concepita fin dall’inizio per un ecosistema di computer Windows realizzati da produttori differenti.
ASUS propone i nuovi ProArt P16 e P14, due modelli da 16 e 14 pollici destinati ai professionisti della creazione digitale, con display Lumina Pro OLED e configurazioni pensate per sostenere applicazioni grafiche e AI.
Dell utilizza RTX Spark nel nuovo XPS 16 Creator Edition, che combina accelerazione GPU, capacità di inferenza locale e un display orientato alle applicazioni professionali che richiedono accuratezza cromatica.
HP ha sviluppato OmniBook Ultra 16, caratterizzato da un sistema di raffreddamento progettato per mantenere prestazioni sostenute durante i carichi AI, mentre Lenovo Yoga 9n 2-in-1 combina il superchip NVIDIA con un formato convertibile a 360 gradi e supporto alla penna.
Completa la gamma MSI Prestige N16 Flip AI+, un convertibile da 16 pollici con schermo UHD+ Tandem OLED e batteria da 99,9 Wh, destinato ad applicazioni creative, professionali e gaming.
I nuovi computer saranno disponibili a partire dal 16 ottobre 2026, dopo l’apertura dei preordini del 7 ottobre. Nel corso dell’anno arriveranno ulteriori mini desktop e sistemi di sviluppo basati sulla stessa architettura.
Il confronto con Apple MacBook Pro M5 Pro sulle prestazioni AI
Microsoft e NVIDIA hanno confrontato le prestazioni di alcuni PC RTX Spark con un Apple MacBook Pro da 16 pollici basato su M5 Pro, utilizzando sistemi dotati di 64 GB di memoria.
Nei test commissionati da Microsoft e condotti da NVIDIA nel settembre 2026, i computer Windows hanno registrato un tempo al primo token fino a 2,1 volte inferiore, una generazione di immagini AI fino a 4,3 volte più veloce e una generazione video fino a 6,2 volte più rapida.
Il confronto ha utilizzato modelli e strumenti differenti per ciascun carico di lavoro. Per l’inferenza testuale è stato impiegato Qwen3.5 27B in formato Q4K-Medium, eseguito attraverso llama.cpp con un prompt fisso di 8.192 token.
La generazione delle immagini è stata misurata con FLUX.2 Klein 4B in ComfyUI, utilizzando la precisione NVFP4 e una risoluzione di 1.024 × 1.024 pixel, mentre per i video è stato utilizzato LTX 2.3 22B, sempre in ComfyUI, con sequenze di 121 fotogrammi a 25 fps e risoluzione di 1.280 × 720 pixel.
I risultati riguardano specifiche operazioni di inferenza e generazione, influenzate dalle ottimizzazioni dei runtime e dal supporto hardware per i formati numerici utilizzati. Non costituiscono quindi una misura generale delle prestazioni dei due computer.
Il confronto con Apple riguarda anche la capacità di memoria disponibile per i modelli locali. La configurazione RTX Spark da 128 GB permette di caricare modelli e contesti più grandi rispetto a quelli utilizzabili su un sistema con 64 GB, indipendentemente dalle prestazioni pure del processore.
DGX Station per Windows estende l’inferenza locale ai modelli da mille miliardi di parametri
La collaborazione con NVIDIA comprende anche DGX Station per Windows, una categoria di workstation desktop che utilizza il GB300 Grace Blackwell Ultra Desktop Superchip e offre fino a 748 GB di memoria coerente e 20 petaflops di capacità di calcolo AI in precisione FP4.
Queste risorse consentono di eseguire localmente modelli con dimensioni fino a mille miliardi di parametri, a seconda dell’architettura e della precisione numerica utilizzata.
Tra i modelli citati da Microsoft figurano Llama 4 Maverick, Kimi K2.6 e DeepSeek V4 Pro, che richiedono quantità di memoria e capacità di elaborazione superiori a quelle disponibili sui PC RTX Spark.
Le nuove workstation permetteranno di eseguire elaborazioni scientifiche, simulazioni ingegneristiche e applicazioni multimodali che combinano modelli AI con strumenti di calcolo e visualizzazione. L’architettura prevede inoltre la possibilità di affiancare al superchip GB300 una GPU NVIDIA RTX PRO Blackwell, così da combinare inferenza e rendering grafico avanzato nello stesso sistema.
I primi prodotti annunciati comprendono Dell Pro Precision con GB300 e HP ZGX Fury AI Station, entrambi attesi entro la fine del 2026.
Le Windows Token Factory trasformano le workstation in risorse AI condivise
Una workstation DGX Station può essere utilizzata anche come infrastruttura di inferenza condivisa, secondo il modello che Microsoft definisce Windows Token Factory.
In questa configurazione, una macchina locale fornisce capacità di calcolo a più applicazioni e agenti, evitando che ogni utente debba disporre di un computer equipaggiato con acceleratori sufficientemente potenti per eseguire i modelli richiesti.
Microsoft indica la possibilità di sostenere almeno 32 agenti simultanei, un numero che descrive la capacità di servire più processi autonomi e che non implica necessariamente l’esecuzione contemporanea di 32 inferenze alla massima velocità.
Le prestazioni dipendono infatti dal modello utilizzato, dalla lunghezza dei contesti, dalla quantità di memoria necessaria per ciascuna sessione e dalla gestione delle richieste concorrenti.
L’infrastruttura può essere amministrata attraverso gli strumenti di gestione Windows, mentre Microsoft Execution Containers consente di isolare le attività degli agenti e limitare l’accesso alle risorse del sistema.
Per le organizzazioni che utilizzano intensivamente l’AI, una Token Factory permette di concentrare gli investimenti hardware e condividere la capacità di inferenza tra sviluppatori, ingegneri, ricercatori e applicazioni aziendali, mantenendo i dati all’interno della propria infrastruttura quando anche gli altri componenti del flusso di lavoro operano localmente.
AI locale o cloud: il costo dei nuovi PC rende decisivo il volume delle elaborazioni
Le prestazioni dei nuovi Surface e delle workstation NVIDIA devono essere valutate anche rispetto al loro costo, che colloca l’inferenza locale di grandi dimensioni in una fascia ancora prevalentemente professionale.
Surface Laptop Ultra parte da 2.599 dollari, con 24 GB di memoria e 512 GB di archiviazione, ma per eseguire modelli come MAI Code 1.1 Flash con finestre di contesto estese occorre una configurazione dotata di molta più memoria, fino alla versione da 5.899 dollari con 128 GB di RAM e 1 TB di archiviazione.
La Dev Box, proposta a 5.999 dollari, richiede un investimento analogo, mentre le workstation DGX Station appartengono a una categoria superiore.
A incidere sul prezzo è anche la crescita del costo della memoria, componente particolarmente importante nei sistemi progettati per l’AI locale. Secondo le previsioni di TrendForce per il quarto trimestre 2026, i prezzi contrattuali delle memorie DRAM convenzionali aumenteranno del 10-15% rispetto al trimestre precedente, mentre quelli delle NAND Flash cresceranno del 15-20%. La domanda dei data center AI contribuisce alla pressione sulla capacità produttiva dei semiconduttori e alla disponibilità di memoria per il mercato dei personal computer.
La convenienza rispetto ai servizi cloud dipende soprattutto dalla frequenza e dall’intensità di utilizzo: per un professionista che utilizza occasionalmente modelli AI avanzati, un abbonamento o un servizio API a consumo può risultare economicamente più vantaggioso dell’acquisto di un computer specializzato, oltre a garantire l’accesso a modelli che potrebbero richiedere risorse superiori a quelle disponibili localmente; uno sviluppatore che esegue quotidianamente migliaia di inferenze, magari attraverso agenti impegnati per ore in attività di programmazione, test e analisi, può invece sostenere costi cloud considerevoli, rendendo più interessante un investimento hardware da ammortizzare nel tempo.
Un computer acquistato per 6.000 dollari e utilizzato per tre anni corrisponde, considerando soltanto l’investimento iniziale, a circa 167 dollari mensili, ai quali devono essere aggiunti energia elettrica, manutenzione, configurazione e aggiornamento dei modelli.
Il confronto con il cloud richiede però di considerare il costo effettivo delle chiamate API, la quantità di token elaborati, il rapporto tra token in ingresso e in uscita e l’eventuale utilizzo della cache. Occorre inoltre verificare che i modelli confrontati offrano capacità e accuratezza adeguate alle stesse attività: un modello locale quantizzato non è necessariamente equivalente a un modello di frontiera disponibile nel cloud.
Anche il tasso di utilizzo incide sul risultato economico. Un portatile che rimane inutilizzato per molte ore della giornata può offrire un rapporto tra investimento e inferenze prodotte meno favorevole rispetto a una workstation impegnata continuativamente.
Il calcolo cambia quando intervengono esigenze di riservatezza, conformità normativa e disponibilità offline. Per imprese che trattano proprietà intellettuale, studi professionali e strutture sanitarie, l’elaborazione locale può rispondere a requisiti che rendono secondario il confronto sui soli costi dei token, pur richiedendo adeguate misure di sicurezza e controllo delle connessioni.
L’inferenza condivisa costituisce uno scenario economicamente differente, perché permette di distribuire il costo dell’hardware tra più utenti, applicazioni e agenti, aumentando il tasso di utilizzo degli acceleratori.
Le Windows Token Factory basate su DGX Station seguono proprio questa logica: una risorsa computazionale interna, accessibile da più postazioni e capace di fornire inferenza senza applicare un costo per ogni chiamata al modello. Rimangono naturalmente i costi dell’infrastruttura, dell’energia, della gestione e del personale necessario a mantenerla operativa.
Per le organizzazioni con carichi di lavoro continuativi, il confronto economico diventa quindi quello tra una capacità di inferenza interna condivisa e il consumo ricorrente di servizi cloud. La scelta dipende dai volumi, dalla qualità dei modelli necessari, dalla saturazione delle risorse e dai requisiti di protezione dei dati.
Surface Laptop Ultra e Dev Box: prezzi e disponibilità
I preordini di Surface Laptop Ultra sono aperti dal 7 ottobre 2026, con consegne previste a partire dal 16 ottobre. Negli Stati Uniti il prezzo iniziale è di 2.599 dollari, mentre la configurazione con 128 GB di memoria unificata e 1 TB di archiviazione raggiunge 5.899 dollari.
Surface RTX Spark Dev Box costa 5.999 dollari e sarà distribuito inizialmente negli Stati Uniti, con le prime consegne previste a novembre.
I portatili RTX Spark di ASUS, Dell, HP, Lenovo e MSI seguiranno il calendario commerciale della piattaforma NVIDIA, con disponibilità a partire dal 16 ottobre, mentre i mini desktop e le workstation DGX Station basate su GB300 arriveranno entro la fine del 2026.