Elaborare una richiesta mentre l’interlocutore sta ancora parlando permette a un assistente vocale di guadagnare tempo per preparare la risposta. Su questo passaggio interviene MAI-Transcribe-2-Streaming, il primo modello Microsoft per la trascrizione in streaming, presentato insieme ai sintetizzatori MAI-Voice-2.1 e MAI-Voice-2.1-Flash. L’aggiornamento della famiglia MAI riguarda così entrambe le estremità dell’interazione: riconoscere il parlato e generare la voce.
L’interazione di un agente vocale comprende ascolto, comprensione della richiesta, scelta delle azioni e formulazione della risposta. Ogni passaggio occupa una parte del tempo disponibile per mantenere il ritmo della conversazione: rendere più rapida la trascrizione e la generazione audio lascia maggiore spazio al ragionamento e all’impiego degli strumenti. I tre modelli MAI si rivolgono agli sviluppatori che costruiscono questa sequenza, con un componente speech-to-text per l’ingresso e due modelli text-to-speech per l’uscita.
Trascrizioni che si aggiornano durante il parlato
Con MAI-Transcribe-2-Streaming, l’applicazione invia un flusso audio continuo e riceve risultati intermedi, aggiornati mentre la persona parla, seguiti dalla conferma dei singoli segmenti. È un funzionamento adatto a call center, assistenti, sottotitoli per riunioni e lezioni, interfacce vocali e appunti in tempo reale. La trascrizione può alimentare sia un testo visibile sia l’elaborazione della richiesta da parte di un agente. Per la dettatura e i sottotitoli, il risultato è un testo che compare progressivamente; per un assistente, è un ingresso disponibile durante la frase, sul quale iniziare a ragionare o richiamare strumenti.
I risultati intermedi, chiamati anche partials, vengono rivisti man mano che arriva nuovo audio e aumenta il contesto. Appena dispone di un risultato stabile, il modello conferma il segmento e rende definitiva quella parte della trascrizione. Questa distinzione permette all’applicazione di seguire il parlato attraverso le ipotesi provvisorie e di ricevere separatamente il testo definitivo dei singoli interventi.
Il modello riconosce 60 lingue, con rilevamento automatico e continuo, e produce le prime ipotesi di trascrizione poco oltre 100 millisecondi dalla ricezione dell’audio. Il rilevamento continuo della lingua segue l’audio in ingresso senza richiedere di impostare preventivamente un solo idioma.
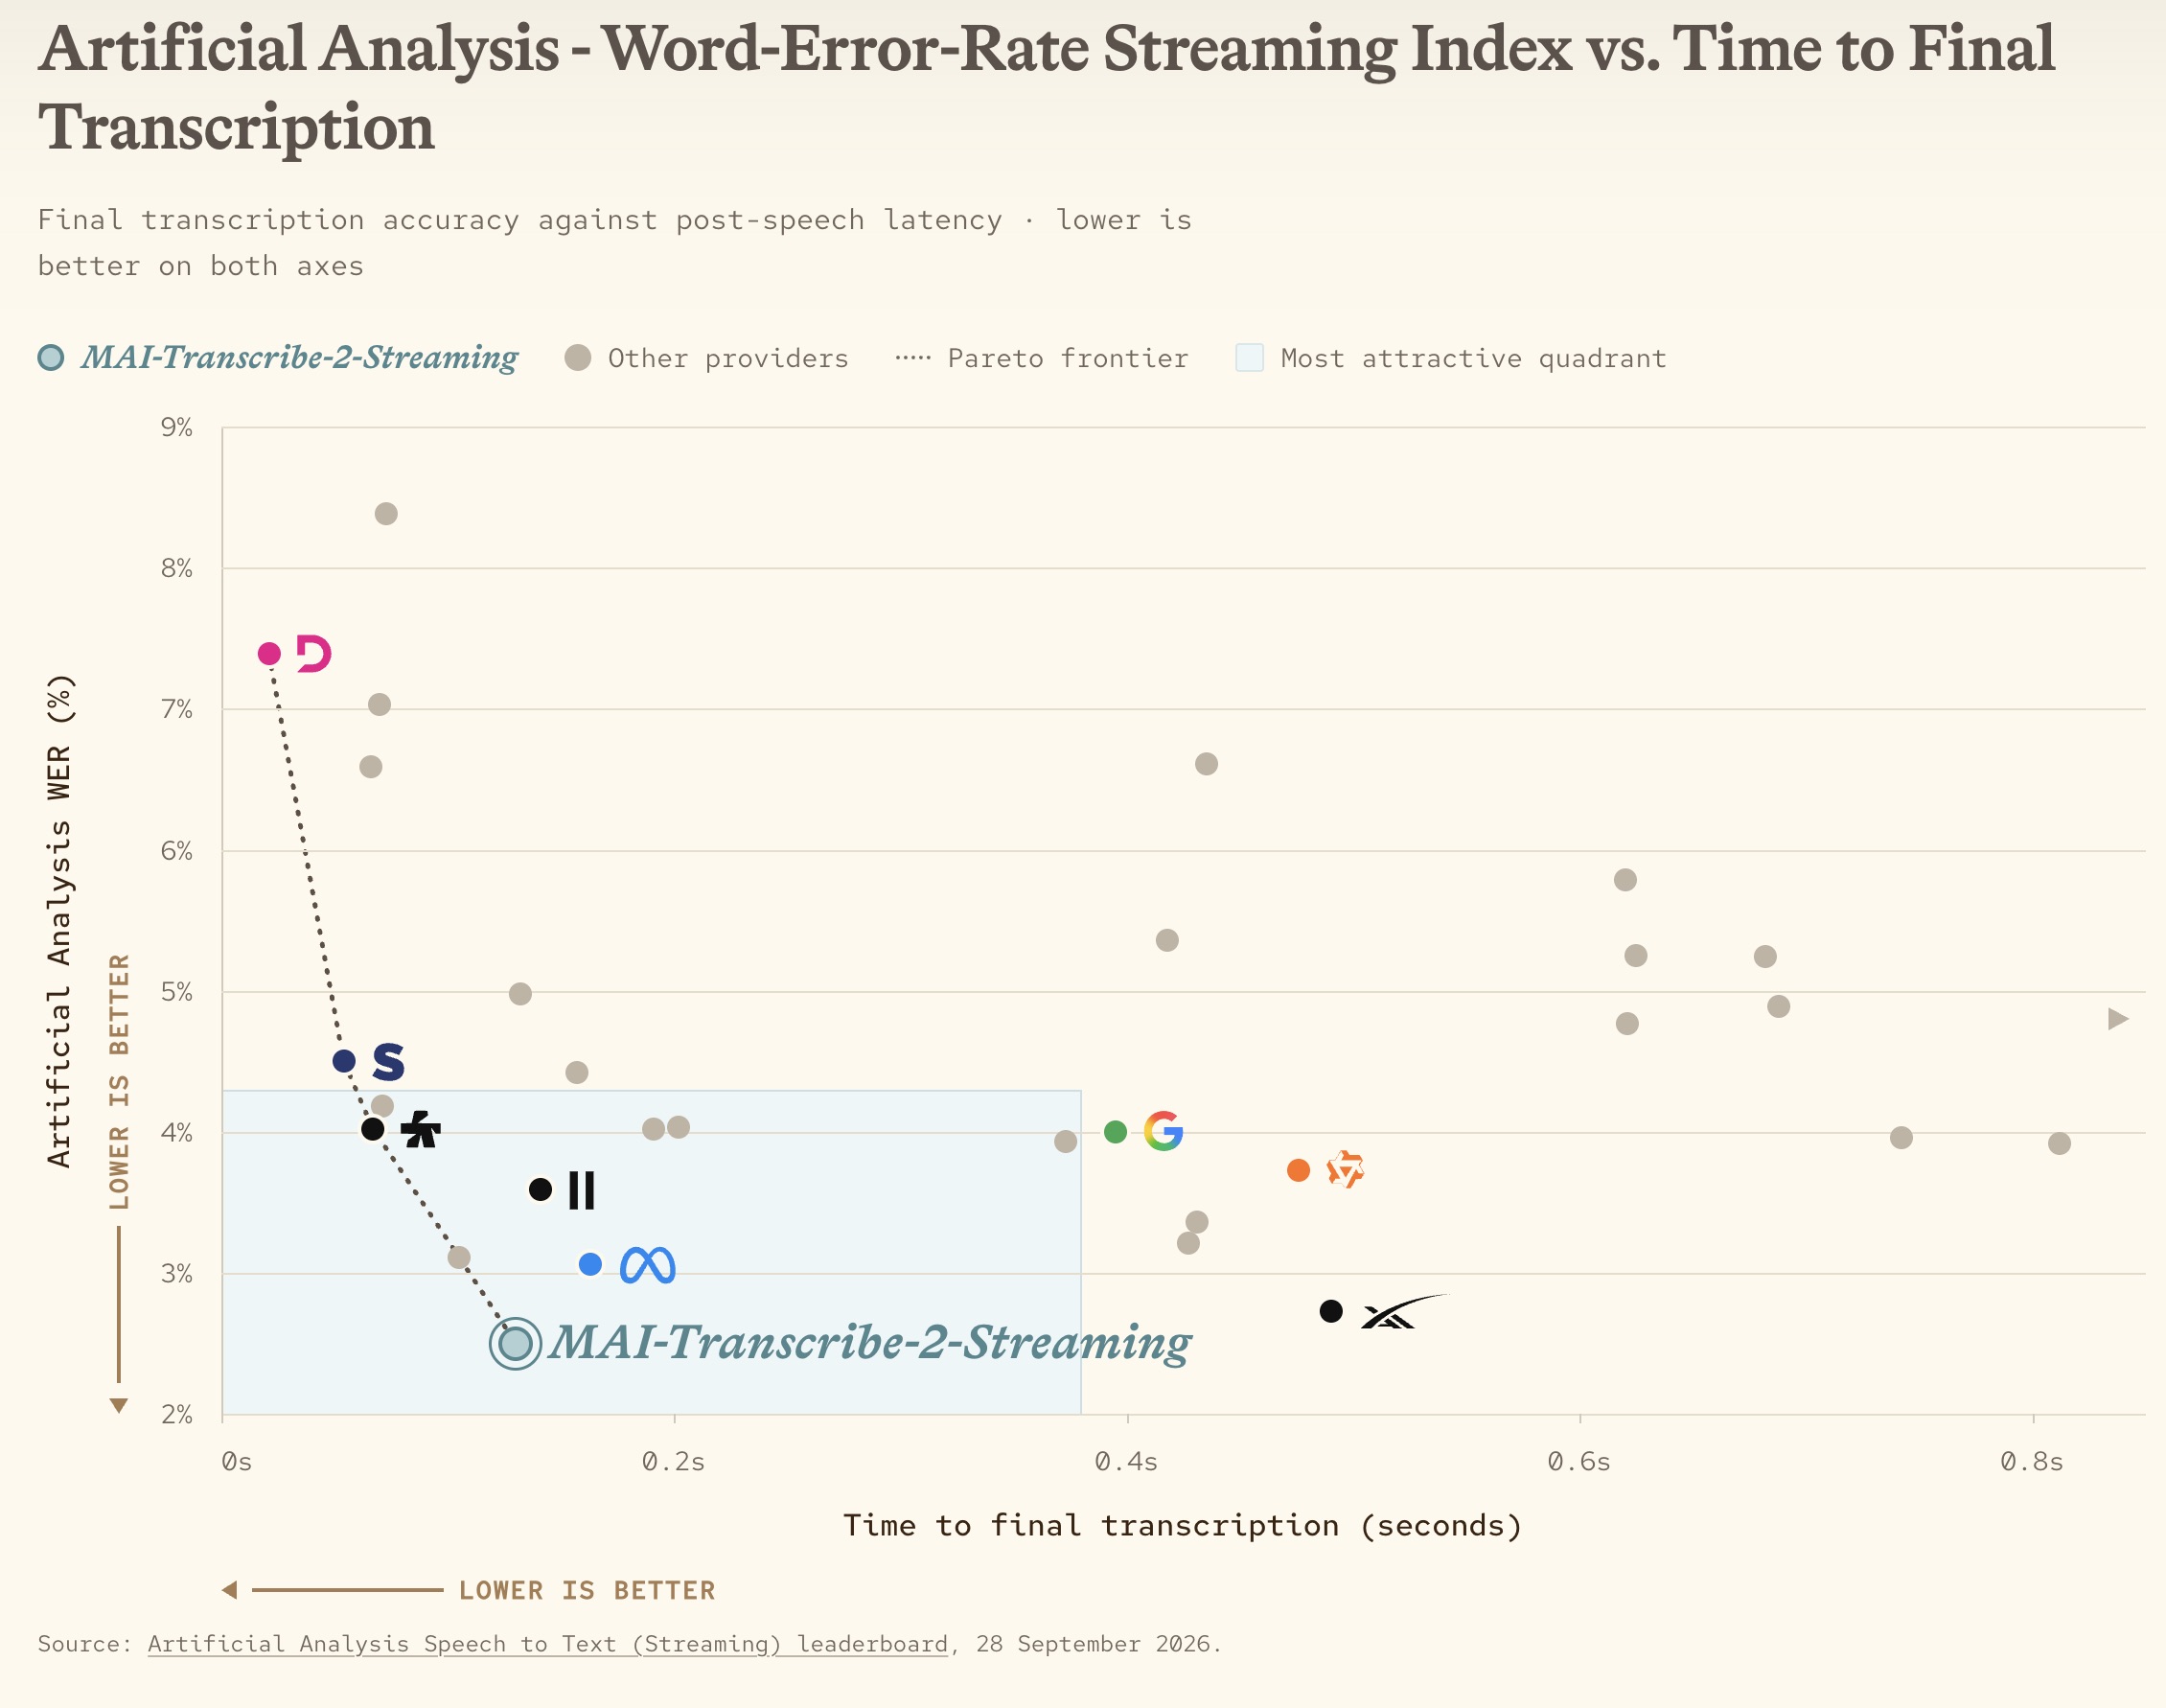
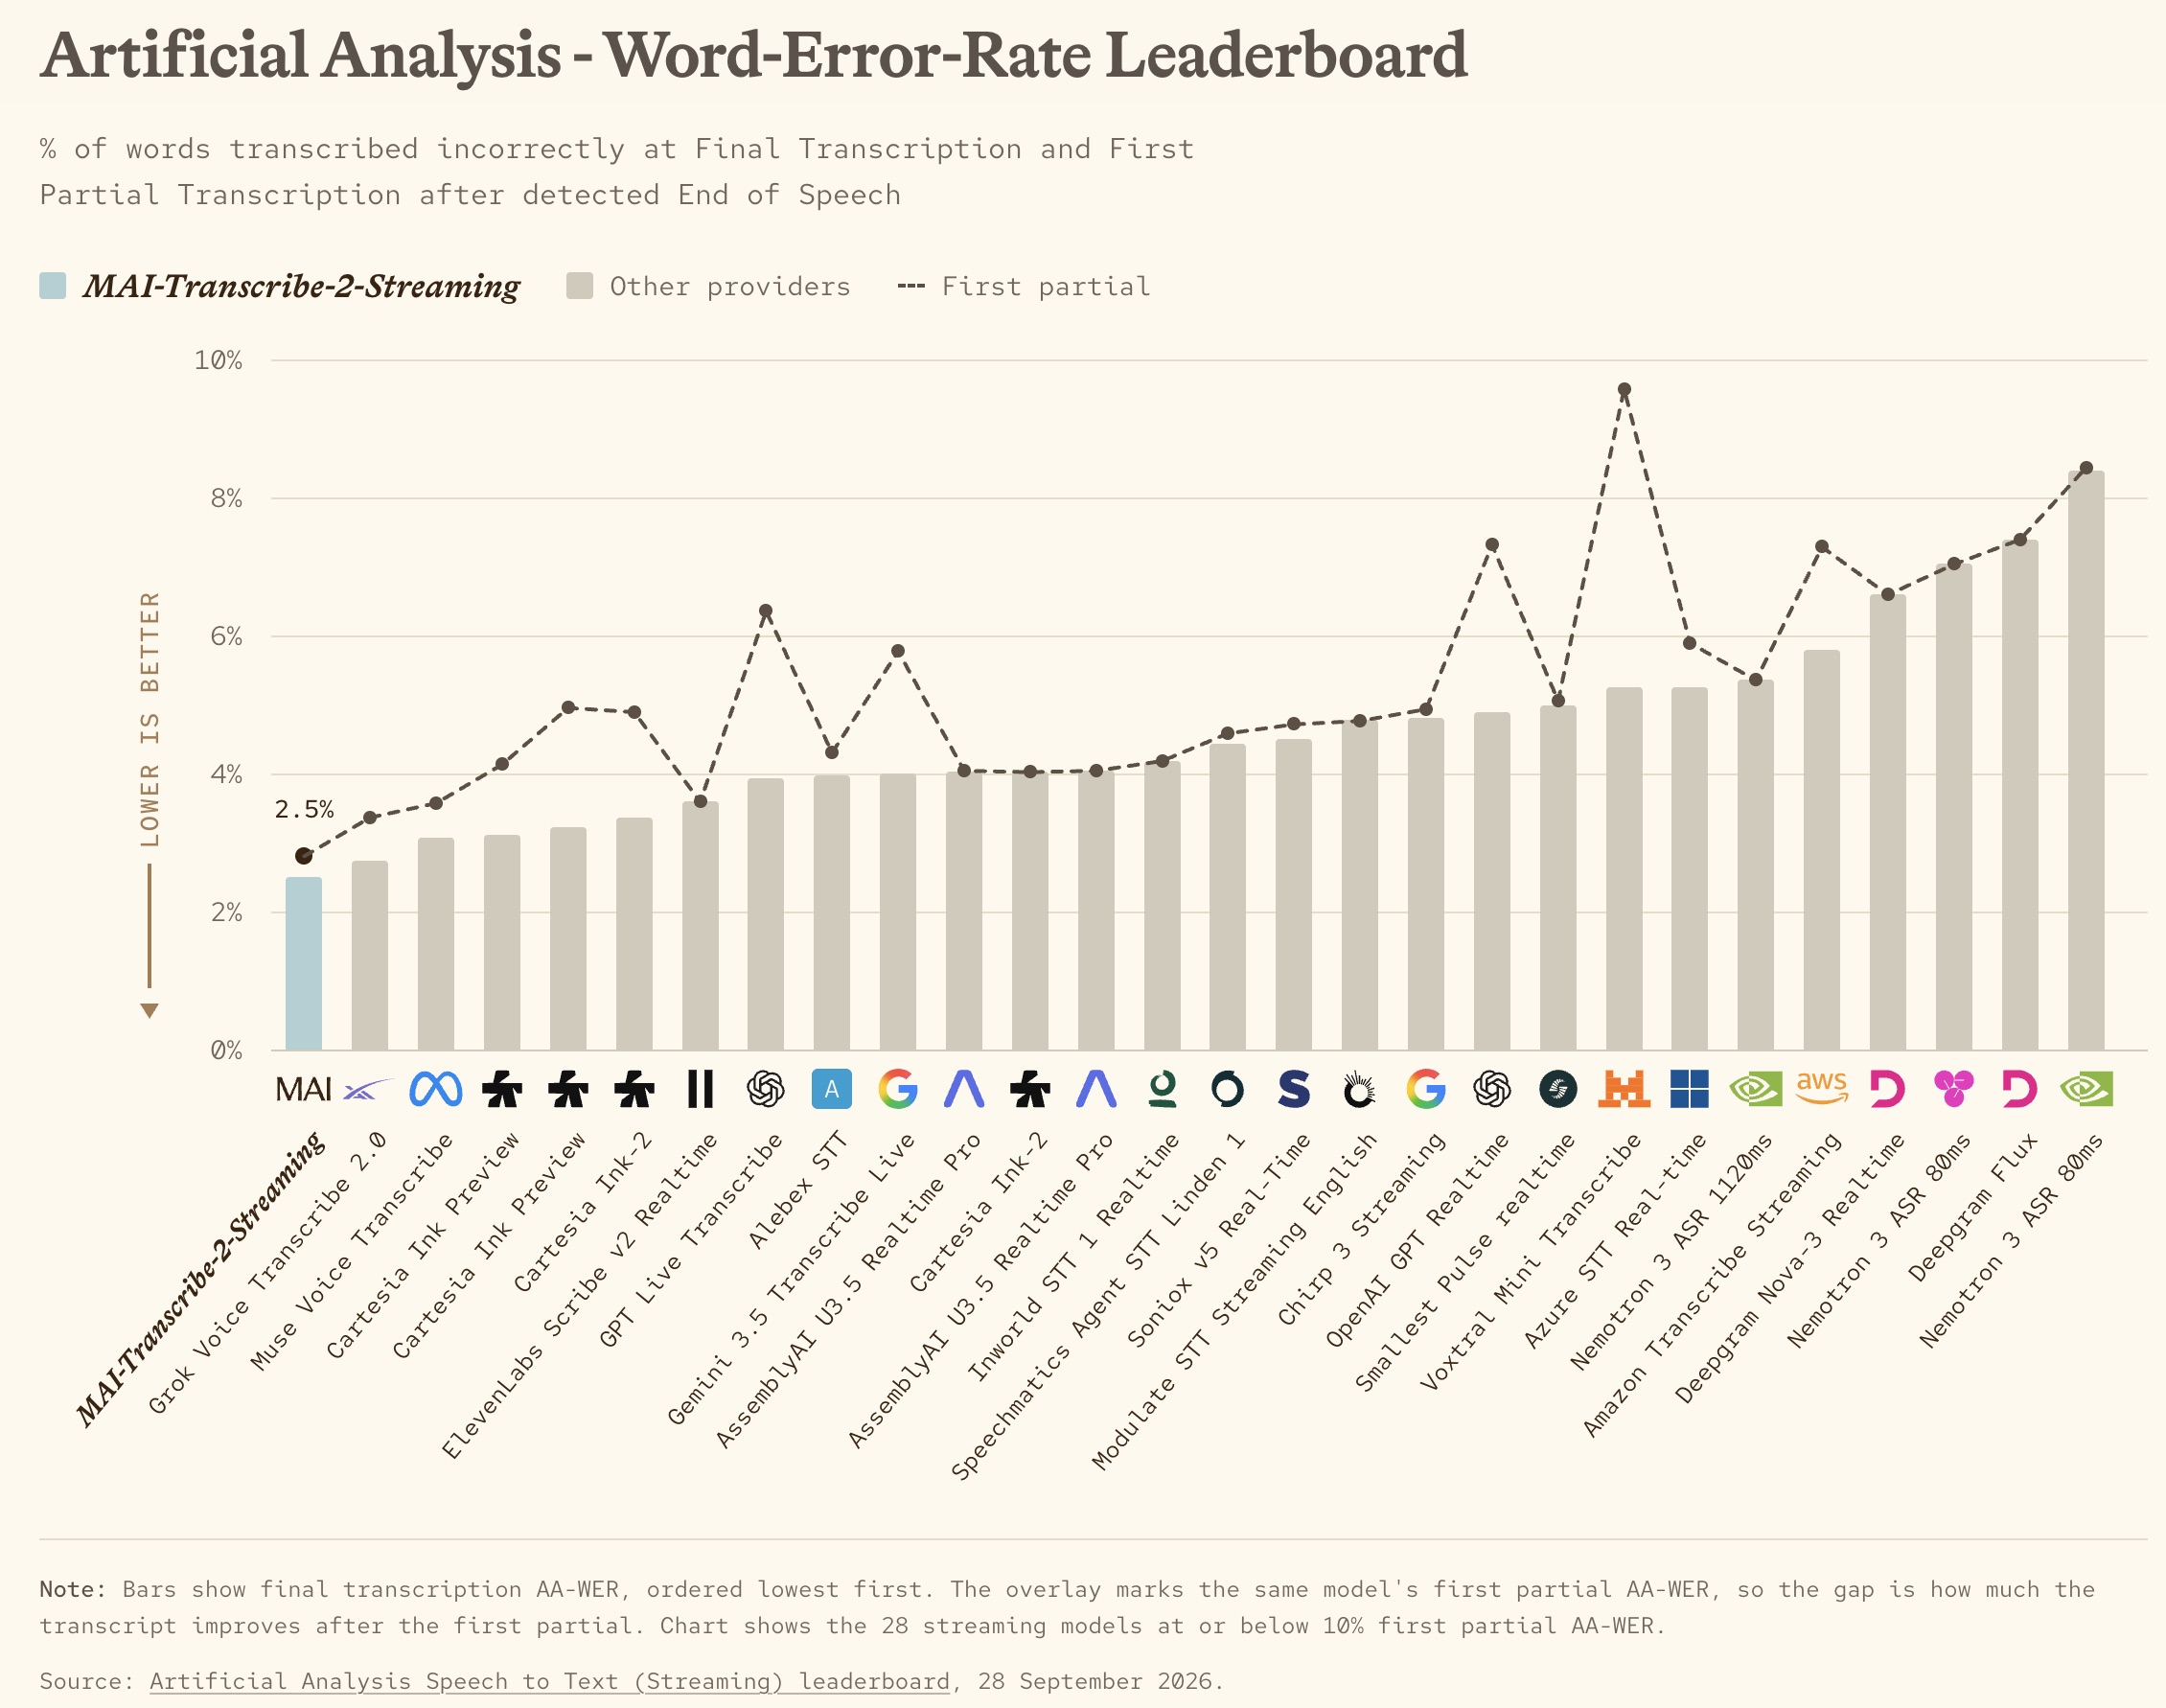
Debutta al primo posto per accuratezza delle trascrizioni parziali e finali su Artificial Analysis; nella valutazione precisione-latenza si colloca sulla frontiera di Pareto, l’insieme delle soluzioni che offrono i migliori compromessi tra le due misure. Nei test interni Microsoft, le parole compaiono due volte più rapidamente rispetto al concorrente più vicino.
Il prezzo introduttivo è di 0,54 dollari per ora di audio fino alla fine del 2026.
Una voce riconoscibile in più lingue
MAI-Voice-2.1 è il modello di sintesi vocale multilingue più avanzato finora sviluppato da Microsoft. Per la generazione audio, MAI-Voice-2.1 e la variante Flash supportano 23 lingue, incluso l’italiano, e 26 varianti locali. La stessa voce mantiene la propria identità passando da una lingua all’altra e adotta l’accento nativo corrispondente. Il timbro resta riconoscibile anche in una sequenza che passa dall’inglese al mandarino e poi al tedesco, con una pronuncia adeguata a ciascuna lingua. Per un’applicazione educativa, questo consente di cambiare idioma durante la lezione conservando la voce dell’insegnante; per un assistente, di rispondere nella lingua dell’utente con la stessa identità vocale. Un’azienda può così usare una voce riconoscibile nei diversi mercati in cui opera.
MAI-Voice-2.1 costa 22 dollari per milione di caratteri ed è adatto anche a contenuti estesi, come audiolibri, podcast, materiali didattici e narrazioni, nei quali conta la continuità della voce. La stabilità dell’identità del parlante accompagna quindi tanto il cambio di lingua quanto la durata del contenuto didattico o editoriale.
La variante Flash per volumi elevati e risposte rapide
Con le stesse lingue e la stessa capacità di mantenere un parlante riconoscibile tra idiomi, MAI-Voice-2.1-Flash privilegia le interazioni sensibili alla latenza e i carichi ad alto volume, tra cui assistenti e servizi telefonici. Il prezzo è di 15 dollari per milione di caratteri. Microsoft indica per Flash la generazione di 45 secondi di audio con una latenza complessiva di 150 millisecondi, un’inferenza più rapida del 55% e un costo circa il 60% inferiore rispetto a modelli comparabili.
Entrambi consentono la clonazione vocale nelle lingue supportate, con protezioni integrate basate sul consenso per impedire usi impropri. Il riferimento audio può durare da 5 a 60 secondi, senza richiedere ulteriore addestramento, e l’accesso alla funzione è controllato. Questa possibilità permette di impiegare la voce del marchio nei diversi idiomi supportati. Sono disponibili anche voci predefinite con licenza, utilizzabili per avviare un’applicazione senza creare un nuovo profilo vocale. Attraverso Azure Speech e SSML, il linguaggio di marcatura per la sintesi vocale, gli sviluppatori possono inoltre regolare stili ed emozioni, per esempio gioia, entusiasmo ed empatia.
Dall’assistenza clienti alla formazione multilingue
Abbinare il riconoscimento streaming a MAI-Voice-2.1-Flash lascia all’agente più tempo per ragionare, consultare strumenti e verificare la risposta. Nell’assistenza clienti, il sistema può trascrivere la richiesta mentre viene formulata, avviare le operazioni prima che la persona finisca e restituire una risposta pronunciata. Un assistente multilingue combina invece rilevamento automatico dell’idioma in ingresso e risposta in una delle 23 lingue della sintesi.
Le applicazioni educative e i contenuti interattivi possono utilizzare parlanti distinti per tutoraggio, giochi di ruolo, simulazioni e narrazione. La disponibilità di più voci e il controllo dell’interpretazione permettono di differenziare i ruoli, mentre la continuità multilingue conserva l’identità dei personaggi o dell’insegnante quando cambia la lingua della scena.
Il contesto dei nuovi modelli vocali
L’aggiornamento Microsoft si inserisce in una fase di sviluppo continuo dei modelli vocali. Sul riconoscimento, Gemini 3.5 Transcribe combina trascrizione, pulizia e formattazione del testo per i workflow, mentre Meta Muse Voice Transcribe integra trascrizione in tempo reale, identificazione degli interlocutori e rilevamento della fine degli interventi. Nella sintesi, i recenti Gemini 3.8 Flash TTS e Flash-Lite TTS aggiungono progettazione delle voci da prompt e controllo dell’interpretazione. Dal 28 settembre sono disponibili anche Eleven v4 e v4 Turbo: il primo migliora espressività e clonazione in oltre 90 lingue, mentre Turbo è destinato alle applicazioni in tempo reale, con una latenza mediana di inferenza di circa 100 millisecondi. Sono due ulteriori componenti della piattaforma audio e degli agenti ElevenLabs, che affianca creazione di contenuti e interazioni conversazionali.
Dove provare e integrare i modelli MAI
I tre nuovi modelli Microsoft sono accessibili attraverso Foundry, MAI Playground, Vercel e Azure Voice Live; i due sintetizzatori sono disponibili anche su OpenRouter, mentre l’integrazione LiveKit è annunciata in arrivo. Nel MAI Playground, la nuova demo Chatter combina voce e trascrizione in un agente conversazionale, permettendo di sperimentare il funzionamento congiunto dei componenti MAI. Per integrare il riconoscimento streaming sono disponibili una Realtime API via WebSocket compatibile con l’interfaccia OpenAI Realtime e Azure Speech SDK, che gestisce connessioni, tentativi di riconnessione e flusso audio. MAI-Transcribe-2-Streaming è in anteprima pubblica, senza un accordo sui livelli di servizio: questa fase è destinata alla sperimentazione e Microsoft ne sconsiglia l’uso per carichi di produzione.