Neocloud e provider GPU-as-a-Service possono aumentare separatamente le risorse dedicate ai metadati e al trasferimento dei dati con NetApp Novus, l’architettura di storage che riunisce grandi ambienti GPU sotto un unico namespace e conserva i servizi dati enterprise di ONTAP. La disaggregazione permette di scalare prestazioni, capacità e concorrenza per alimentare le GPU con continuità, riducendo i colli di bottiglia che, nelle architetture tradizionali, possono far scendere il loro utilizzo sotto il 30%.
La banda necessaria per alimentare le GPU
Novus è progettata per superare 100 TB/s di throughput aggregato, con bassa latenza, e supportare centinaia di migliaia di GPU, con un file system scalabile fino a uno zettabyte, pari a mille miliardi di gigabyte. L’architettura è concepita per alimentare milioni di GPU nelle AI factory su scala gigawatt. Tra i destinatari figurano anche hyperscaler e imprese con GPU cloud.
Una GPU può richiedere fino a 2 GB/s: 50.000 GPU richiedono quindi 100 TB/s di banda cumulativa, che Novus offre in lettura. Gli array tradizionali offrono 40–80 GB/s; sistemi separati moltiplicano namespace, domini di guasto e gestione. L’utilizzo delle GPU può scendere a una sola cifra percentuale: l’hardware continua ad ammortizzarsi mentre attende i dati, senza produrre ricavi.
“Le AI factory sono in difficoltà e l’economia delle GPU ne risente quando i dati non riescono a stare al passo”, dichiara Syam Nair, Chief Product Officer di NetApp. “Lo storage dell’era HPC da solo non può soddisfare le esigenze delle AI Factory su questa scala: il settore ha bisogno di un’architettura vera e propria, costruita da zero per questo scopo”.
Metadati e checkpoint su piani indipendenti
Le operazioni di apertura, ricerca e layout competono con i trasferimenti sui controller: i metadati possono saturarli prima della capacità o della banda, e aggiungere controller non risolve da solo il problema. L’importazione dei workspace genera milioni di operazioni su piccoli file; i checkpoint, scritture sequenziali di terabyte da tutti i nodi dopo picchi di metadati. Risposte rapide e banda sequenziale competono sulle stesse risorse.
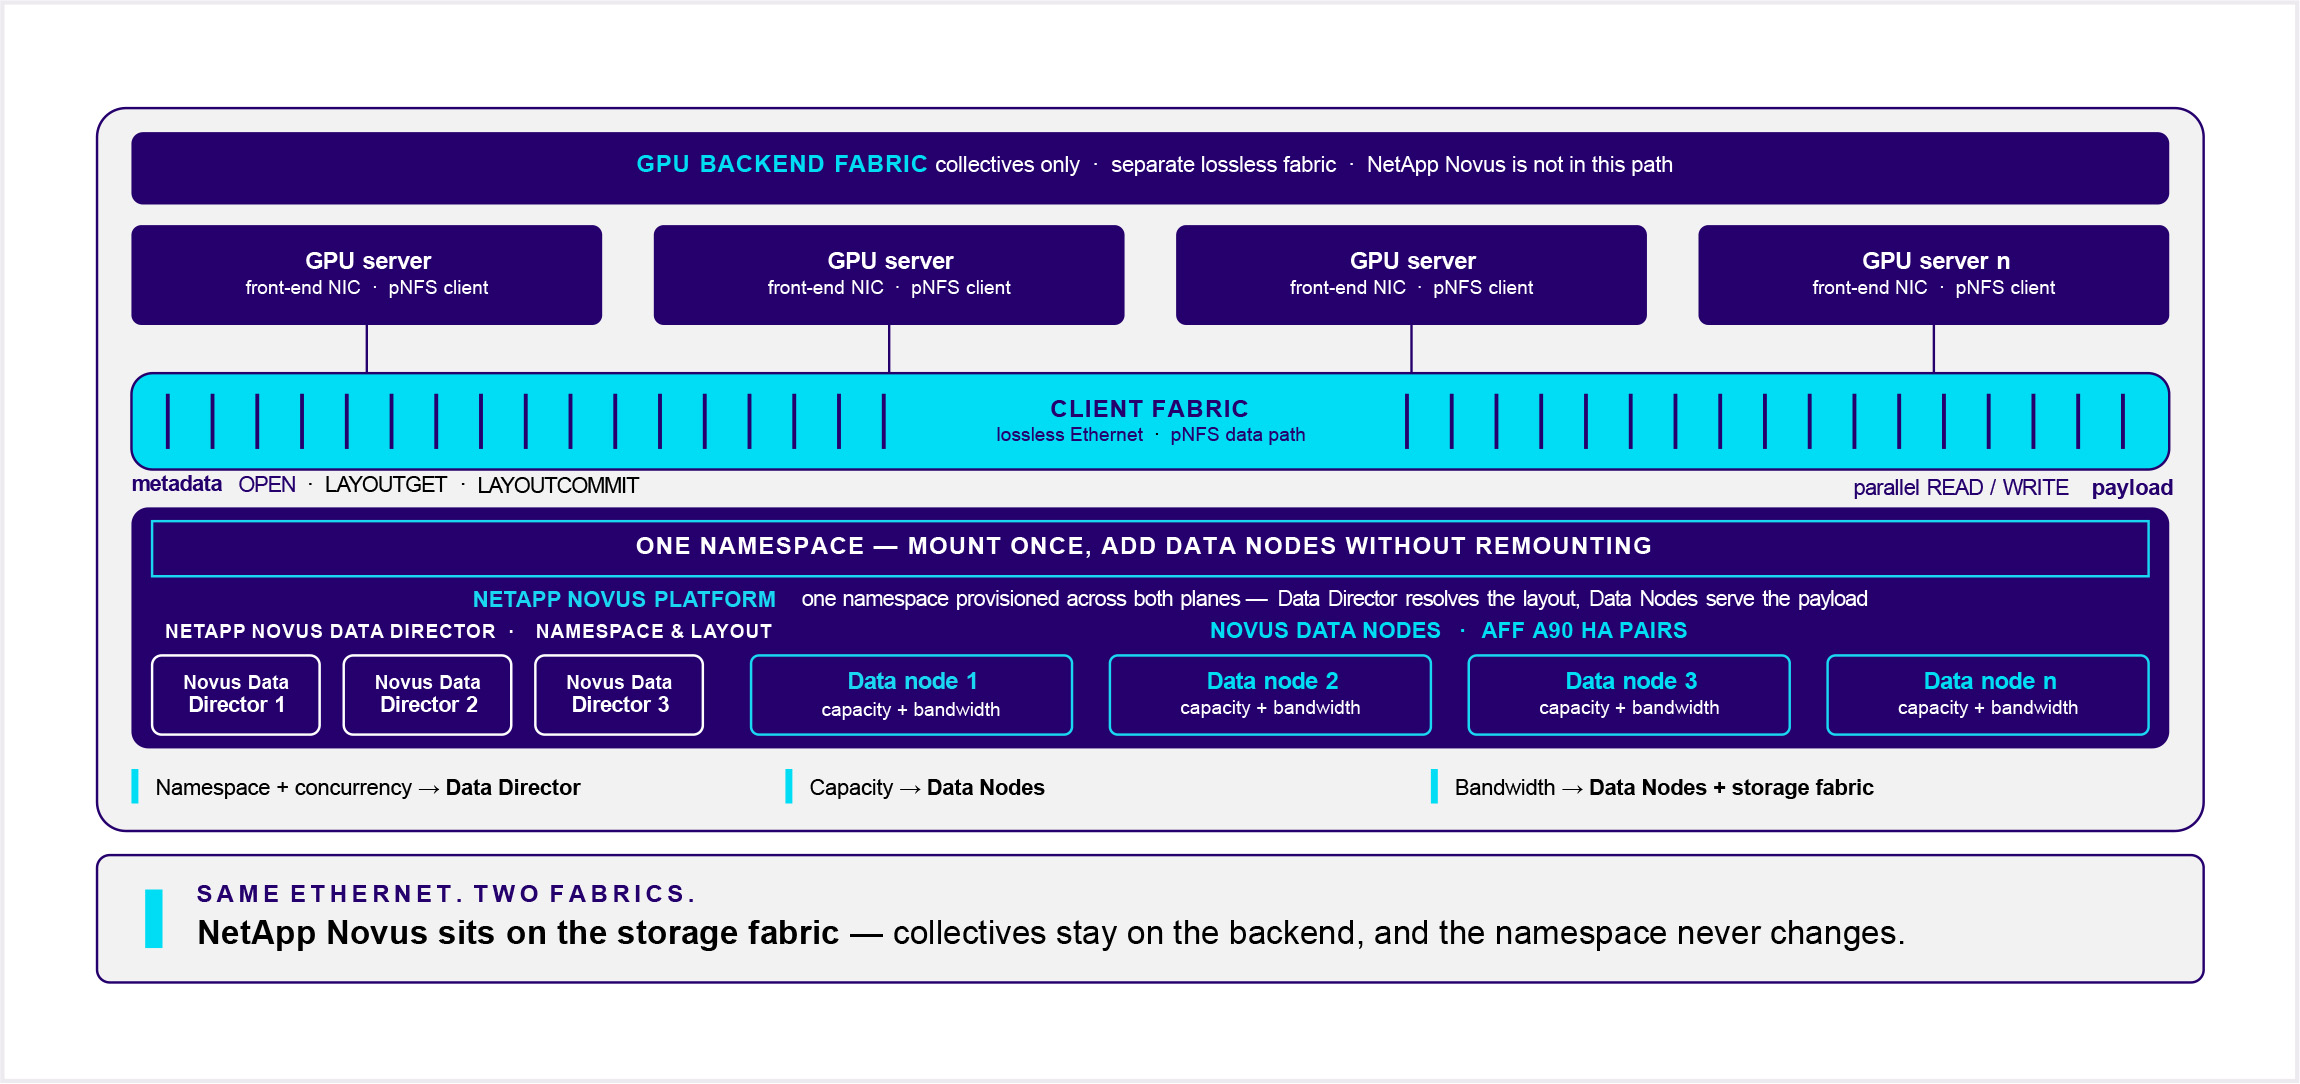
Novus Data Director separa la gestione dei metadati dal percorso dei dati, collocandola in un livello di controllo software-defined su sistemi x86 standard. Le prime release utilizzano infrastruttura Supermicro qualificata per Data Director e sistemi NetApp AFF A90 per i servizi dati ONTAP. La disaggregazione permette di aumentare le risorse dedicate ai metadati, al throughput e alla capacità secondo le esigenze del carico di lavoro, all’interno della stessa architettura.
Accesso diretto ai dati con client NFS standard
Durante una lettura o una scrittura, il client chiede al server dei metadati la mappa che identifica la posizione dei dati e poi accede direttamente al livello storage. Data Director gestisce il layout, mentre ONTAP sugli AFF A90 trasferisce i dati alla velocità di linea, con piani indipendenti. Ogni sistema aggiunto contribuisce alle prestazioni complessive; l’inserimento di un cluster aggiunge il suo throughput senza richiedere nuovi mount o frammentare il namespace visto dalle GPU.
L’accesso utilizza client NFSv4.2 e pNFS Flex Files standard integrati nel kernel, con supporto per nconnect e GPUDirect Storage negli ambienti Linux supportati. L’impiego dei client standard evita l’installazione di software proprietario sui server GPU, con meno aggiornamenti e validazioni delle immagini dei nodi al cambiare di kernel, GPU e tenant.
La rimozione dei colli di bottiglia dello storage permette di aumentare l’utilizzo delle risorse di calcolo già installate e il ritorno sull’investimento, senza aggiungere un altro rack di GPU.
Un namespace fino allo zettabyte
Novus consente a miliardi di file e grandi dataset AI di crescere in un unico namespace, federando le risorse dati ONTAP e conservando un ambiente di accesso comune. Prestazioni, capacità e concorrenza possono aumentare indipendentemente, evitando la creazione di silos di storage e la frammentazione operativa.
Il namespace comune evita spostamenti, nuovi mount, riequilibri e tracciamento delle copie tra sistemi separati. Dataset, checkpoint e artefatti dei modelli restano indirizzabili durante l’espansione, senza modifiche applicative o interruzioni dei tenant, attraverso migliaia di nodi storage.
Gary Grider, Senior Director for Computing Technologies dei Los Alamos National Labs, sottolinea “la scalabilità indipendente sia del livello dei metadati sia del livello dei dati”. Il punto riguarda la possibilità per le AI factory di crescere mantenendo l’accesso ai dati, mentre centinaia di migliaia di GPU interrogano lo stesso namespace e aumentano il carico dei metadati.
Multi-tenancy, sicurezza ed efficienza
Per gli ambienti condivisi, Novus combina resilienza, sicurezza e multi-tenancy di ONTAP con la gestione disaggregata dei metadati. La qualità del servizio mantiene isolati i tenant e prevedibili i carichi anche con migliaia di job concorrenti.
La possibilità di scalare soltanto le risorse necessarie a ciascun carico di lavoro contribuisce a ridurre consumo energetico, spazio occupato e overhead infrastrutturale, preservando le funzioni enterprise richieste dagli operatori delle AI factory multi-tenant su scala cloud.
“Man mano che i provider di infrastrutture AI scalano gli ambienti GPU, la redditività dipende sempre più dal mantenimento di un pieno utilizzo delle risorse di calcolo”, afferma Mike Leone, Vice President & Principal Analyst di Moor Insights & Strategy. “Le architetture di storage che non riescono a fornire dati su scala in cloud possono diventare un fattore limitante per le prestazioni del training, l’isolamento dei tenant e il ROI infrastrutturale. NetApp Novus affronta direttamente questo limite combinando una gestione disaggregata dei metadati con servizi dati ad alte prestazioni, offrendo a neocloud e provider di GPU-as-a-Service una base più scalabile per le operazioni delle AI factory”.
Sul rapporto fra calcolo, rete e dati interviene anche Jeremy Foster, Senior Vice President e General Manager di Cisco Compute: “La nostra collaborazione di lunga data con NetApp punta a unire calcolo, networking e dati”. Foster aggiunge: “Man mano che l’AI spinge l’infrastruttura verso nuovi livelli di scala e velocità, la vera differenziazione non è la GPU, ma i dati e il modo in cui i clienti li utilizzano. NetApp Novus, insieme al resto dello stack, aiuta i clienti a valorizzare questi dati e a ottenere i risultati più importanti per il loro business”.
Prime configurazioni già ordinabili
L’architettura iniziale, con Novus Data Director su Supermicro e ONTAP sui sistemi AFF A90, è già ordinabile. NetApp prevede un percorso graduale verso implementazioni software-defined, mantenendo lo stesso namespace, lo stesso modello operativo e la stessa base di dati.