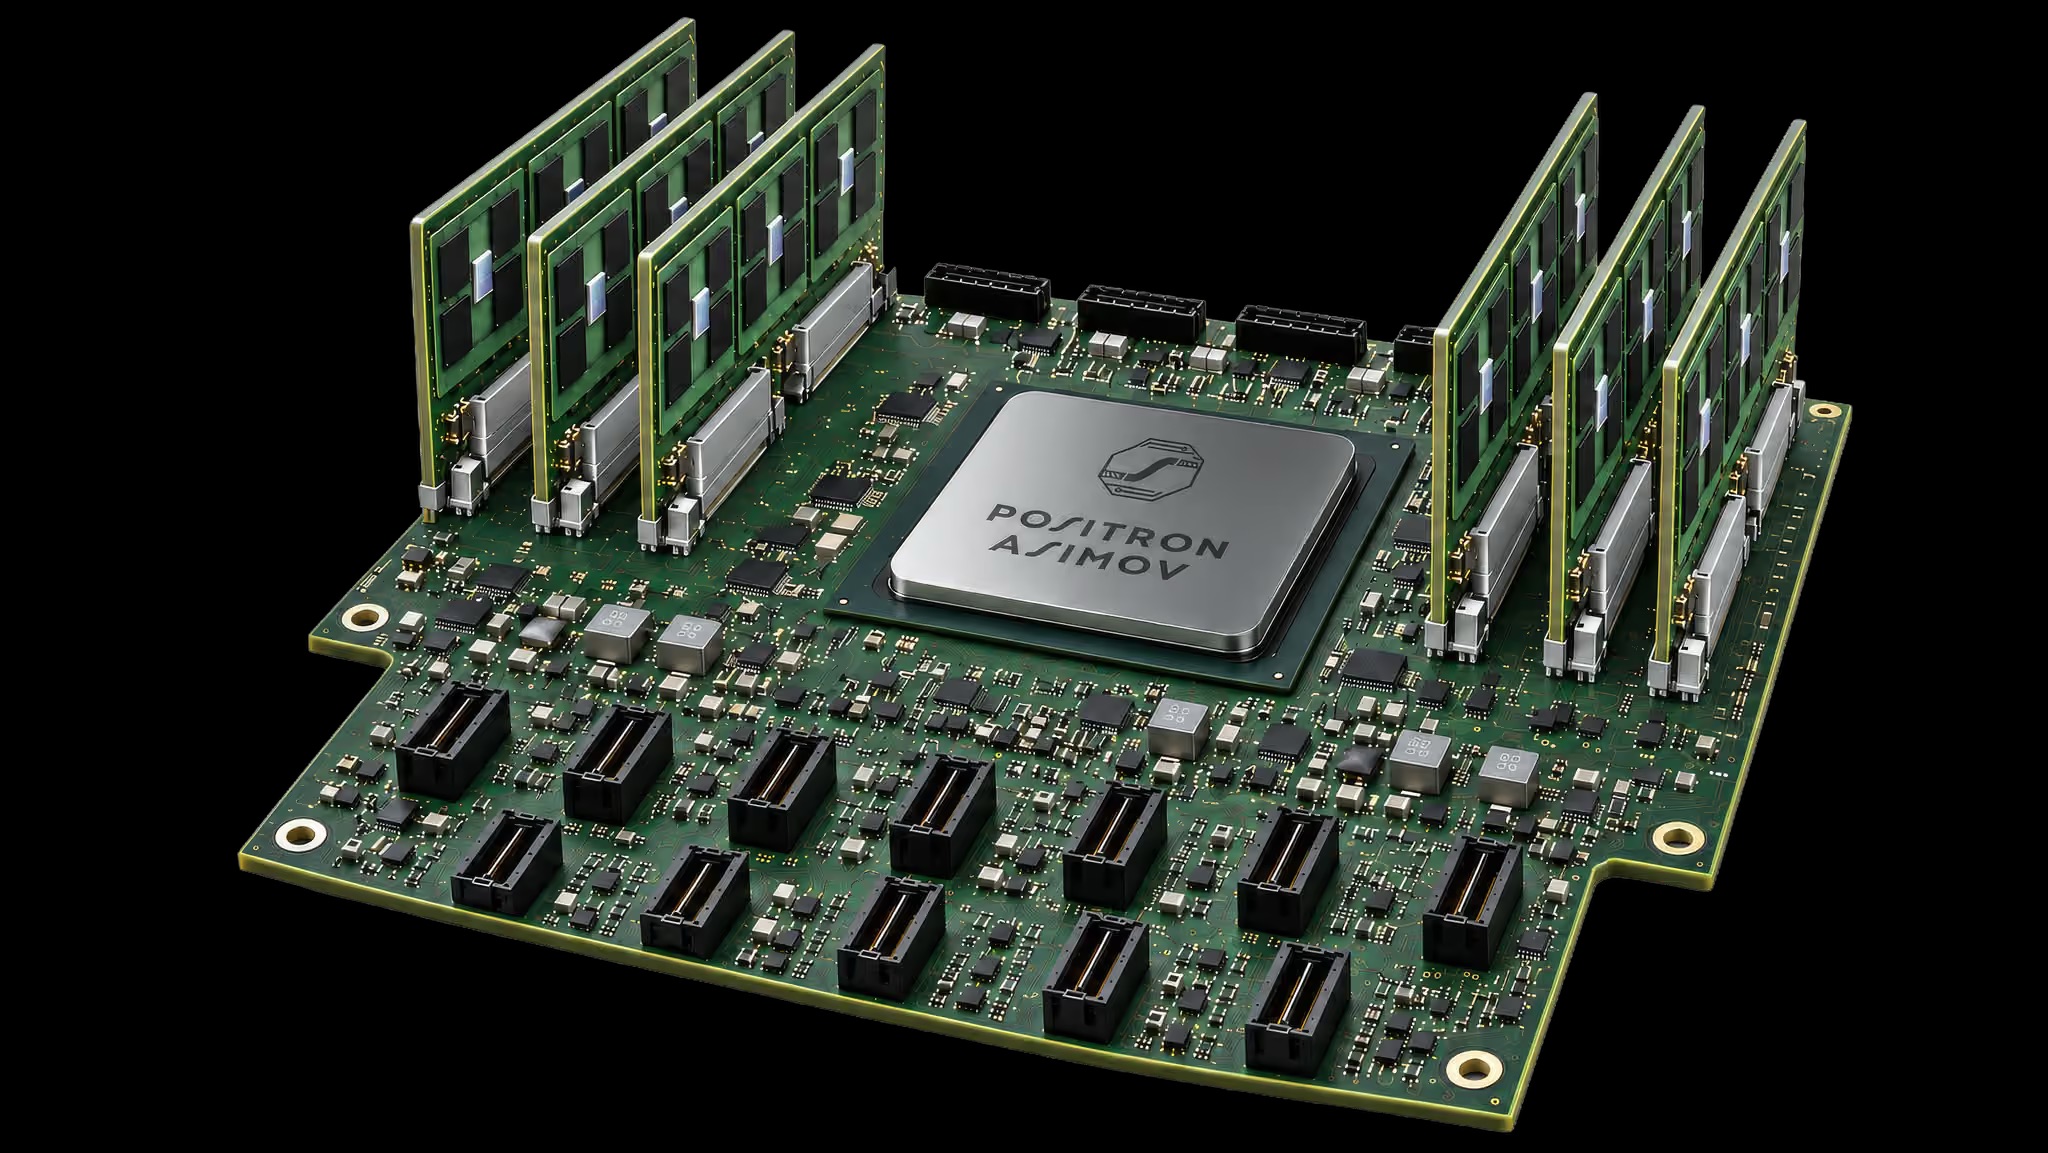
Un finanziamento da 875 milioni di dollari, accompagnato da una valutazione post-money di 5 miliardi, dà a Positron AI le risorse per trasformare la propria architettura dedicata all’inferenza in una piattaforma di seconda generazione. La società, con sede a Reno, in Nevada, userà il capitale per completare il tape-out – il passaggio conclusivo della progettazione, nel quale il layout definitivo del chip viene inviato alla fonderia per avviarne la fabbricazione – di Asimov, allestire un data center ingegneristico da oltre 2 MW e avviare la produzione di Titan, il sistema che riunirà da quattro a otto acceleratori Asimov.
Il round di serie C è stato articolato in due tranche: 375 milioni a una valutazione pre-money di 3,5 miliardi e una serie C-1 fino a 500 milioni. Tra i co-lead investor figurano NEA, Atreides Management, Valor Equity Partners, Andra Capital, SemiAnalysis Capital di Dylan Patel e Jim Clark, fondatore di Silicon Graphics e cofondatore di Netscape. Al gruppo si aggiungono investitori finanziari e strategici quali Qatar Investment Authority, Cisco Investments, Naver Ventures, VentureTech Alliance e Hudson River Trading.
Il nuovo passaggio finanziario arriva appena sette mesi dopo una serie B da 230 milioni di dollari, chiusa nel febbraio 2026 con una valutazione superiore al miliardo. La crescita del valore attribuito alla società riflette il peso che l’inferenza sta assumendo nell’economia dell’intelligenza artificiale: una volta addestrati, i modelli devono rispondere in modo continuativo a utenti, agenti e applicazioni, trasformando capacità di memoria, banda e disponibilità energetica in vincoli operativi centrali.
I capitali si spostano verso l’hardware per l’inferenza
Il finanziamento di Positron AI si inserisce in un movimento internazionale nel quale nuovi produttori progettano silicio e sistemi partendo dalle caratteristiche dell’inferenza. Il capitale raccolto dal settore indica che la specializzazione sta diventando una categoria industriale autonoma: nell’agosto 2026 Etched ha ottenuto 700 milioni di dollari a una valutazione di 21 miliardi, dopo avere consegnato il primo rack a Jane Street; nel novembre 2025 d-Matrix ha chiuso una serie C da 275 milioni a una valutazione di 2 miliardi; FuriosaAI ha raccolto 125 milioni per aumentare la produzione di RNGD, entrato nella produzione di massa nel 2026. Groq, tra i pionieri degli acceleratori dedicati, ha spostato il baricentro verso l’erogazione del calcolo e nel giugno 2026 ha ricevuto 650 milioni per ampliare il proprio cloud di inferenza.
Il quadro comprende aziende con gradi diversi di maturità, modelli commerciali differenti e architetture che non possono essere ricondotte a un unico schema. Etched sviluppa cluster completi per i modelli di frontiera attraverso il co-design di chip, rack, software, alimentazione e raffreddamento. d-Matrix integra calcolo e memoria nell’acceleratore Corsair e affianca al silicio networking e software ottimizzati per l’inferenza nei data center. FuriosaAI usa la tensor contraction come primitiva dell’architettura RNGD, disponibile sotto forma di scheda PCIe e server. Groq ha costruito il proprio posizionamento sulla bassa latenza delle LPU e oggi monetizza soprattutto quella competenza attraverso un servizio cloud distribuito.
Anche l’Europa partecipa a questa corsa con progetti che coprono livelli diversi dell’infrastruttura. Euclyd ha raccolto oltre 200 milioni di euro per Craftwerk, un system-in-package destinato ai foundation model e ai sistemi rack-scale, mentre Axelera AI ha superato i 250 milioni di dollari nell’ultimo round e sta estendendo il Digital In-Memory Computing dai dispositivi edge ai server e all’HPC. Tenstorrent segue un percorso ancora diverso, fondato su core Tensix, software open source e licenze di proprietà intellettuale RISC-V e AI.
La varietà delle soluzioni rende più evidente il denominatore comune. Spostare pesi, attivazioni e KV cache tra memoria e unità di calcolo richiede tempo ed energia; all’aumentare dei modelli, delle finestre di contesto e del numero di passaggi eseguiti dagli agenti, questo movimento dei dati incide direttamente sul costo del servizio. Le nuove architetture intervengono quindi sulla gerarchia di memoria, sul dataflow, sull’interconnessione o sulla collocazione delle operazioni, scegliendo di volta in volta HBM, LPDDR, SRAM e tecniche di in-memory computing.
Cambiano di conseguenza anche le metriche e il perimetro della competizione. Alla potenza aritmetica teorica si affiancano costo per token, token per watt, latenza e throughput con richieste concorrenti, insieme alla quantità di modello o di contesto mantenibile in memoria. Il prodotto tende a comprendere l’intero percorso dal transistor al servizio: chip, packaging, memoria, rete, rack, raffreddamento, compilatore, librerie e API vengono coordinati perché una singola innovazione perde efficacia quando incontra un collo di bottiglia in un altro livello dello stack.
I round finanziano proprio questo passaggio dal progetto del processore alla capacità industriale. Servono capitali per il tape-out, le prenotazioni presso le fonderie, il packaging avanzato, la memoria, i laboratori di validazione, la produzione dei server e lo sviluppo del software; a questi investimenti si aggiunge la costruzione di cloud o programmi di accesso che consentano ai clienti di provare un’architettura diversa dalle GPU già presenti nei loro ambienti. La competizione sull’inferenza riguarda quindi tanto il silicio quanto la possibilità di produrlo, distribuirlo e renderlo programmabile su scala commerciale.
Una società costruita attorno all’inferenza
Fondata nell’aprile 2023, Positron AI ha scelto fin dall’inizio di specializzarsi nell’esecuzione dei modelli Transformer. La società, guidata dal CEO Mitesh Agrawal e con il cofondatore Thomas Sohmers nel ruolo di chairman, conta oggi oltre cento dipendenti distribuiti tra Stati Uniti, Canada e Israele. Il suo primo prototipo è stato mostrato alla NeurIPS, una delle principali conferenze internazionali dedicate all’intelligenza artificiale e al machine learning, nel dicembre 2023; nell’agosto successivo è arrivata la prima consegna di Atlas, il sistema commerciale con cui l’azienda ha verificato sul campo la propria impostazione.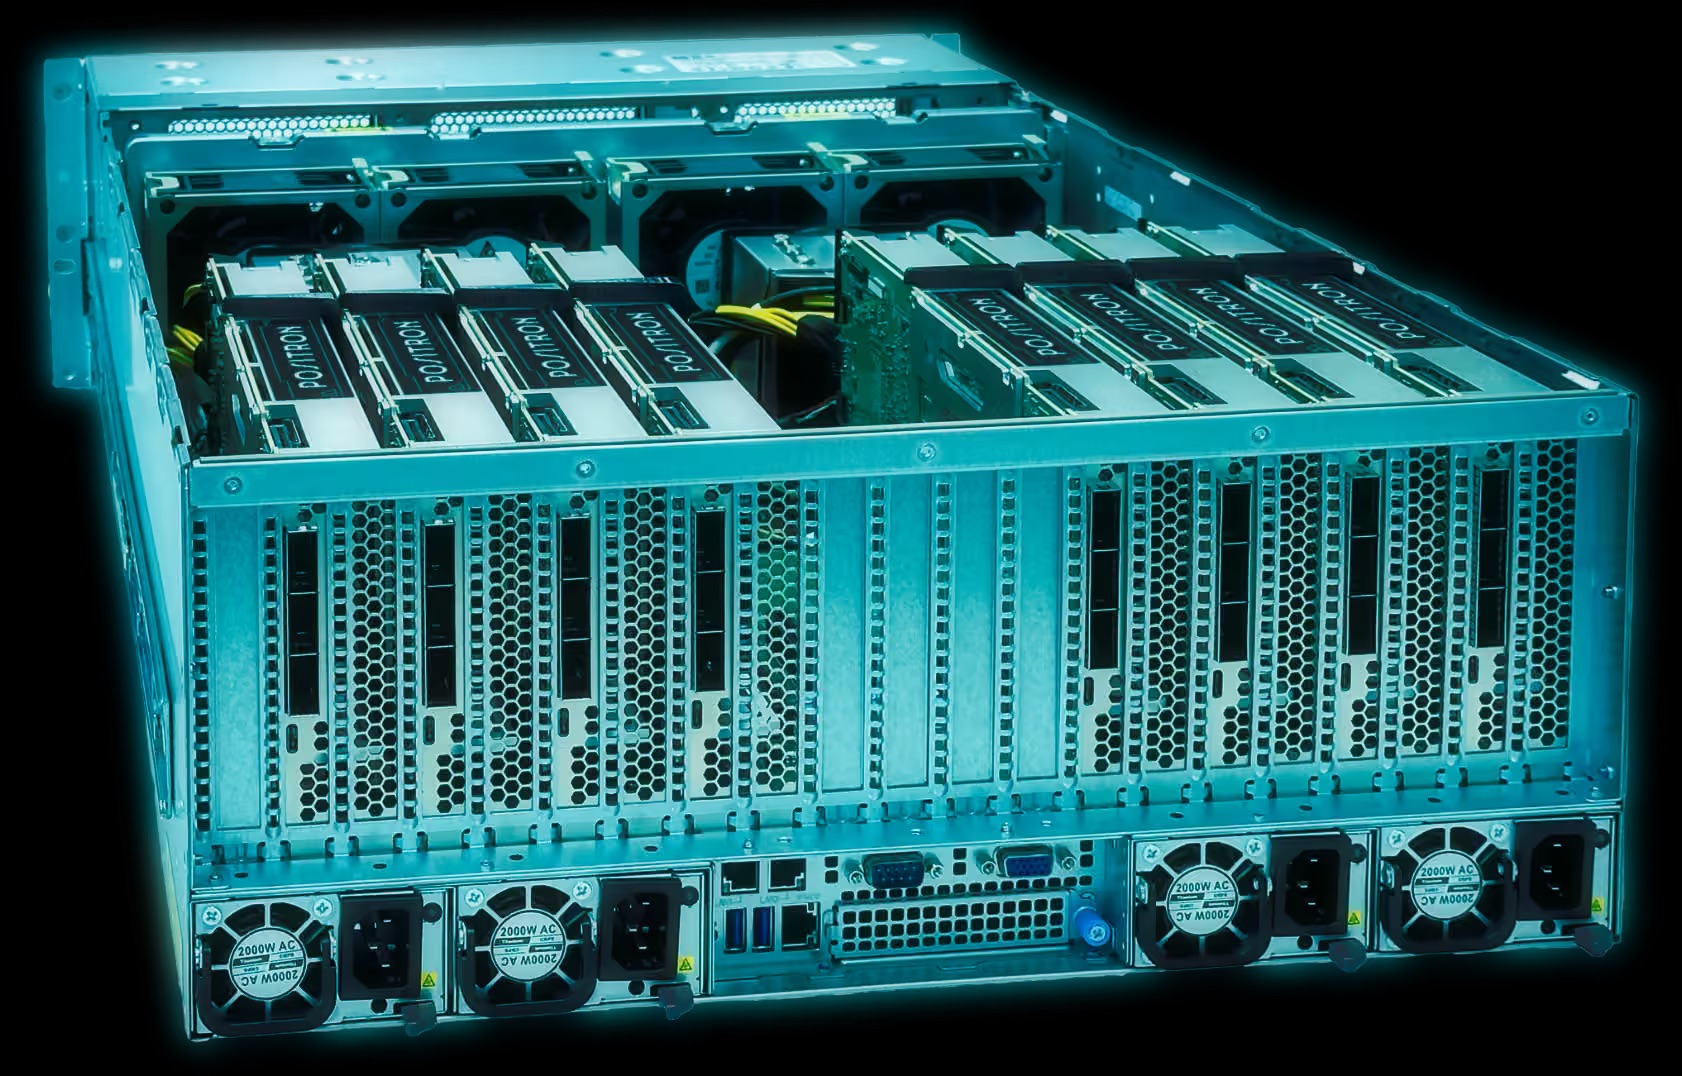
Atlas è un server 4U equipaggiato con otto acceleratori Archer e 256 GB complessivi di memoria HBM, affiancati da due processori AMD Epyc. L’appliance assorbe 2.000 watt e comprende il motore di inferenza e gli strumenti software gestiti da Positron. Nell’esecuzione di Llama 3.1 8B in BF16, Atlas raggiunge 280 token al secondo per utente, contro i 182 di un Nvidia DGX H200, superandolo di oltre tre volte nelle prestazioni per dollaro e di oltre quattro volte nelle prestazioni per watt.
La presenza presso clienti reali distingue questa fase della società da quella di molte startup di semiconduttori ancora concentrate sul progetto del primo chip. Positron sta installando più di 50 rack Atlas nei data center di Oracle Cloud Infrastructure, capacità iimpiegata anche dal partner Parasail per il proprio servizio di inferenza. Tra i clienti che utilizzano Atlas in produzione figurano Jump Trading, società globale di trading con una forte componente di ricerca e infrastruttura tecnologica proprietaria, e i3D.net, operatore olandese di cloud privato gestito, server bare metal e reti a bassa latenza.
Asimov mette la memoria al centro
L’esperienza raccolta con Atlas confluisce in Asimov, un ASIC progettato per i carichi nei quali lo spostamento dei dati incide più della capacità di calcolo teorica. Durante la generazione di un token, i pesi del modello devono essere letti ripetutamente dalla memoria; per questo la velocità effettiva dipende in larga misura dalla banda utilizzabile e dalla quantità di memoria disponibile vicino all’acceleratore. Positron dimensiona quindi calcolo e trasferimento dei dati come parti dello stesso problema, arrivando a sfruttare oltre il 90% della banda disponibile sui carichi Transformer.
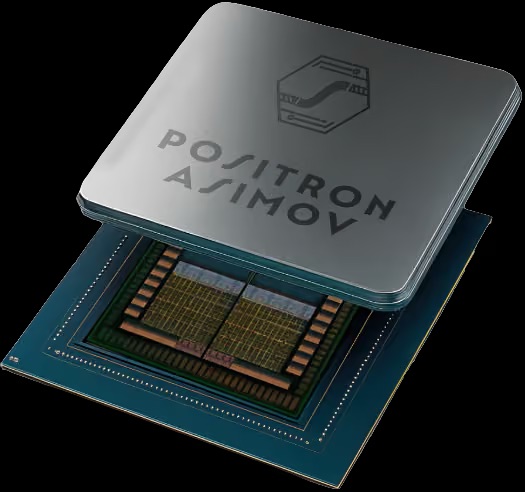
La scelta più caratterizzante riguarda l’impiego di memoria LPDDR5X al posto della HBM adottata dagli acceleratori AI di fascia alta. La banda teorica della LPDDR è inferiore, ma l’architettura di Positron compensa questo limite con un utilizzo più elevato delle risorse e con una capacità molto superiore per singolo chip. Asimov sarà disponibile in configurazioni da 288 GB fino a 2,3 TB, con una banda effettiva di 2,76 TB/s e un TDP di circa 400 watt, compatibile sia con raffreddamento ad aria sia con sistemi a liquido.
Il motore di calcolo TransWarp è progettato per mantenere i dati il più vicino possibile alle unità che li elaborano, riducendo i trasferimenti che aumentano consumi e latenza. Circuiti dedicati eseguono direttamente alcune delle operazioni più frequenti nei modelli Transformer, mentre i core Armv9 conservano la flessibilità necessaria per gestire funzioni nuove o meno comuni. Nei sistemi con più acceleratori, i chip comunicano direttamente a 16 Tbps e possono così suddividersi il lavoro senza passare attraverso switch o schede di rete intermedi.
Asimov sarà prodotto da TSMC con il processo N3P, un’evoluzione del nodo produttivo a 3 nanometri sviluppata per migliorare prestazioni ed efficienza energetica. Il tape-out è previsto entro la fine del 2026, seguito dall’avvio della produzione nella seconda metà del 2027. Le simulazioni cycle-accurate collocano il chip fino a cinque volte sopra Nvidia Rubin nei token per dollaro e per watt sui carichi analizzati.
Titan, l’architettura alla scala di sistema
Quattro oppure otto chip Asimov formeranno Titan, un sistema 4U con un massimo di 18,4 TB di memoria collegata direttamente agli acceleratori e fino a 6 TB di memoria host. Questa dotazione è pensata per modelli di dimensioni molto elevate, finestre di contesto superiori a 10 milioni di token e applicazioni agentiche o multimodali che devono mantenere grandi quantità di stato disponibili senza continui trasferimenti dallo storage.
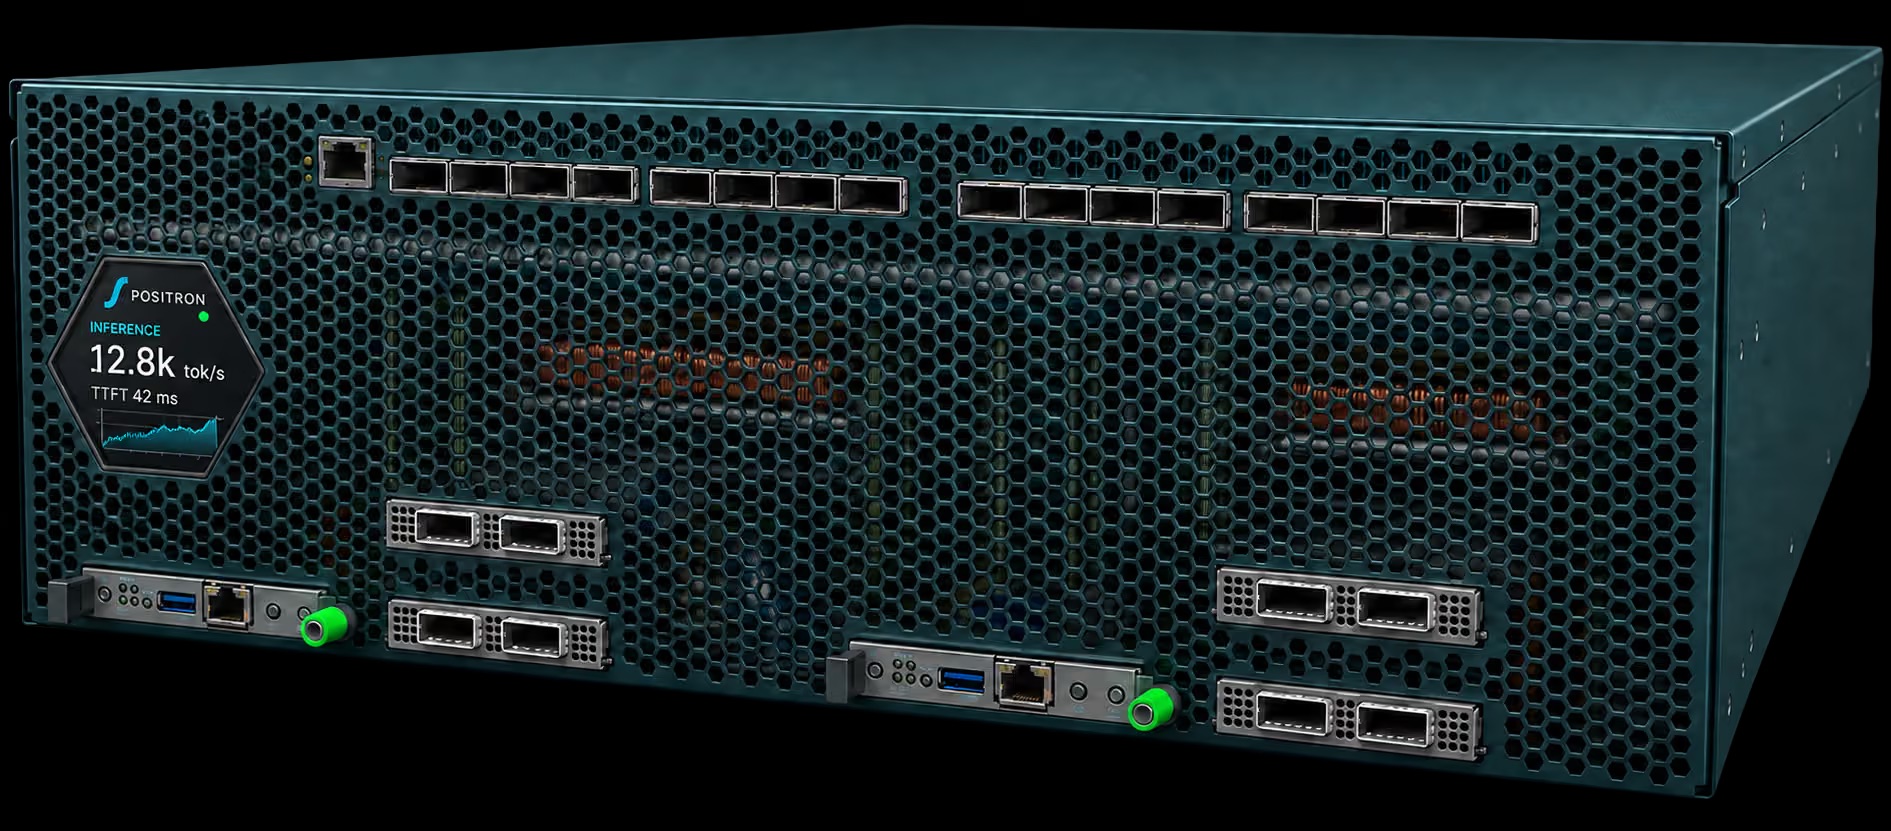
Asimov è ottimizzato soprattutto per la fase di decode generativo e per i carichi limitati da banda e capacità di memoria, mentre GPU e altri acceleratori possono occuparsi delle operazioni a maggiore densità di calcolo. Anche il livello software è costruito per ridurre l’attrito di adozione: i modelli della libreria Hugging Face possono essere caricati attraverso il Model Manager e le applicazioni dialogano con il sistema mediante endpoint compatibili con le API OpenAI.
Il capitale raccolto copre inoltre gli impegni di fornitura per la memoria LPDDR5X, la capacità produttiva, l’integrazione dei sistemi e l’espansione commerciale. Il passaggio decisivo sarà scandito da due verifiche industriali già fissate nel calendario: il tape-out di Asimov alla fine del 2026 e l’entrata in produzione di chip e sistemi Titan nella seconda metà del 2027.