Cloudflare amplia la famiglia dei modelli di intelligenza artificiale specializzati con Clairic, il primo esponente della nuova categoria System One Extraction, capace di estrarre informazioni da testi e immagini, eseguire calcoli, stimare valori e formulare previsioni senza ricorrere alla generazione autoregressiva di token utilizzata dai grandi modelli linguistici.
Disponibile in anteprima sulla piattaforma Workers AI, Clairic elabora gli input attraverso un singolo passaggio della rete neurale, restituendo direttamente risultati numerici e strutturati. La denominazione System One richiama il Sistema 1 descritto dallo psicologo Daniel Kahneman, associato al pensiero rapido e intuitivo, contrapposto al Sistema 2, caratterizzato dal ragionamento deliberato. Cloudflare utilizza questa analogia per distinguere i modelli specializzati nelle operazioni rapide e circoscritte dagli LLM, che possono affrontare compiti più articolati.
La tecnologia si rivolge soprattutto ai processi aziendali che richiedono di trasformare documenti e informazioni non strutturate in dati utilizzabili direttamente dalle applicazioni, dalla gestione amministrativa al servizio clienti, fino alle attività di analisi e previsione.
Dai modelli decisionali Jev e Clef all’estrazione dei dati
La famiglia System One ha attirato l’attenzione con Jev di TypeSafe AI, specializzato nella valutazione probabilistica delle alternative disponibili. Cloudflare ha successivamente sviluppato Clef e Clef-flash, che condividono questa impostazione e restituiscono scelte, punteggi e probabilità utilizzabili direttamente dal software.
Clairic estende l’architettura a problemi nei quali il risultato non appartiene necessariamente a un insieme prestabilito. Un modello decisionale può stabilire se una richiesta di rimborso debba essere approvata, respinta o sottoposta a verifica, mentre Clairic può determinarne l’importo, calcolare il tempo trascorso dalla consegna oppure stimare il costo di una riparazione.
Dal punto di vista del machine learning, la distinzione corrisponde a tre differenti categorie di elaborazione: estrazione e regressione per Clairic, classificazione per Jev e Clef, generazione per gli LLM. I primi restituiscono valori tipizzati all’interno di intervalli definiti, i secondi scelgono fra opzioni discrete, mentre i modelli linguistici producono sequenze di testo.
Le applicazioni possono combinare queste capacità all’interno dello stesso workflow, affidando a ciascun modello le operazioni per le quali offre il rapporto più conveniente tra accuratezza, latenza e costo computazionale.
Come funziona Clairic: campi tipizzati e risultati verificabili
L’interfaccia di Clairic richiede due elementi principali: uno state, contenente le informazioni da elaborare, e uno schema di fields, che descrive i valori da ottenere e i rispettivi tipi. Ogni campo può comprendere istruzioni in linguaggio naturale e vincoli specifici, come il numero di decimali, l’unità di misura o l’intervallo numerico consentito.
I tipi supportati comprendono text, number, date, time, datetime, duration, list, estimate e forecast. Date e orari vengono restituiti nel formato ISO, mentre le durate utilizzano l’unità specificata nella richiesta. I risultati rispettano lo schema dichiarato, evitando alle applicazioni di interpretare risposte testuali e convertirle successivamente.
Il modello dispone di una finestra di contesto di 65.536 token e accetta fino a quattro immagini PNG, JPEG o WebP per richiesta.
Tutti i campi vengono elaborati in parallelo. Secondo Cloudflare, richiederne trenta anziché tre comporta un costo approssimativamente equivalente, poiché l’elaborazione non richiede la generazione sequenziale di una risposta per ciascuno. Il numero di campi non ha un limite prefissato: quando non possono essere gestiti insieme, il servizio suddivide il lavoro in più passaggi paralleli, ciascuno dei quali riceve l’intero input, e successivamente ricompone i risultati.
Estrazione dei dati, confidenza e gestione delle informazioni mancanti
Nella gestione di un reclamo per un prodotto danneggiato, Clairic può identificare dal messaggio del cliente il numero d’ordine, la data della consegna e i danni segnalati, calcolando anche l’importo complessivamente pagato e i giorni trascorsi dall’acquisto. A partire da un acquisto di 649 dollari più 52,10 dollari di imposte e da una consegna avvenuta il 28 settembre 2026, il modello ha ricavato un totale di 701,10 dollari e un intervallo di 11 giorni rispetto al reclamo presentato il 9 ottobre.
Quando estrae una porzione di testo, Clairic restituisce anche gli offset dei caratteri, che ne identificano la posizione esatta nella fonte originale. L’applicazione può così evidenziare il passaggio dal quale proviene un’informazione, facilitando la verifica dei risultati e la loro associazione ai documenti.
Per i valori scalari, l’output comprende confidence, un indicatore di affidabilità, e p_null, che esprime la probabilità che il valore richiesto non sia ricavabile dall’input. È inoltre disponibile guess, il candidato individuato dal modello anche quando il risultato definitivo viene considerato assente.
Se il messaggio non contiene un numero di tracciamento, Clairic può restituire null, conservando separatamente un eventuale candidato individuato durante l’elaborazione. Le applicazioni possono utilizzare questi indicatori per impostare soglie di affidabilità, procedere automaticamente nei casi più chiari e richiedere verifiche sui risultati incerti.
Estrazione delle informazioni anche dalle immagini
Le capacità di Clairic comprendono anche documenti fotografati e immagini contenenti informazioni testuali. Da uno scontrino acquisito con un’angolazione sfavorevole e caratteri non perfettamente leggibili, il modello è riuscito a identificare il numero d’ordine, la data e l’ora dell’acquisto, la quantità, il prezzo unitario, il subtotale, le imposte e la mancia, riconoscendo anche l’assenza di uno sconto.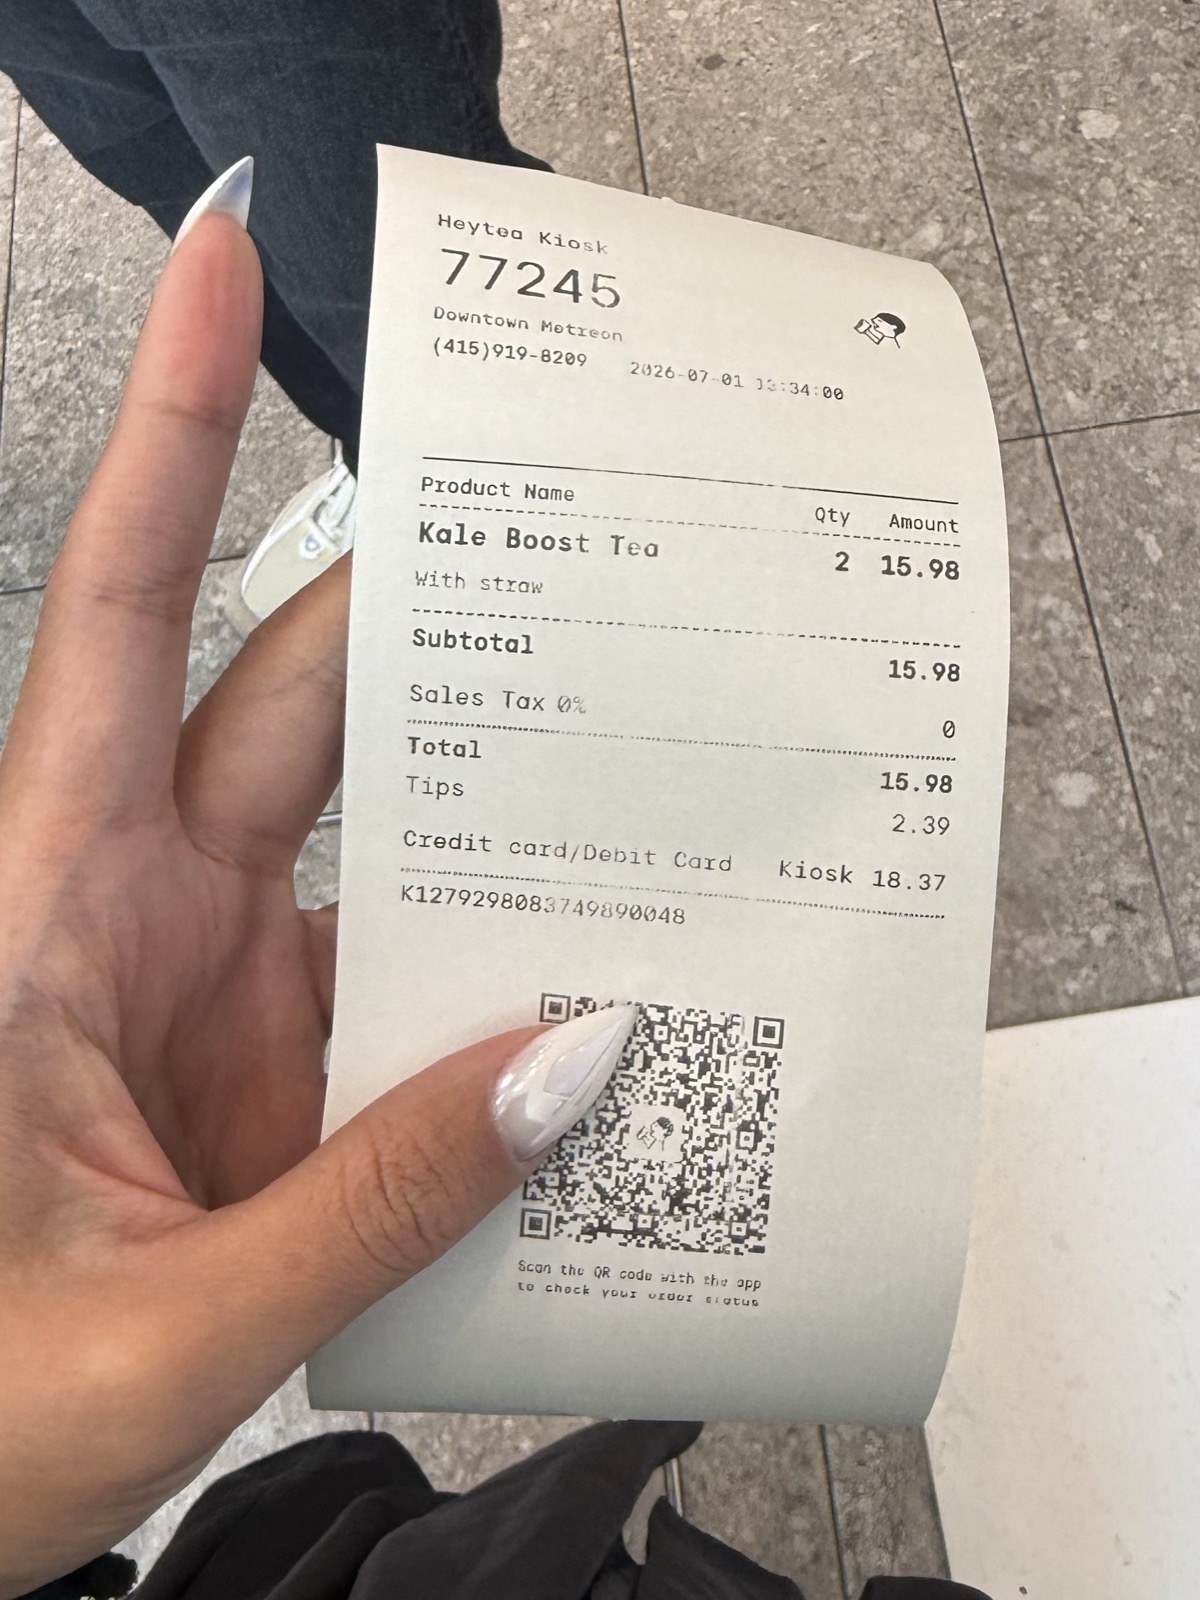
Ogni valore viene accompagnato da una misura di confidenza, che permette di distinguere le informazioni lette con elevata affidabilità da quelle più incerte. Il numero d’ordine, per esempio, può presentare un livello di confidenza inferiore rispetto alla quantità acquistata e al prezzo unitario, consentendo di selezionare i campi da sottoporre a controllo.
{
  "model": "clairic",
  "answers": {
    "order_number": {
      "type": "number",
      "p_null": 0.0040206750854849815,
      "guess": 77245,
      "confidence": 0.776249383996532,
      "value": 77245
    },
    "purchased_at": {
      "type": "datetime",
      "p_null": 4.136094133855295e-08,
      "guess": "2026-07-01T13:34:00",
      "confidence": 0.831464227002992,
      "value": "2026-07-01T13:34:00"
    },
    "quantity": {
      "type": "number",
      "p_null": 5.2313655629632194e-08,
      "guess": 2,
      "confidence": 0.9997007500403496,
      "value": 2
    },
    "unit_price": {
      "type": "number",
      "p_null": 0.001599092734977603,
      "guess": 7.99,
      "confidence": 0.9991279019989127,
      "value": 7.99
    },
    "subtotal": {
      "type": "number",
      "p_null": 9.69956488461321e-08,
      "guess": 15.98,
      "confidence": 0.9999881983893096,
      "value": 15.98
    },
    "sales_tax": {
      "type": "number",
      "p_null": 2.5511653802823275e-06,
      "guess": 0,
      "confidence": 0.9999800924450729,
      "value": 0
    },
    "tip": {
      "type": "number",
      "p_null": 5.953857908025384e-05,
      "guess": 2.39,
      "confidence": 0.9335768781214697,
      "value": 2.39
    },
    "discount": {
      "type": "number",
      "p_null": 0.9994148015975952,
      "guess": 0,
      "confidence": 0.91852733929319,
      "value": null
    }
  }
}
Il JSON restituito da Clairic contiene i valori estratti dallo scontrino fotografato, accompagnati dal livello di confidenza (confidence) e dalla probabilità che l’informazione richiesta sia assente (p_null). Nel caso dello sconto, il modello restituisce null, indicando che il dato non è presente nello scontrino, pur avendo identificato 0 come possibile valore (guess).
Questa modalità permette di automatizzare l’acquisizione documentale combinando riconoscimento delle informazioni, normalizzazione dei dati e verifica dell’affidabilità, senza dover utilizzare separatamente un sistema OCR e un modello linguistico per interpretarne il risultato.
Stime probabilistiche con intervalli e percentili
Oltre a individuare informazioni presenti nei documenti, Clairic può ricavare valori mediante operazioni aritmetiche e temporali oppure stimare grandezze non esplicitamente indicate, sulla base degli elementi disponibili.
Per le stime, lo sviluppatore definisce un intervallo minimo e massimo, il passo di discretizzazione e una scala lineare o logaritmica. Il modello restituisce un valore stimato, la mediana e un intervallo di probabilità dell’80%, delimitato dai percentili p10 e p90. Su richiesta può fornire anche tutti i 99 percentili, consentendo analisi più dettagliate della distribuzione prevista.
L’ampiezza della distribuzione permette di distinguere stime relativamente concentrate da previsioni caratterizzate da maggiore incertezza. La possibilità di elaborare più campi in parallelo consente inoltre di stimare numerosi valori in una sola richiesta, per esempio prezzi immobiliari, costi di riparazione o opportunità commerciali, utilizzando successivamente il software applicativo per confrontarli e ordinarli.
Previsioni di serie temporali a partire da dati non strutturati
Clairic supporta la previsione di serie temporali, con un orizzonte massimo di 64 intervalli futuri. I dati storici possono essere forniti come testo, esportazioni CSV, righe tabellari o informazioni numeriche accompagnate da note, senza richiedere necessariamente una pipeline dedicata alla preparazione dei dati.
Il campo forecast comprende parametri per definire l’orizzonte temporale, la frequenza delle osservazioni, i limiti dei valori previsti e la scala da utilizzare. Per ogni intervallo futuro, Clairic restituisce una stima e la relativa distribuzione probabilistica.
Le statistiche giornaliere della Transportation Security Administration relative ai passeggeri sottoposti ai controlli negli aeroporti statunitensi hanno fornito la base per una verifica delle capacità previsionali. Per 21 giorni consecutivi, Clairic ha ricevuto i dati effettivi disponibili fino al giorno precedente e ha stimato il traffico della giornata successiva.
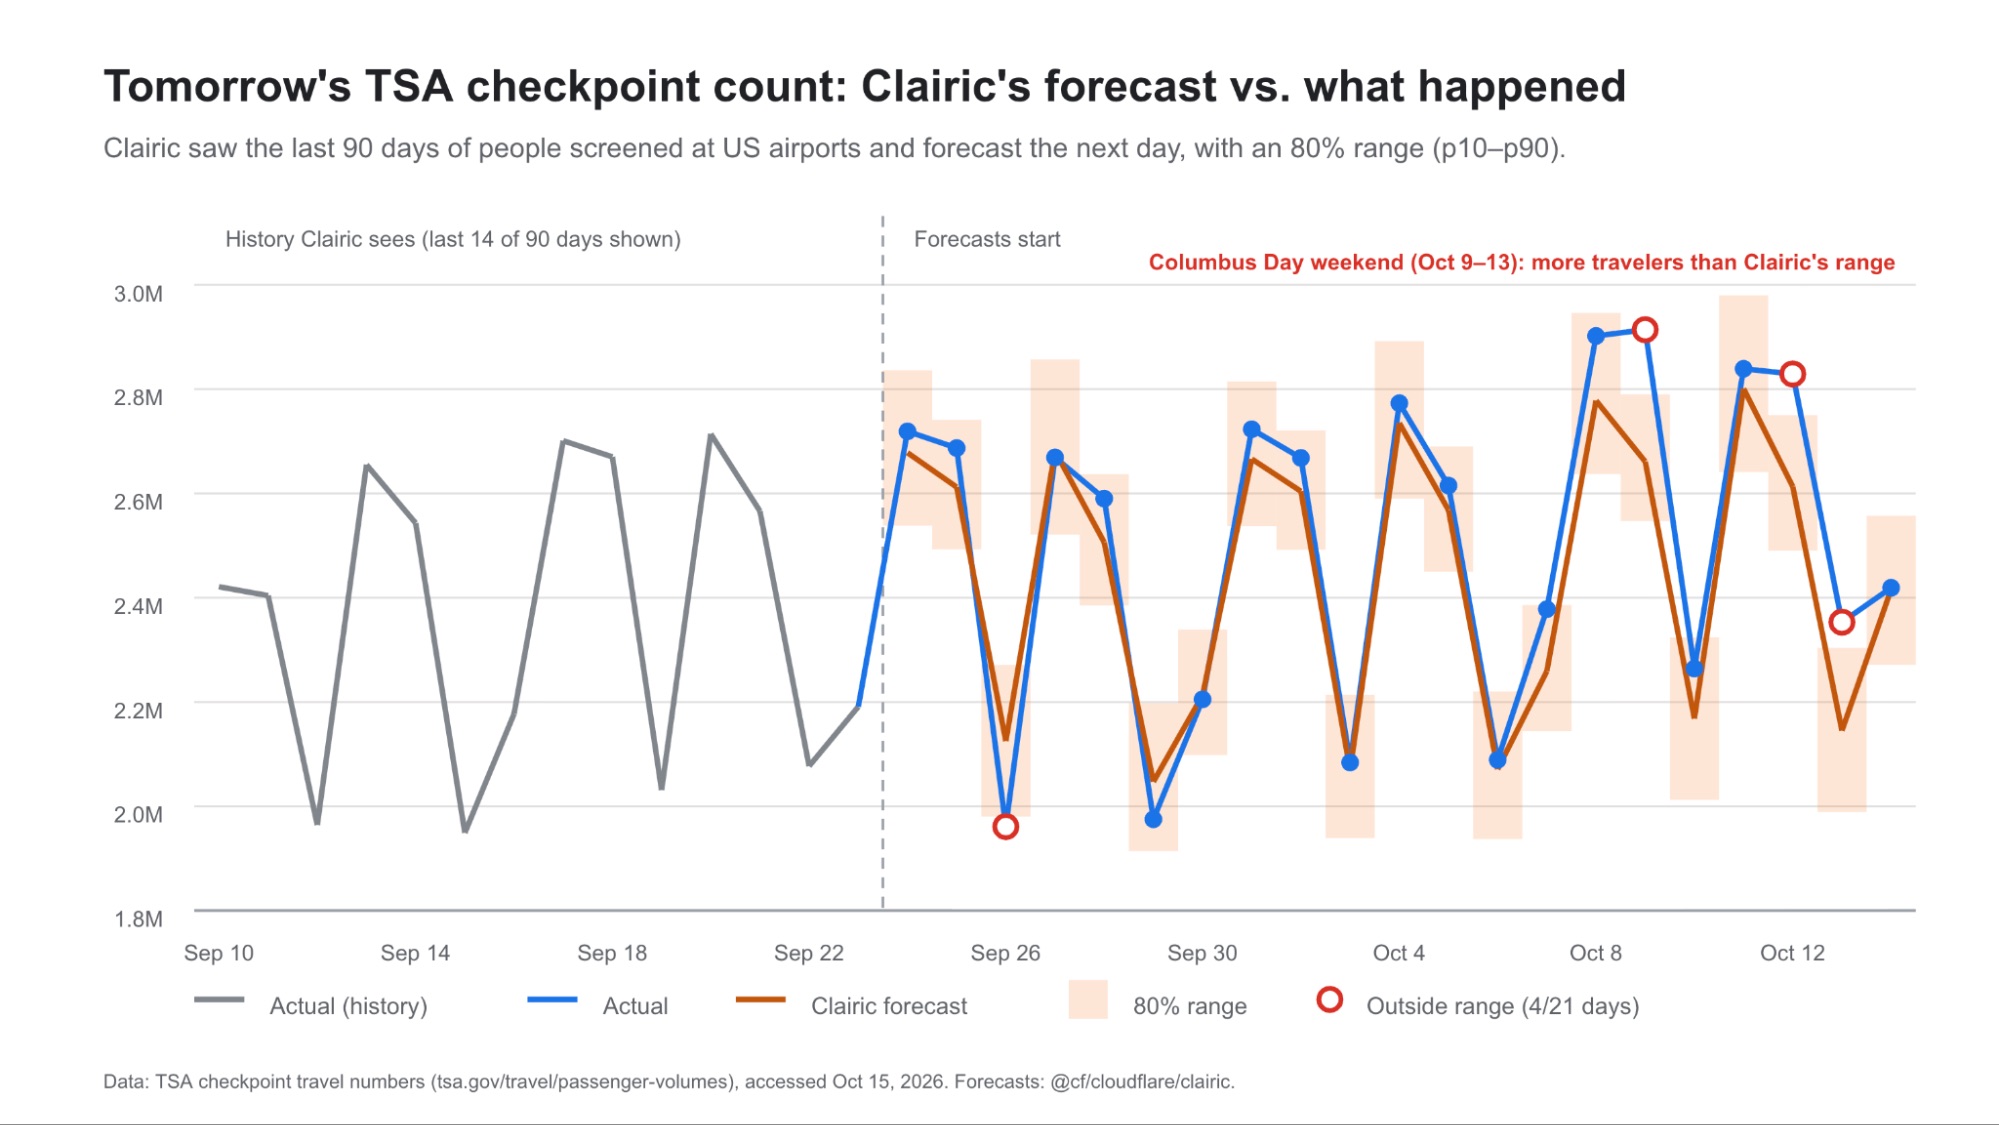
Durante il periodo di prova, l’errore medio dichiarato da Cloudflare è stato del 3,3%, mentre 17 risultati effettivi su 21 sono ricaduti nell’intervallo di probabilità dell’80% previsto dal modello. Per il 14 ottobre 2026, la mediana stimata era di 2.419.283 passeggeri, contro i 2.419.474 effettivamente registrati.
Il modello ha riconosciuto il ciclo settimanale del traffico, caratterizzato da volumi inferiori il martedì e il sabato e più elevati il giovedì, venerdì e domenica. Tre dei quattro risultati esterni agli intervalli previsti si sono verificati durante il fine settimana del Columbus Day, quando l’affluenza ha superato le tendenze delle settimane precedenti. Le previsioni riflettono quindi i pattern presenti nei dati storici, mentre eventi esterni e variazioni eccezionali richiedono informazioni aggiuntive.
Clairic, Clef e GLM-5.3 nello stesso workflow
L’automazione dei reclami può combinare Clairic, Clef e GLM-5.3 in tre operazioni successive. Clairic acquisisce le informazioni dal messaggio del cliente, compresa una stima del costo della riparazione; Clef applica le regole aziendali per scegliere tra rimborso e riparazione; GLM-5.3 formula infine la risposta da inviare al cliente.
La policy utilizzata prevede il rimborso entro 30 giorni dalla consegna e privilegia la riparazione quando il relativo costo è inferiore al 60% del prezzo pagato e il danno non impedisce il funzionamento del prodotto.
Clef riceve queste regole insieme ai valori elaborati da Clairic, compresi importo pagato, giorni trascorsi dalla consegna, danni dichiarati e mediana del costo stimato della riparazione, accompagnata dall’intervallo probabilistico. La decisione viene successivamente trasmessa all’LLM insieme alle informazioni necessarie per formulare la comunicazione al cliente.
Il modello linguistico non riceve il messaggio originale. Questa separazione limita l’esposizione dell’LLM a contenuti potenzialmente malevoli presenti negli input, contribuendo alla mitigazione degli attacchi di prompt injection, e riduce il numero di valori che deve interpretare durante la generazione della risposta.
Cloudflare ha misurato le prestazioni della configurazione specializzata e di una pipeline nella quale tutte le operazioni vengono affidate a GLM-5.3.
| Indicatore | Clairic + Clef + GLM-5.3 | Solo GLM-5.3 |
|---|---|---|
| Tempo totale | 19,3 s | 61,7 s |
| Estrazione dati | 0,46 s | 16,1 s |
| Decisione | 0,22 s | 21,9 s |
| Generazione risposta | 18,6 s | 16,4 s |
| Token di input | 701 | 390 |
| Token di output | 1.329 | 2.544 |
| Costo per milione di richieste | 6.032 $ | 11.740 $ |
La pipeline specializzata ha completato l’elaborazione in circa un terzo del tempo richiesto dalla soluzione interamente generativa, con una riduzione della latenza del 69% e dei costi del 49%. Estrazione e decisione hanno richiesto complessivamente meno di un secondo ai due modelli System One, contro circa 38 secondi con GLM-5.3.
La configurazione specializzata ha utilizzato più token di input complessivi, ma quasi la metà di quelli di output. La differenza economica deriva soprattutto dalla riduzione della generazione autoregressiva, che rappresenta la parte più onerosa delle chiamate ai modelli linguistici.
In tutte le esecuzioni del test, entrambe le configurazioni hanno estratto correttamente i dati e preso la decisione prevista. Clairic ha inoltre fornito una stima del costo della riparazione costante, mentre GLM-5.3 ha prodotto valori differenti nelle successive esecuzioni, pari a 250, 250 e 220 dollari, con intervalli probabilistici anch’essi variabili.
Le prove effettuate da Cloudflare con Gemma 4 e Qwen nella configurazione interamente generativa hanno evidenziato ulteriori difficoltà nel ricavare valori come il costo stimato della riparazione, confermando la rilevanza della specializzazione dei modelli nelle operazioni di estrazione e regressione numerica.
Disponibilità, prezzi e limiti dell’anteprima
Clairic è accessibile in anteprima attraverso Cloudflare Workers AI, con l’identificativo @cf/cloudflare/clairic. Gli sviluppatori possono richiamarlo da un Worker mediante env.AI.run() oppure attraverso le API REST e AI Gateway, definendo input e campi da estrarre secondo le specifiche dell’API di Clairic.
Il prezzo è fissato a 0,10 dollari per milione di token di input, senza addebiti per i token di output, che il modello non genera. La tariffazione comprende anche i token utilizzati per descrivere lo schema dei campi richiesti.
La versione disponibile è un checkpoint preliminare, con buone capacità di estrazione delle informazioni e di esecuzione di calcoli aritmetici a uno o due passaggi, comprese somme, differenze, conversioni e operazioni sulle date. Le sequenze di calcoli dipendenti e le aggregazioni su tabelle estese risultano più difficili da gestire con un’architettura priva di un’area di lavoro intermedia per sviluppare i passaggi matematici. In questi casi, Clairic può acquisire i valori necessari e lasciare l’elaborazione numerica al software tradizionale.
Le stime probabilistiche dipendono dalla presenza di elementi sufficienti negli input, come dati storici, proprietà comparabili o descrizioni dettagliate. Cloudflare sta inoltre migliorando la calibrazione degli intervalli probabilistici, che su dati differenti da quelli utilizzati nella valutazione possono risultare più stretti di quanto giustificato dall’incertezza effettiva.
Le capacità previsionali sono attualmente orientate soprattutto al riconoscimento di tendenze generali e variazioni ricorrenti, mentre gli impieghi che richiedono previsioni dettagliate su orizzonti temporali estesi possono beneficiare di modelli statistici o di machine learning addestrati specificamente.
È previsto anche il rilascio pubblico dei pesi del modello, che ne consentirà l’esecuzione al di fuori dell’infrastruttura gestita di Workers AI. Cloudflare non ha ancora indicato una data per la pubblicazione.