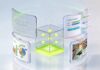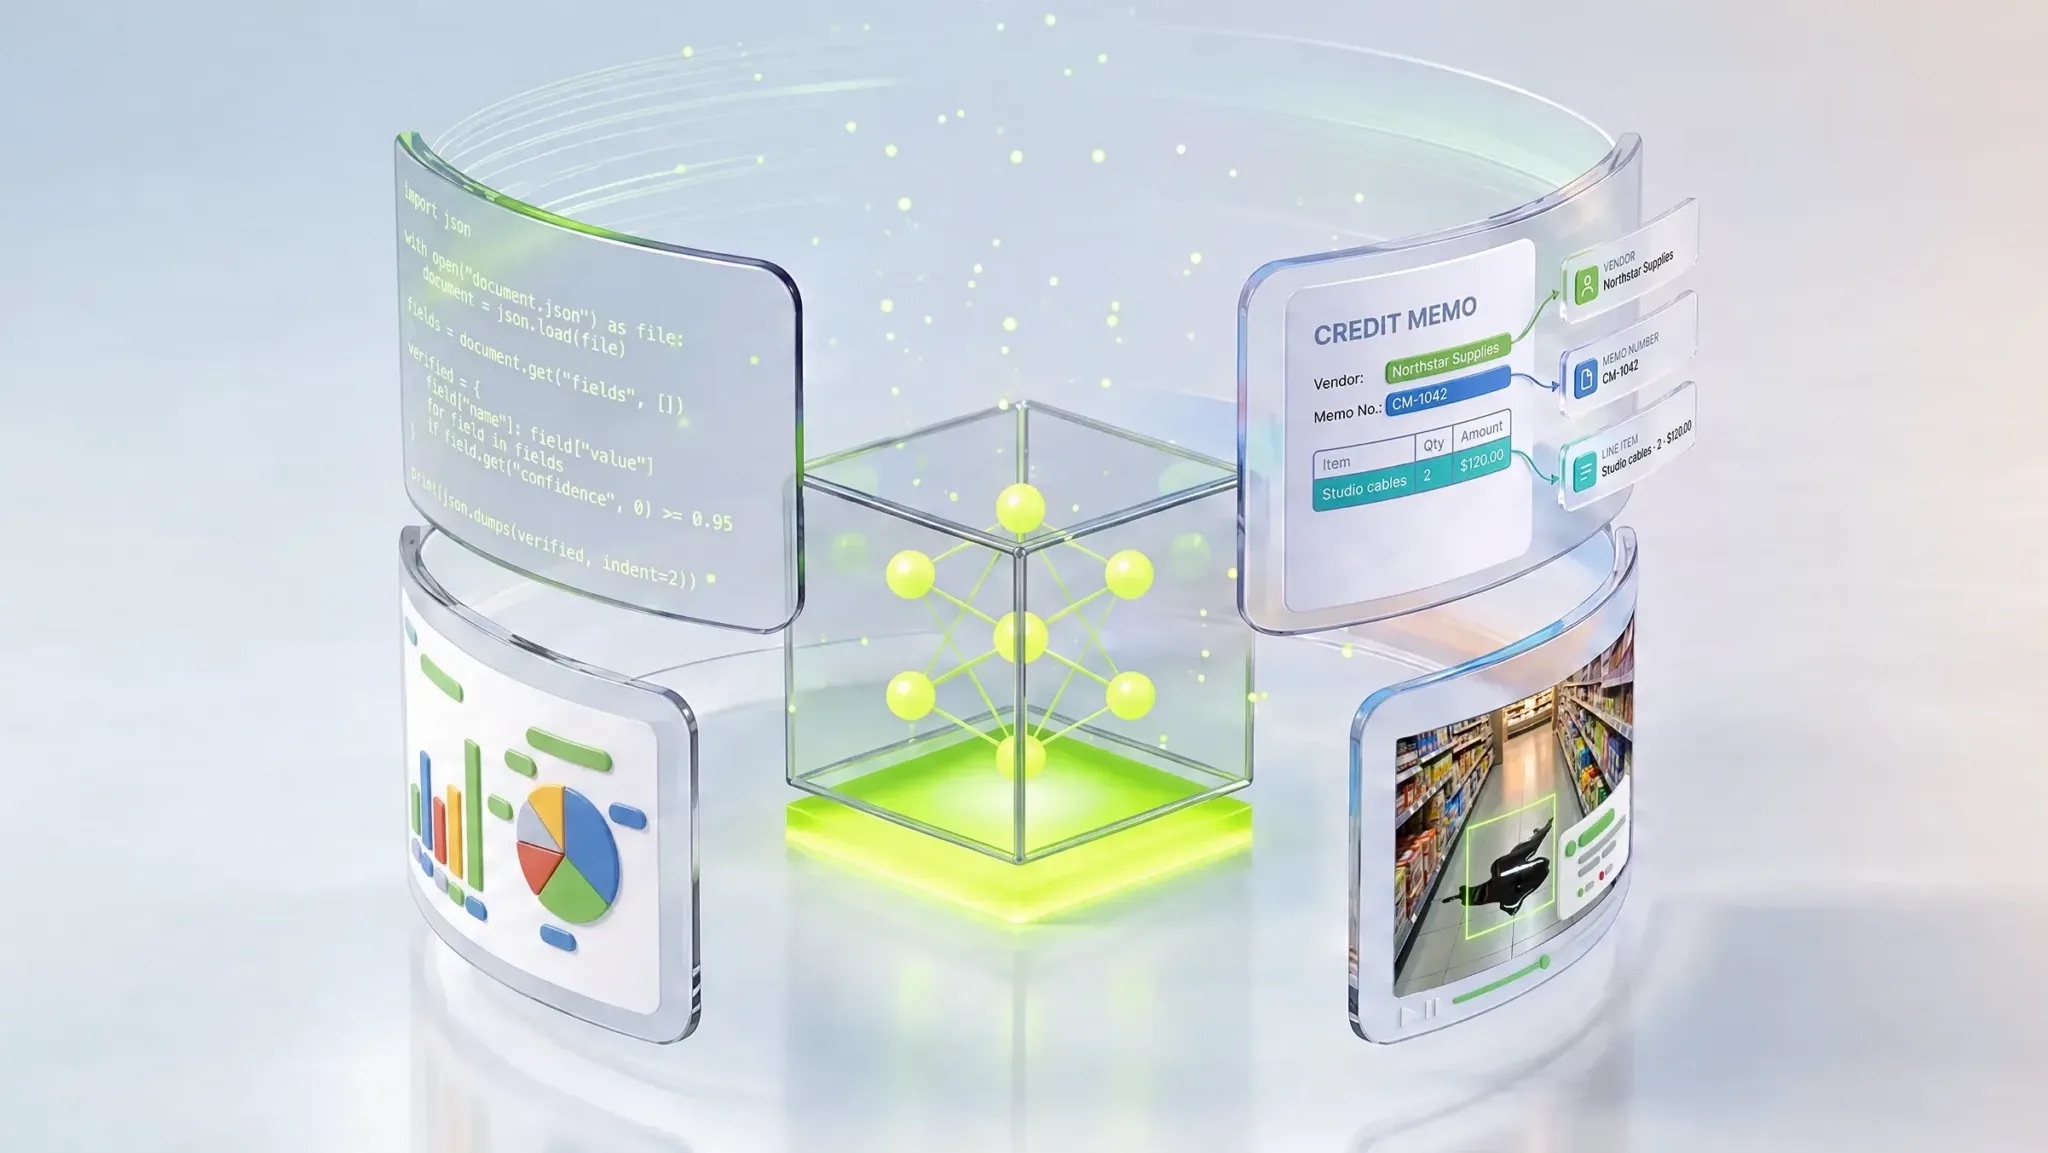
I modelli AI open-weight, specializzati attraverso il post-training, possono superare i sistemi proprietari più avanzati in applicazioni aziendali specifiche. NVIDIA presenta Nemotron 3.5 Super VL, un modello multimodale da 120 miliardi di parametri che, nelle versioni personalizzate dai primi partner, ha ottenuto risultati superiori a Claude Opus 5 e GPT-6.1 Sol in alcune valutazioni dedicate alla cybersecurity, all’analisi documentale e ad altri processi specialistici.
Il nuovo modello combina ragionamento multimodale, utilizzo di strumenti software e un’architettura Mixture-of-Experts progettata per contenere i costi di inferenza. La possibilità di adattarlo ai dati e alle procedure aziendali attraverso tecniche di addestramento aggiuntivo si accompagna alla distribuzione dei pesi, dei dataset e degli strumenti necessari alla personalizzazione.
La famiglia NVIDIA Nemotron si amplia inoltre con due modelli Bolt destinati all’esecuzione locale, su workstation e dispositivi edge, mentre Super VL è progettato per agenti capaci di svolgere attività articolate, anche distribuite su più giorni o settimane.
Un modello multimodale da 120 miliardi di parametri, con 12 miliardi attivi
Nemotron 3.5 Super VL utilizza un’architettura Mixture-of-Experts (MoE) con 120 miliardi di parametri complessivi, dei quali circa 12 miliardi vengono attivati per ogni token elaborato. La selezione dinamica degli esperti limita il fabbisogno computazionale rispetto a un’architettura densa di dimensioni equivalenti, mantenendo una capacità complessiva elevata.
Il modello può analizzare documenti PDF, tabelle, grafici, immagini, pagine web e video, collegando le informazioni estratte a operazioni di ragionamento e all’esecuzione di strumenti software. Un agente incaricato di esaminare un contratto finanziario può, per esempio, estrarre dati dalle tabelle, interpretarli insieme ai grafici, verificare informazioni esterne e applicare le regole aziendali prima di produrre un risultato strutturato.
L’architettura combina Mamba-2, che elabora sequenze di informazioni mantenendo contenuto il consumo di memoria anche nei contesti lunghi, con i meccanismi di attenzione Transformer, utilizzati per individuare le relazioni tra elementi differenti della sequenza. La componente visiva è affidata a RADIO, un encoder sviluppato da NVIDIA che converte immagini e altri contenuti visivi in rappresentazioni numeriche utilizzabili dal modello per riconoscere oggetti, interpretare grafici e analizzare documenti.
Nemotron 3.5 Super VL deriva da un processo di distillazione del più grande Nemotron 3 Ultra, attraverso il quale le capacità apprese dal modello di dimensioni maggiori vengono trasferite a uno più compatto. Durante questa fase NVIDIA ha utilizzato anche SkewReverse, un criterio matematico che guida l’addestramento misurando gli scostamenti tra le risposte del modello più piccolo e quelle del modello insegnante, contribuendo a migliorarne le capacità di generazione del codice.
Il successivo addestramento ha coinvolto più modelli insegnanti specializzati, attraverso una tecnica denominata multi-teacher on-policy distillation (MOPD). Le risposte prodotte dal modello vengono valutate da sistemi esperti in differenti attività, tra cui ragionamento sui video, tracciamento degli oggetti, utilizzo di strumenti visivi e allineamento del comportamento.
Il post-training migliora l’accuratezza nei processi aziendali
Attraverso il post-training, le organizzazioni possono adattare Nemotron 3.5 Super VL ai propri documenti, alle interfacce software e alle regole operative, utilizzando tecniche di supervised fine-tuning, LoRA e reinforcement learning.
Nei cinque ambiti applicativi illustrati da NVIDIA — analisi documentale, resilienza agli attacchi informatici, estrazione di informazioni dalle ricevute, sperimentazione scientifica e gestione delle richieste di rimborso sanitario — il miglioramento dell’accuratezza rispetto al modello originale raggiunge, nelle prove più favorevoli, oltre 40 punti percentuali.
Nel caso delle pratiche sanitarie, l’accuratezza cresce da circa il 28% al 72% dopo il post-training, mentre Claude Opus 5 raggiunge circa il 38% nella stessa valutazione. Nelle prove di resilienza agli attacchi informatici, il modello specializzato passa da circa il 35% al 76%, superando il risultato di circa il 66% attribuito a GPT-6.1 Sol.
La specializzazione consente anche di incorporare nel comportamento del modello procedure e criteri aziendali, riducendo la necessità di ripetere istruzioni complesse durante ogni esecuzione. Nei sistemi agentici che svolgono grandi volumi di attività, questa caratteristica può incidere sul consumo di token e sui tempi complessivi di elaborazione.
Finanza, cybersecurity, sanità e sviluppo software tra le prime applicazioni
Scale AI ha personalizzato Nemotron 3.5 Super VL per un agente di Skydance dedicato alla gestione dei crediti verso i fornitori. NVIDIA prevede per questa applicazione una riduzione di 40 volte del costo di inferenza e di cinque volte della latenza. Scale AI ha inoltre lavorato alla personalizzazione del modello per le attività di due diligence nelle operazioni di fusione e acquisizione di EY.
AfterQuery ha adattato Super VL per l’analisi degli accordi di credito attraverso la piattaforma Hebbia, mentre Ramp lo utilizza per convertire immagini di ricevute in documenti JSON strutturati, contenenti informazioni sul fornitore, sulle date e sui pagamenti. Ramp prevede un aumento del throughput fino al 50% e una riduzione della latenza di dieci volte.
Nella cybersecurity, AI21 ha effettuato il post-training del modello per Alice, specializzata nella sicurezza dei sistemi AI, migliorando del 40% l’accuratezza nelle attività di threat intelligence e analisi delle vulnerabilità. Dream sta lavorando all’impiego di Nemotron nella ricerca sulle vulnerabilità e nelle applicazioni di cybersecurity basate su AI sovrana.
Lila Sciences utilizza il modello per la ricerca scientifica e la scoperta di nuove conoscenze, mentre R1 lo sta adattando all’analisi delle richieste di rimborso sanitario e alla gestione dei ricavi delle organizzazioni sanitarie.
Nel campo dello sviluppo software, Mercor ha effettuato il post-training sul benchmark APEX-SWE, dedicato ad agenti capaci di pianificare, scrivere e correggere codice. ModelScope supporta invece la personalizzazione del modello attraverso il framework open source ms-swift.
Un’applicazione particolarmente delicata riguarda il settore sanitario: TrainLoop ha addestrato Nemotron con dati dermatologici di Nolla, società che NVIDIA indica come la prima autorizzata a utilizzare l’AI per redigere prescrizioni iniziali ai pazienti.
Tra le piattaforme software che stanno adottando Super VL figurano Atlassian, per la ricerca agentica attraverso applicazioni come Jira e Confluence; CrowdStrike, per le attività di difesa informatica; e Dassault Systèmes, per la progettazione e la simulazione ingegneristica.
Perplexity prevede l’utilizzo del modello nelle funzioni di ricerca e nelle attività agentiche di Perplexity Search e Computer. Salesforce lo sta personalizzando per Missionforce Operations, destinato alla digitalizzazione e all’automazione di processi amministrativi complessi in ambienti sicuri, mentre Synopsys ne supporta l’interoperabilità con gli strumenti di verifica della progettazione dei semiconduttori.
L’addestramento comprende 26.000 miliardi di token
La preparazione di Nemotron 3.5 Super VL ha richiesto circa 26.000 miliardi di token tra pretraining e continued pretraining, seguiti da un post-training basato su circa 3,8 milioni di esempi e sull’apprendimento per rinforzo in decine di ambienti differenti.
La Nemotron Coalition, che riunisce organizzazioni impegnate nello sviluppo di modelli aperti, ha contribuito alla preparazione dei dati e degli ambienti di addestramento. Perplexity ha fornito dataset di qualità per la fase intermedia, mentre Prime Intellect ha contribuito alla realizzazione degli ambienti utilizzati per addestrare i modelli insegnanti.
NVIDIA ha lavorato anche sul ragionamento visivo attraverso una procedura di supervised fine-tuning in due fasi, che associa immagini e documenti a esempi di ragionamento, istruzioni conversazionali, utilizzo degli strumenti e sequenze di azioni degli agenti.
L’addestramento comprende il riconoscimento ottico dei caratteri (OCR), l’interpretazione di grafici e tabelle, l’analisi di documenti multipagina e la comprensione dei video. I dati sintetici generati con NeMo Data Designer hanno contribuito a migliorare l’interpretazione dei grafici complessi.
Nel benchmark CharXiv, dedicato alla comprensione dei grafici scientifici, Nemotron 3.5 Super VL raggiunge un’accuratezza dell’80,8%, rispetto al 63% di Nemotron 3 Nano Omni. Quando il modello utilizza Python per elaborare i dati estratti dai grafici, il risultato sale all’84%. NVIDIA segnala inoltre il posizionamento del modello tra i migliori sistemi open nella classifica OCRBench v2.
L’addestramento ha interessato anche le capacità di programmazione, attraverso esempi di azioni agentiche, repository di codice e attività di ingegneria del software. Super VL supera Nemotron 3 Super in diverse configurazioni dei benchmark SWE-bench e Terminal-Bench.
Un’ulteriore componente riguarda il supporto multilingue. NVIDIA ha utilizzato 10 miliardi di token in lingue indiane durante il continued pretraining, selezionati da un insieme di dodici lingue. Ha inoltre pubblicato un dataset sviluppato con IIT Madras e il laboratorio AI4Bharat, contenente circa 2.800 miliardi di token in 22 lingue indiane. Nei cinque benchmark linguistici presentati, il modello specializzato ottiene risultati superiori a Gemma 4 31B e Sarvam 105B.
I benchmark misurano accuratezza e velocità di completamento
Nelle valutazioni dedicate agli agenti, Nemotron 3.5 Super VL ottiene risultati superiori a Nemotron 3 Ultra in Hermes Bench e LangChain Evals, pur avendo circa un quinto dei parametri complessivi del modello più grande.
| Benchmark | Nemotron 3 Ultra | Nemotron 3.5 Super VL |
| Hermes Bench | 56,33% | 63,44% |
| LangChain Evals | 84,30% | 87,05% |
Le due prove valutano aspetti del comportamento agentico, tra cui l’esecuzione delle istruzioni e la capacità di operare attraverso strumenti e procedure software. NVIDIA ha condotto ulteriori valutazioni utilizzando ambienti come OpenClaw, OpenCode, Pi, Codex e Claude, che permettono di misurare le prestazioni del modello all’interno di sistemi agentici differenti.
La velocità di generazione supera 600 token al secondo nelle misurazioni di Artificial Analysis effettuate sull’endpoint Baseten con un contesto di 100.000 token. Il throughput risulta fino a cinque volte superiore a quello di modelli open-weight con punteggi comparabili nell’Artificial Analysis Intelligence Index.
Per le applicazioni agentiche conta anche il tempo necessario a completare un’attività, che dipende dal numero di token generati, dalle chiamate agli strumenti e dai passaggi richiesti per raggiungere il risultato.
In una valutazione su 10.000 attività di programmazione eseguite su GPU NVIDIA B200, Super VL raggiunge tempi di completamento fino a quattro volte inferiori rispetto agli altri modelli open della stessa categoria considerati nel confronto.
Una valutazione indipendente condotta da EXO Labs su DGX Spark, con 128 GB di memoria, colloca inoltre Nemotron 3.5 Super VL sulla frontiera di Pareto nel rapporto tra accuratezza e tempo di completamento: tra i modelli esaminati, rappresenta una delle combinazioni più efficienti delle due grandezze, senza che sia possibile migliorarne una mantenendo invariata l’altra.
LiLiCorr, NVFP4 e multi-token prediction riducono il lavoro di inferenza
LiLiCorr è una tecnica aperta di speculative decoding che permette di generare anticipatamente gruppi di token candidati, verificandone congiuntamente la compatibilità prima della conferma da parte del modello principale. Una rete leggera valuta le dipendenze tra i token proposti, limitando i passaggi sequenziali necessari alla selezione finale.
Su DGX Spark, LiLiCorr consente una generazione fino a 2,3 volte più veloce rispetto alla decodifica priva di questa ottimizzazione.
La quantizzazione NVFP4 riduce a 4 bit la rappresentazione dei pesi e delle attivazioni sulle GPU NVIDIA Blackwell. Lo stesso checkpoint può funzionare su piattaforme precedenti utilizzando pesi a 4 bit e attivazioni a 16 bit, mentre le componenti più sensibili conservano una precisione numerica maggiore.
Per contenere la perdita di accuratezza, NVIDIA utilizza la quantization-aware distillation (QAD), attraverso la quale il modello quantizzato viene addestrato a riprodurre le risposte della versione originale BF16. La tecnica consente anche di conservare la cache delle chiavi e dei valori dell’attenzione, denominata KV cache, nel formato NVFP4 anziché FP8. Poiché l’adattamento avviene durante l’addestramento, QAD non introduce calcoli aggiuntivi nell’inferenza.
La multi-token prediction (MTP) utilizza invece un componente interno che propone più token contemporaneamente, permettendo al modello principale di verificarli in un singolo passaggio. NVIDIA ha dedicato una fase specifica dell’addestramento all’allineamento tra questo componente e il modello finale.
Gli agenti che operano per molte interazioni consecutive possono inoltre riutilizzare parte dei calcoli già effettuati sulle istruzioni di sistema, sulle definizioni degli strumenti e sulla cronologia della conversazione.
Il prefix caching conserva le rappresentazioni degli input condivisi tra richieste successive, mentre le ottimizzazioni specifiche dell’architettura ibrida preservano sia le cache dell’attenzione Transformer sia gli stati ricorrenti di Mamba. Ulteriori checkpoint permettono di ricostruire gli stati necessari alla decodifica speculativa senza rielaborare interamente le sequenze precedenti.
NeMo, NIM e Dynamo per personalizzazione e distribuzione
NVIDIA distribuisce Nemotron 3.5 Super VL con pesi aperti, checkpoint nelle versioni base, post-trained e quantizzata NVFP4, oltre a dataset, procedure di addestramento e ambienti per l’apprendimento per rinforzo.
Il modello può essere personalizzato attraverso NVIDIA NeMo, utilizzando NeMo AutoModel per il supervised fine-tuning e LoRA, una tecnica che modifica un numero limitato di parametri aggiuntivi per adattare il comportamento del modello con un impiego di risorse inferiore rispetto al riaddestramento completo.
NeMo RL supporta l’apprendimento per rinforzo, mentre NeMo Gym permette di costruire ambienti nei quali gli agenti vengono addestrati e valutati attraverso attività rappresentative dei processi aziendali. NeMo Data Designer fornisce strumenti per preparare dati multimodali, compresi esempi di interpretazione dei grafici e comprensione di documenti estesi.
NVIDIA ha pubblicato su Hugging Face dataset dedicati all’utilizzo degli strumenti, al ragionamento finanziario, alle istruzioni conversazionali, alla gestione di contesti lunghi, alla traduzione, all’equità dei modelli e alla comprensione visiva.
Per l’esecuzione in produzione, NVIDIA NIM distribuisce il modello sotto forma di microservizio, con motori di inferenza ottimizzati, configurazioni validate e API standardizzate. Il servizio prevede aggiornamenti periodici di sicurezza e prestazioni, con supporto aziendale attraverso NVIDIA AI Enterprise.
NVIDIA Dynamo gestisce invece l’inferenza distribuita, attraverso tecniche di instradamento delle richieste basate sulla disponibilità della KV cache, gestione della memoria e disaggregated serving, che separa le risorse dedicate all’elaborazione iniziale del prompt da quelle utilizzate per generare la risposta.
In una configurazione di 16 GPU NVIDIA B200, mantenendo una velocità di 50 token al secondo per utente, l’instradamento che tiene conto delle sessioni e il trasferimento della KV cache verso memoria esterna consentono di servire fino a otto volte più utenti, riducendo dell’85% il tempo necessario alla generazione del primo token.
Nemotron 3.5 Super VL è disponibile su Hugging Face, ModelScope e OpenRouter, oltre che come microservizio NVIDIA NIM. Il modello può essere eseguito su infrastrutture cloud e data center, oltre che su sistemi locali NVIDIA DGX Spark, DGX Station, RTX PRO e workstation RTX. NVIDIA indica il supporto anche per la famiglia Jetson, destinata alle applicazioni edge.
La distribuzione locale permette alle organizzazioni di conservare dati e modelli all’interno delle proprie infrastrutture, applicando direttamente le politiche aziendali di sicurezza e residenza delle informazioni.
Nemotron 3.5 Bolt, due modelli per gli agenti AI locali
L’ampliamento della famiglia Nemotron comprende Nemotron 3.5 Bolt 74B-A9B 24GB e Nemotron 3.5 Bolt E4B 4GB, progettati per sistemi con disponibilità di memoria e capacità computazionale inferiori rispetto alle infrastrutture utilizzate dai modelli più grandi.
Bolt 74B-A9B dispone di 74 miliardi di parametri complessivi, dei quali 9 miliardi attivi durante l’inferenza. La quantizzazione nativa a 2 bit consente di eseguirlo utilizzando 24 GB di memoria, lasciando risorse disponibili per altre applicazioni.
Il modello è destinato ad agenti locali capaci di effettuare ricerche sul web, scrivere documenti, sviluppare software e correggere codice. NVIDIA lo colloca al primo posto tra i modelli open della sua categoria su PinchBench e al secondo posto su BrowseComp, due valutazioni dedicate alle capacità operative degli agenti.
Bolt 74B-A9B è disponibile su Hugging Face e supporta strumenti come llama.cpp, Ollama, LM Studio, Unsloth e vLLM.
Il modello può essere eseguito su PC GeForce RTX, DGX Spark, DGX Station e workstation RTX PRO. NVIDIA ne prevede inoltre l’utilizzo sui nuovi laptop RTX Spark, il cui arrivo è annunciato per il 16 ottobre.
Nemotron 3.5 Bolt E4B 4GB, disponibile dal 23 ottobre, richiede invece 4 GB di memoria ed è destinato ad assistenti vocali, personaggi interattivi e interfacce embedded.
Il modello combina conversazione naturale e capacità agentiche su più turni, permettendo a un assistente di mantenere il contesto delle richieste successive e utilizzare strumenti software durante l’interazione. Le piattaforme previste comprendono GeForce RTX, Jetson e sistemi RTX/DGX Spark.
I nuovi Bolt si affiancano a Nemotron 3.5 Lightning, dedicato ai carichi agentici ad alto volume, e Nemotron 3 Ultra, utilizzato per le attività di ragionamento, pianificazione e orchestrazione più complesse.
L’ecosistema comprende framework agentici, cloud e system integrator
La distribuzione di Nemotron 3.5 Super VL coinvolge partner specializzati nell’addestramento, nell’inferenza e nell’orchestrazione degli agenti.
Tra gli strumenti di esecuzione figurano SGLang, vLLM, Ollama, LM Studio, Unsloth e le soluzioni di EXO Labs, mentre il supporto ai framework agentici comprende LangChain, Cline, OpenClaw, OpenCode, OpenHands, Hermes Agent, Kilo Code e Pi.
Sul versante cloud, NVIDIA indica la compatibilità con Amazon SageMaker JumpStart, Google Cloud Gemini Enterprise Agent Platform, Microsoft Foundry e Oracle Cloud Infrastructure.
Dell Technologies, HPE e Red Hat figurano tra i partner infrastrutturali, mentre HCLTech, Infosys e Tata Consultancy Services partecipano all’ecosistema come system integrator globali.
Tra i fornitori di servizi di inferenza figurano Baseten, CoreWeave, Crusoe, DeepInfra, DigitalOcean, Fireworks AI, Lambda, Modal, Nebius e Together AI.
La disponibilità di modelli con requisiti hardware differenti, strumenti aperti di personalizzazione e ambienti di distribuzione eterogenei permette alle aziende di scegliere dove eseguire gli agenti e quanto investire nell’adattamento ai propri processi.
I risultati dei primi progetti mostrano che il post-training può migliorare sensibilmente l’accuratezza in attività specializzate, mentre le ottimizzazioni dell’inferenza incidono sui costi operativi. La convenienza complessiva dipende dal volume delle attività, dalle risorse necessarie all’addestramento e dalla qualità dei dati utilizzati per adattare e valutare il modello.