Testo, codice, immagini, video e audio condividono lo stesso spazio di embedding in EmbeddingGemma 2, il modello aperto di Google DeepMind. Queste rappresentazioni numeriche permettono alle applicazioni di confrontare contenuti di formato diverso in base al significato, per cercare informazioni, classificarle, raggrupparle e instradare richieste, oltre a recuperare il contesto per i sistemi RAG. L’elaborazione può avvenire direttamente su smartphone e computer, anche senza connessione.
Basato sull’architettura Gemma 4, il modello conta 740 milioni di parametri nella configurazione multimodale completa ed è distribuito con licenza Apache 2.0, che consente anche l’impiego commerciale. La prima generazione, introdotta lo scorso anno per gli embedding testuali e arrivata a oltre 20 milioni di download secondo Google, è stata utilizzata per strumenti di ricerca sul dispositivo e sistemi RAG attenti alla riservatezza dei dati; la nuova versione amplia questi impieghi, consentendo per esempio di individuare una scena video attraverso una nota vocale o di cercare in ore di registrazioni audio con una richiesta scritta.
Uno spazio comune per cercare tra formati diversi
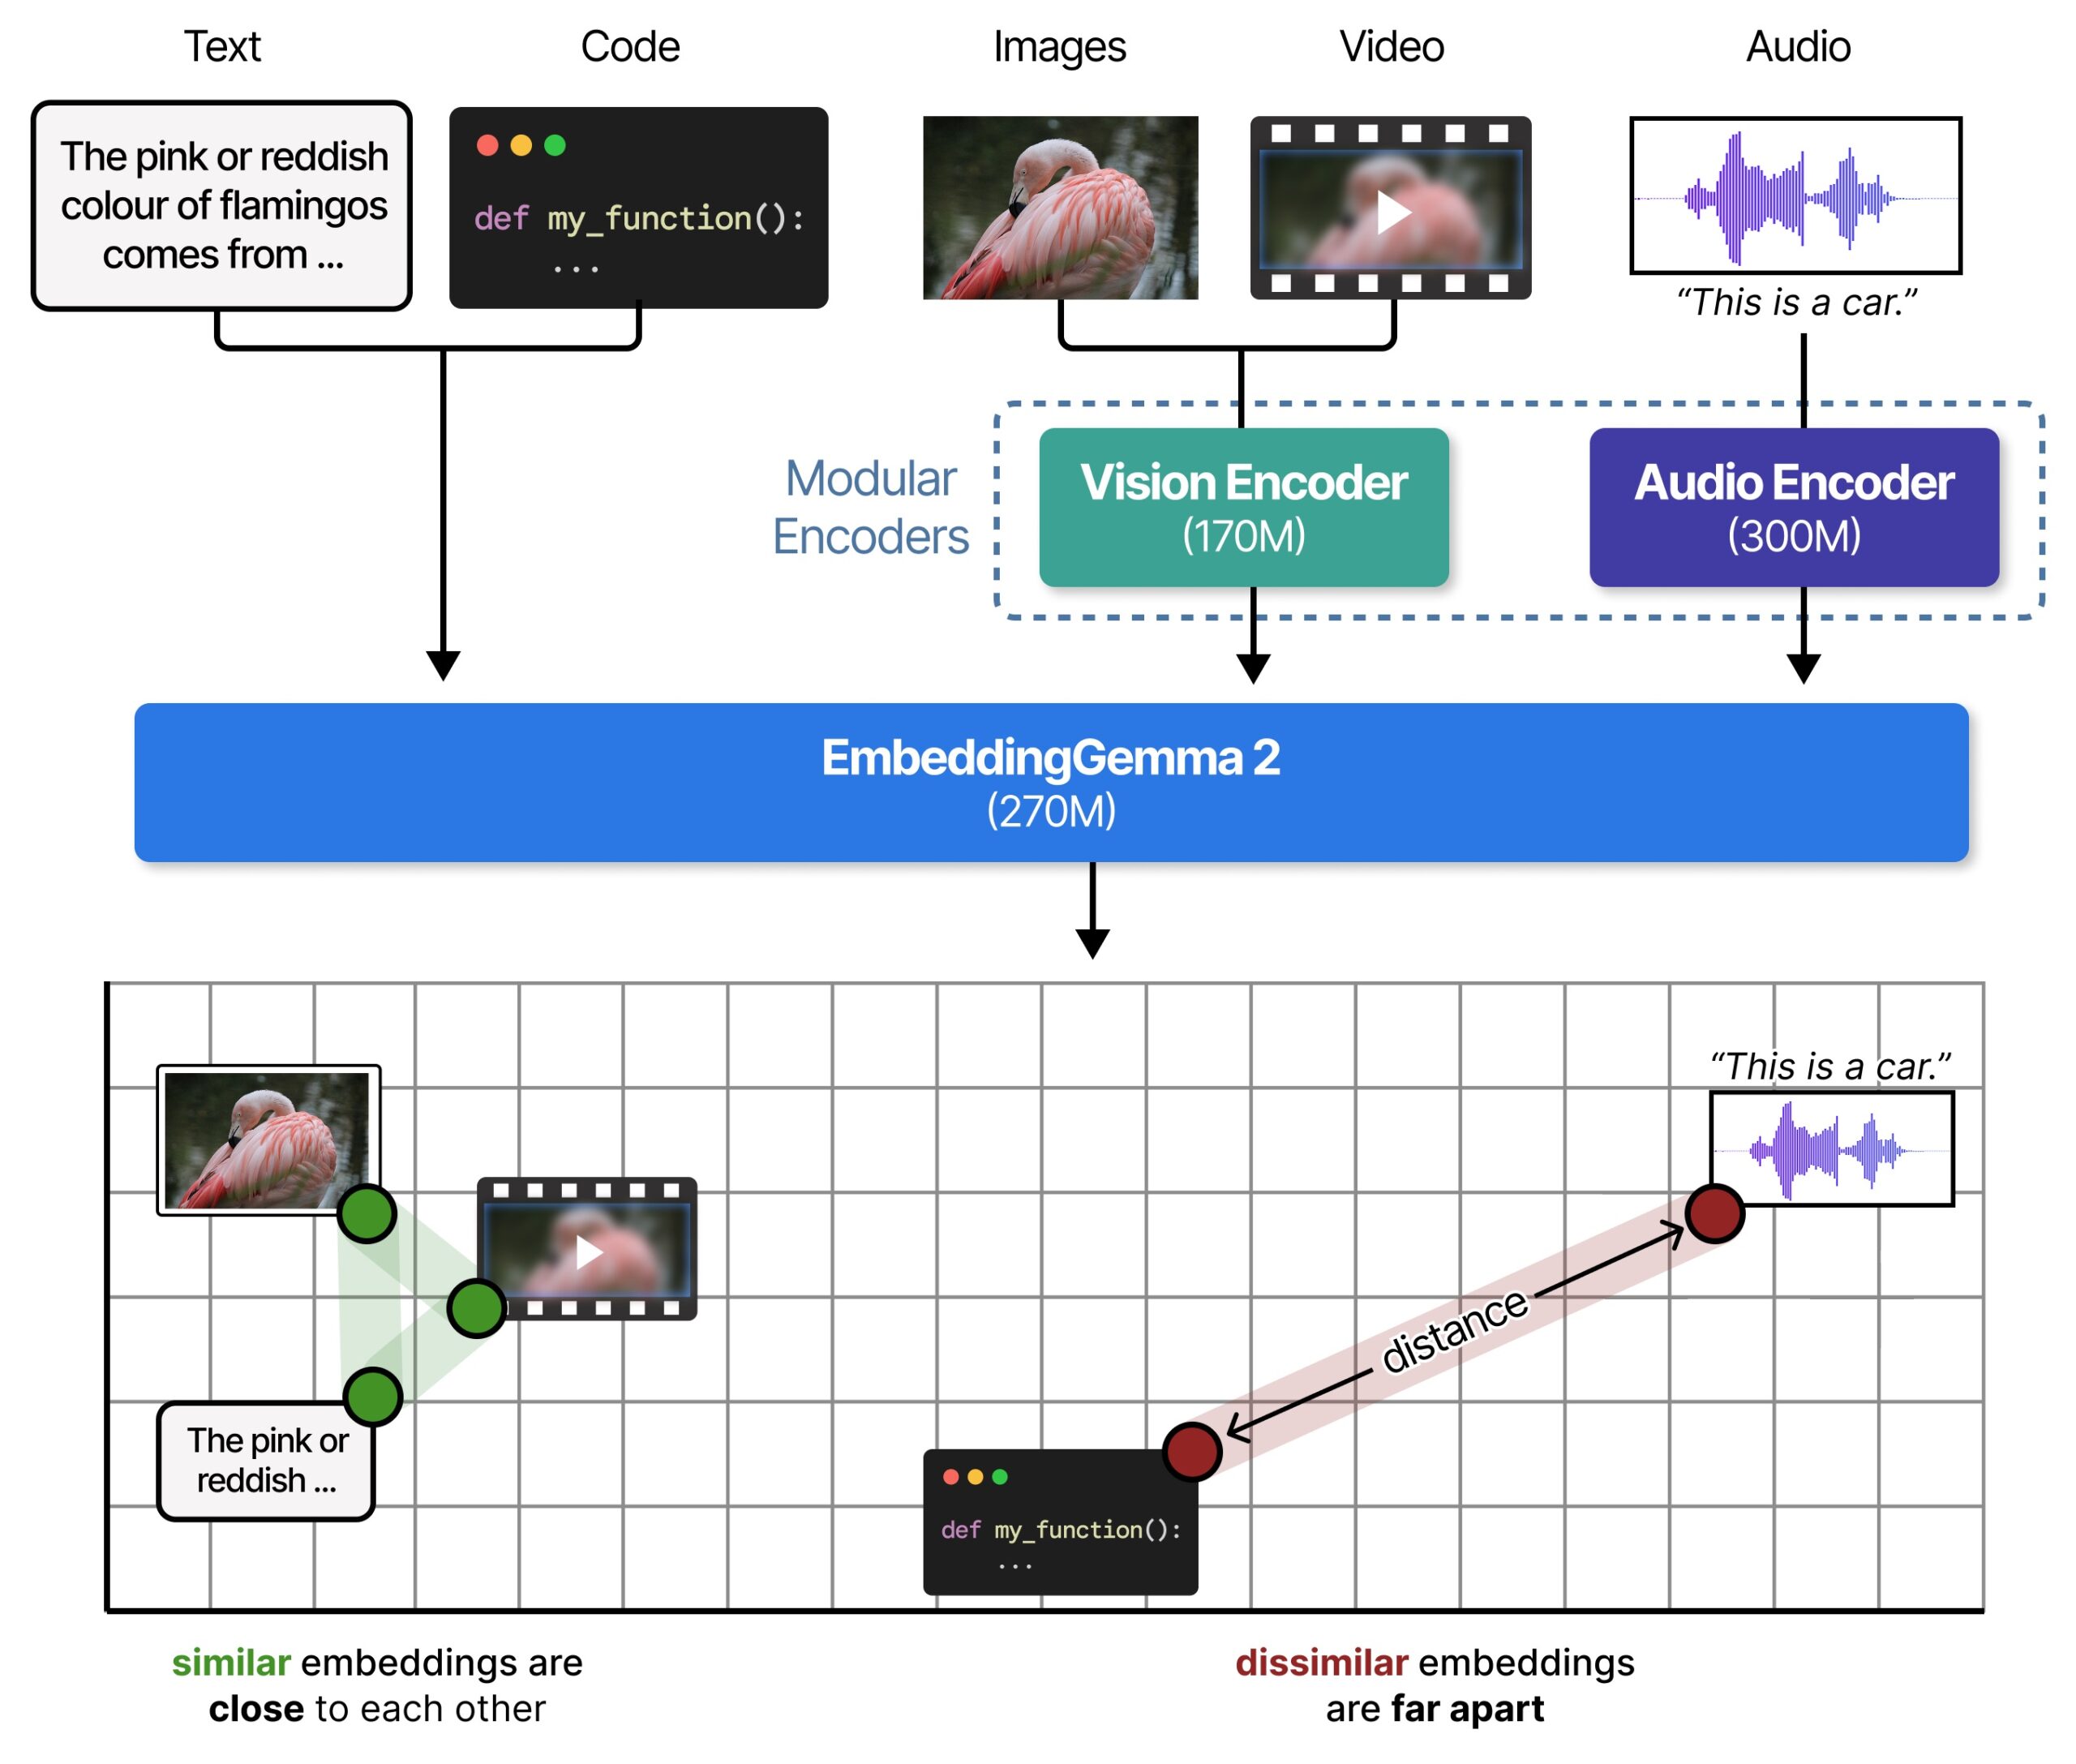
Gli embedding sono rappresentazioni numeriche dei contenuti: consentono di confrontare una richiesta con documenti o altri elementi in base alla somiglianza del significato. Con EmbeddingGemma 2, sviluppato a partire dalla stessa tecnologia dei modelli Gemini Embedding, questa rappresentazione è condivisa fra le diverse modalità. Testo, immagini, video e audio, anche combinati nello stesso input, possono quindi essere indicizzati e confrontati attraverso un unico modello.
La fotografia di un gatto, la parola “gatto” e la registrazione del suo miagolio, per esempio, vengono rappresentate da vettori vicini nello stesso spazio multidimensionale. Questa corrispondenza permette di collegare contenuti visivi, testuali e sonori attraverso il loro significato. L’architettura unificata riunisce in un solo modello le modalità che, nei sistemi di recupero tradizionali, richiedevano componenti separati per testo, immagini e audio.
Il risultato dell’elaborazione è un vettore numerico, che l’applicazione utilizza per trovare corrispondenze, assegnare categorie o organizzare un archivio. Nella classificazione può servire a distinguere il sentiment di un testo, categorizzare immagini o riconoscere eventi sonori; nel raggruppamento consente di riunire documenti simili e feedback dei clienti sullo stesso tema. Il confronto fra vettori può alimentare anche raccomandazioni, rilevamento dei duplicati e associazione di contenuti in lingue diverse. Per il fact-checking, il suo ruolo consiste nel recuperare documenti pertinenti a un’affermazione, da utilizzare nella successiva verifica.
Il supporto supera le 100 lingue. Brevi istruzioni associate agli input testuali orientano gli embedding verso il compito richiesto, come ricerca, classificazione o confronto semantico. La classificazione zero-shot permette inoltre di assegnare categorie senza un addestramento specifico con esempi etichettati per quel compito.
La generazione locale degli embedding permette di costruire ricerche e sistemi di recupero delle informazioni interamente offline, riducendo la latenza della pipeline e mantenendo l’elaborazione dei contenuti sul dispositivo. Queste rappresentazioni costituiscono anche la base per instradare richieste verso la funzione appropriata in base al contesto multimodale.
L’architettura modulare permette di caricare soltanto i componenti necessari. Per il testo bastano 270 milioni di parametri; l’encoder visivo ne aggiunge 170 milioni e quello audio altri 300 milioni. Gli sviluppatori possono così adattare l’occupazione di memoria alle modalità effettivamente utilizzate, fino alla configurazione completa da 740 milioni di parametri. Testo e immagini richiedono complessivamente 440 milioni di parametri, testo e audio 570 milioni: la componente testuale della nuova generazione è quindi più piccola di quella del predecessore, che contava 308 milioni di parametri.
Con la quantizzazione, che riduce la precisione numerica dei pesi per contenerne le dimensioni, Google indica su Pixel 11 Pro circa 191 MB di RAM attiva per i pesi della configurazione testuale e circa 567 MB per quella multimodale completa. Questi valori riguardano le configurazioni quantizzate indicate nell’annuncio e vanno distinti dai risultati dei benchmark eseguiti con il modello a piena precisione.
Vettori più compatti e contesto quattro volte più ampio
Per contenere lo spazio necessario agli archivi vettoriali, EmbeddingGemma 2 supporta il Matryoshka Representation Learning, o MRL. La tecnica consente di accorciare i vettori di output da 768 dimensioni a 512, 256 oppure 128, con una riduzione fino a sei volte dello spazio occupato dai vettori nei database locali e in memoria. Gli sviluppatori possono scegliere il compromesso fra compattezza e qualità della ricerca in funzione dell’applicazione.
Fino a 256 dimensioni l’impatto sulla qualità resta contenuto; a 128 la perdita nelle attività multimodali diventa più marcata, rendendo questa configurazione più adatta al testo. Dopo la riduzione, i vettori devono essere rinormalizzati e quelli delle richieste devono avere la stessa dimensione dei contenuti indicizzati.
La finestra di contesto raggiunge 8.192 token, quattro volte quella del primo EmbeddingGemma. Con le impostazioni predefinite può contenere circa 5,5 minuti di audio, 29 immagini oppure 58 fotogrammi video. È possibile anche alternare testo e contenuti multimediali nella stessa sequenza: tutte le modalità condividono il medesimo budget di contesto, quindi questi massimi si riferiscono agli input di una sola modalità, senza testo di accompagnamento.
I risultati su codice, immagini, documenti e audio
Sul testo multilingue, la nuova versione mantiene il livello della precedente, mentre il miglioramento più netto nel confronto diretto riguarda il codice. Nel Massive Text Embedding Benchmark dedicato al codice, il punteggio passa da 68,76 a 78,68, con un aumento di 9,92 punti. Questo rende il modello utile per indicizzare repository locali, cercare codice con richieste in linguaggio naturale e recuperare informazioni per gli agenti di programmazione.
Google colloca EmbeddingGemma 2 fra i modelli multimodali più performanti sotto il miliardo di parametri e indica risultati in grado di eguagliare o superare diversi modelli più grandi nelle attività su testo, visione e audio, compresi alcuni modelli specializzati con oltre il doppio dei parametri.
Nei benchmark, EmbeddingGemma 2 è stato valutato a piena precisione, con vettori a 768 dimensioni. Ogni prova misura capacità diverse e utilizza una propria scala di valutazione.
| Ambito | Benchmark | Metrica aggregata | EmbeddingGemma 2 | EmbeddingGemma 1 |
|---|---|---|---|---|
| Testo multilingue | MTEB multilingual, v2 | Media per attività, metriche multiple | 61,36 | 61,15 |
| Codice | MTEB code, v1 | Media per attività, NDCG@10 | 78,68 | 68,76 |
| Immagini | MIEB lite | Media per tipo di attività, metriche multiple | 64,64 | – |
| Immagini | MMEB v2, Image | Media per attività, Hit@1 | 57,28 | – |
| Documenti visivi | MMEB v2, VisDoc | Media per attività, NDCG@5 | 67,84 | – |
| Video | MMEB v2, Video | Media per attività, Hit@1 | 50,67 | – |
| Audio | MSEB, Retrieval | Media per attività, MRR@10 | 69,54 | – |
| Audio | MAEB | Media per attività, metriche multiple | 49,39 | – |
NDCG valuta la qualità dell’ordinamento dei risultati, Hit@1 misura il successo del primo risultato e MRR considera la posizione del primo risultato pertinente. Le sigle MTEB, MIEB, MMEB e MSEB identificano rispettivamente suite di valutazione per embedding testuali, immagini, contenuti multimodali e suoni; MAEB indica il Massive Audio Embedding Benchmark.
RAG locale con Gemma 4 e applicazioni dimostrative
Insieme a un modello generativo come Gemma 4, EmbeddingGemma 2 permette di costruire pipeline RAG, cioè sistemi che recuperano contenuti pertinenti e li utilizzano come contesto per generare una risposta. EmbeddingGemma 2 identifica le informazioni da recuperare, mentre Gemma 4 le utilizza per elaborare la risposta. La condivisione del tokenizer testuale, il componente che suddivide il testo in token, e dell’encoder audio con Gemma 4 consente di eseguire i due modelli in una pipeline unificata con una minore occupazione complessiva di memoria. L’abbinamento con Gemma 4 E2B è previsto anche per chatbot e sistemi RAG destinati ai dispositivi mobili.
In Google AI Edge Gallery, Instant Media Search trova gli elementi più simili in una libreria multimediale partendo da testo o da un’immagine, consentendo di recuperare foto e risorse visive con richieste in linguaggio naturale. Video Moments Finder individua invece momenti specifici nei video attraverso query testuali o audio: cercando “spegnere le candeline” in un filmato di compleanno, per esempio, si può raggiungere direttamente la scena corrispondente. La ricerca avviene sul telefono senza una trascrizione intermedia e senza chiamate ad API esterne, quindi può funzionare completamente offline.
L’app Google AI Edge Foresight abbina il recupero dei file locali di EmbeddingGemma 2 al ragionamento contestuale di Gemma 4. Nella dimostrazione, Foresight ascolta l’audio in sottofondo e ne genera gli embedding; quando rileva una domanda sul funzionamento dell’app, mostra un riepilogo generato insieme al diagramma dell’architettura di sistema recuperato dalla memoria locale. L’esempio illustra come combinare ascolto, recupero multimodale e generazione in una pipeline eseguita interamente sul dispositivo, mantenendo i dati sensibili sull’hardware dell’utente. Lo stesso abbinamento permette di costruire flussi di lavoro agentici locali.
La MediaPipe Decision Task API permette inoltre di costruire motori decisionali in tempo reale che utilizzano il contesto multimodale per classificazione, instradamento e funzioni predittive. Per le applicazioni che richiedono un’integrazione personalizzata, LiteRT offre gli strumenti per eseguire il modello sul dispositivo e realizzare sistemi di ricerca e RAG locali.
Disponibilità e strumenti per gli sviluppatori
I pesi di EmbeddingGemma 2 sono disponibili su Hugging Face e Kaggle, mentre l’arrivo nel Model Garden di Gemini Enterprise Agent Platform è annunciato come prossimo. La community LiteRT su Hugging Face distribuisce le versioni ottimizzate per l’esecuzione sui dispositivi.
Per lo sviluppo di applicazioni multipiattaforma, Google AI Edge MediaPipe mette a disposizione funzioni pronte per embedding, recupero delle informazioni e decisioni; nel browser si possono utilizzare transformers.js o WebGPU. L’ecosistema di strumenti supportati comprende transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama e LMStudio. I vettori generati possono essere archiviati con Qdrant.
Per adattare il modello a dati e attività specifici, Unsloth fornisce indicazioni sul fine-tuning. Google mette inoltre a disposizione una guida per gli sviluppatori, la documentazione di EmbeddingGemma e le guide operative per l’inferenza e il fine-tuning con Sentence Transformers, oltre ai notebook del ricettario Gemma.
Il fine-tuning consente di adattare gli embedding a vocabolari di settore e contenuti specialistici, come contratti legali complessi, immagini mediche e cataloghi tecnici di prodotti. L’obiettivo è migliorare la precisione del recupero per questi ambiti senza aumentare le dimensioni del modello.