A poche ore dalle indiscrezioni sul primo modello open-weight e sulla roadmap di Reflection AI, il progetto assume un nome e un profilo tecnico preciso: Beam, un modello destinato alla programmazione, al ragionamento e ai carichi di lavoro degli agenti AI. L’annuncio del 5 ottobre introduce un’architettura Mixture-of-Experts da 501 miliardi di parametri totali, dei quali 23 miliardi attivi, e fissa a questo mese la pubblicazione dei pesi con licenza Apache 2.0.
Per ora l’accesso riguarda una versione preliminare destinata a un gruppo selezionato di utenti, mentre sono in corso le valutazioni finali e il red-teaming, cioè le prove avversariali per individuare vulnerabilità e comportamenti problematici. Con la presentazione di Beam, Reflection rende concreti diversi punti rimasti aperti nelle anticipazioni: dimensione e impostazione del modello, risultati nei benchmark, infrastruttura di addestramento, licenza e calendario di distribuzione.
Il posizionamento privilegia la combinazione fra capacità ed efficienza di esecuzione. L’azienda colloca Beam nella competizione con modelli aperti come GLM 5.2 e Qwen 3.8-Max, riconoscendo che sistemi come Kimi K3 conservano un vantaggio nelle capacità assolute e indicando nel minor calcolo richiesto durante l’inferenza il punto distintivo della propria proposta.
Un modello MoE per coding, reasoning e uso degli strumenti
L’architettura sparse Mixture-of-Experts, o MoE, seleziona per ogni token una parte degli esperti che compongono la rete: i 501 miliardi di parametri descrivono la dimensione complessiva, mentre i 23 miliardi attivati determinano una parte rilevante del lavoro necessario a generare ciascun token. Questa impostazione consente di combinare una grande capacità complessiva con un volume di calcolo per token inferiore a quello di una rete che attivi tutti i propri parametri.
Beam è stato sviluppato con particolare attenzione al coding e ai compiti agentici, nei quali il modello deve concatenare decisioni, utilizzare strumenti e reagire ai risultati ottenuti. Reflection lo descrive come un avanzamento della frontiera open-weight occidentale, competitivo con GLM 5.2 e vicino a Qwen 3.8-Max nei carichi di programmazione e negli agenti. I risultati dei benchmark pubblicati da Reflection sono raccolti nella tabella seguente.
| Benchmark | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 44,4 | NR | NR | 44,0 | 61,0 | 68,0 | 51,0 | 74,2 |
| SWE Bench Pro v2-Hard | 77,2 | 56,9 | NR | NR | 84,3 | 88,2 | NR | NR |
| SWE Bench Pro v1 | 65,5 | 54,3 | 46,4 | 62,1 | NR | NR | 67,7 | NR |
| Terminal Bench v2.1 | 80,1 | 63,8 | 56,4 | 81,0 | 88,2 | 88,3 | 86,6 | 90,6 |
| SWE Atlas Codebase QnA | 34,6 | NR | NR | NR | 61,0 | 68,0 | NR | NR |
| SWE-Bench Multilingual | 78,0 | NR | 67,7 | NR | NR | NR | NR | NR |
| SWE-Bench Verified | 80,9 | 77,6 | 70,7 | NR | NR | NR | NR | NR |
| AIME 2026 | 97,8 | 97,1 | NR | 99,2 | NR | NR | NR | NR |
| HLE senza strumenti | 36,2 | 29,7 | 26,7 | 40,5 | 42,3 | 46,9 | 43,6 | 39,1 |
| SciCode | 49,7 | 46,1 | 44,6 | NR | 59,0 | 58,7 | 52,1 | 52,0 |
| CriPT AA | 16,3 | 5,4 | 3,1 | 20,9 | 19,1 | 23,4 | 20,0 | 14,3 |
| GPQA Diamond | 90,5 | 87,2 | 87,0 | 91,2 | 91,7 | 93,5 | 92,6 | 90,9 |
| AutomationBench public | 37,0 | NR | NR | 26,2 | 48,2 | 46,7 | 39,8 | 54,8 |
| MCP Atlas | 78,7 | 76,0 | 63,1 | 77,8 | 84,2 | 82,3 | 84,5 | NR |
| tau3 banking | 38,0 | 25,0 | 22,6 | 37,1 | NR | 37,1 | 55,2 | NR |
| BrowseComp con gestione del contesto | 77,4 | 77,1 | 44,4 | NR | NR | 91,2 | NR | NR |
| DeepSearchQA con gestione del contesto | 80,1 | NR | NR | NR | NR | 95,0 | NR | NR |
| AA-LCR | 79,3 | 77,3 | 79,3 | 78,3 | 79,7 | 88,7 | 80,3 | 84,0 |
| LongBench v2 | 65,5 | NR | 61,9 | 64,0 | NR | NR | 66,3 | NR |
| IFBench | 79,7 | 79,8 | 81,7 | 73,3 | NR | NR | 82,8 | NR |
| AA Omniscience, indice sul solo sottoinsieme pubblico | 13,0 | 14,2 | 8,6 | NR | 22,6 | NR | NR | 6,6 |
Risultati pubblicati da Reflection. La colonna grigia identifica Beam; il grassetto evidenzia i confronti più significativi per il suo posizionamento nel coding, negli agenti e nel reasoning. NR: risultato non riportato. Per AA Omniscience, Reflection indica risultati propri sul solo sottoinsieme pubblico.
L’efficienza riguarda calcolo e lunghezza del ragionamento
Sui benchmark di ragionamento avanzato, Reflection indica prestazioni comparabili a GLM 5.2 con un fabbisogno di calcolo in inferenza da tre a quattro volte inferiore. La differenza cresce nel confronto con modelli appartenenti alla famiglia da oltre 2.000 miliardi di parametri, come Qwen 3.8-Max, che richiedono più calcolo per token.
Il confronto di efficienza su DeepSWE, Humanity’s Last Exam e Terminal Bench 2.1 utilizza dati di Artificial Analysis e DataCurve. La stima delle operazioni in virgola mobile segue la formula FLOPs ≈ 2 × parametri attivi × numero medio di token generati per tentativo, contando una moltiplicazione e un’addizione come due operazioni. I token includono sia il ragionamento sia la risposta finale e, per i modelli MoE, vengono considerati i parametri attivati per token.
Si tratta di una stima del calcolo di generazione, che esclude l’elaborazione iniziale del prompt, le operazioni di attenzione dipendenti dal contesto e il sovraccarico del servizio. Il risultato consente quindi di confrontare approssimativamente il lavoro computazionale, senza coincidere con una misura del costo effettivo di erogazione.
Un secondo elemento riguarda il controllo della lunghezza del reasoning. Durante l’apprendimento per rinforzo, Beam è stato addestrato con una penalità regolabile che premia le soluzioni corrette e scoraggia token superflui. Nelle prime fasi le prestazioni sono migliorate mentre le risposte si accorciavano; successivamente, con lo sviluppo delle capacità agentiche, sequenze più lunghe hanno sostenuto ulteriori progressi.
Gli utenti potranno intervenire su questo equilibrio attraverso il parametro reasoning effort: impostazioni più basse favoriscono risposte brevi, mentre quelle più alte consentono un ragionamento esteso per i compiti impegnativi. La scelta permette di adattare il modello alla difficoltà del lavoro e al budget di calcolo.
Quattro settimane di reinforcement learning su 10.500 GPU
Il post-training di Beam ha richiesto una campagna di reinforcement learning su 10.500 GPU Nvidia GB300 per quattro settimane, durante le quali sono state generate oltre 100 milioni di rollout, cioè sequenze di interazione del modello con i compiti e gli ambienti di addestramento. Il contesto massimo utilizzato in questa fase è stato di 256.000 token; training e valutazione delle risposte hanno impiegato circa 1,3 miliardi di sandbox, gli ambienti isolati nei quali eseguire strumenti e verifiche.
Reflection ha raccolto circa un milione di ambienti di qualità per coding, attività agentiche e discipline STEM, ossia scienza, tecnologia, ingegneria e matematica. Secondo l’azienda, la campagna è fra le più grandi condotte finora da un laboratorio che sviluppa modelli aperti; nell’insieme delle valutazioni, le capacità hanno continuato a migliorare all’aumentare del calcolo dedicato al reinforcement learning, senza mostrare un plateau. La curva pubblicata per l’esperto di reasoning copre 80 milioni dei rollout complessivi, con un confronto che riporta 30 milioni per Inkling e 753.000 per MiMo.
Durante l’addestramento, Beam continua a svolgere compiti mentre il sistema aggiorna i suoi parametri sulla base dei risultati già raccolti. Un’interazione lunga può quindi iniziare con una versione del modello e proseguire con versioni successive: quando viene utilizzata per il training, parte delle risposte riflette un comportamento ormai superato. Questo rende più difficile ricavare indicazioni coerenti per migliorare il modello, soprattutto perché i sistemi che generano le risposte e quelli che eseguono l’addestramento possono produrre risultati numerici leggermente diversi.
Reflection ha sviluppato algoritmi per mantenere stabile l’apprendimento in queste condizioni e ridurre sistematicamente lo scarto fra training e inferenza. Il sistema riesce a utilizzare interazioni generate oltre un giorno prima: nell’esempio pubblicato, la stabilità numerica permane anche con campioni prodotti da una versione dei pesi distante 107 aggiornamenti da quella corrente.
Dalla programmazione alla ricerca web: le capacità che si trasferiscono
Durante una fase dedicata al ragionamento, all’ingegneria del software e all’uso del terminale, Reflection ha osservato miglioramenti costanti nella navigazione web anche in assenza di compiti di browsing nella miscela di reinforcement learning. Il trasferimento indica lo sviluppo di capacità agentiche utilizzabili in domini differenti da quelli direttamente allenati. Con accesso al web, Beam ha imparato a cercare e interrogare altri modelli linguistici e a utilizzare API OCR per leggere documenti.
Beam elabora testo e può lavorare con informazioni provenienti da altre modalità quando queste vengono rappresentate in forma testuale. Le dimostrazioni comprendono ricerca, sviluppo di applicazioni, giochi e workflow di machine learning, con richieste iniziali, risultati e informazioni sulla configurazione e sulle successive interazioni dell’utente.
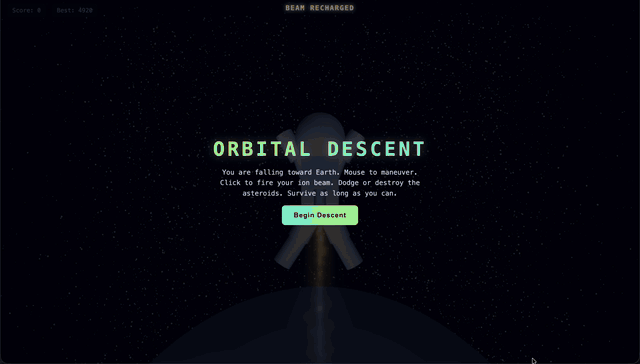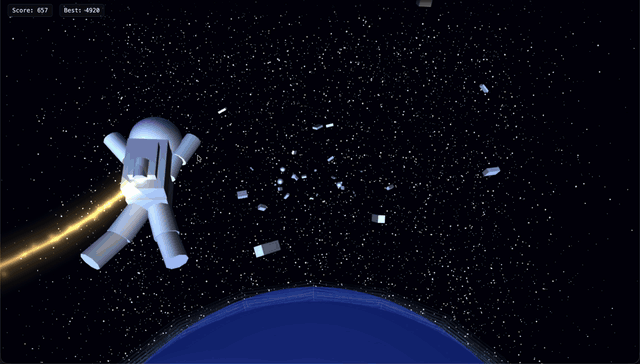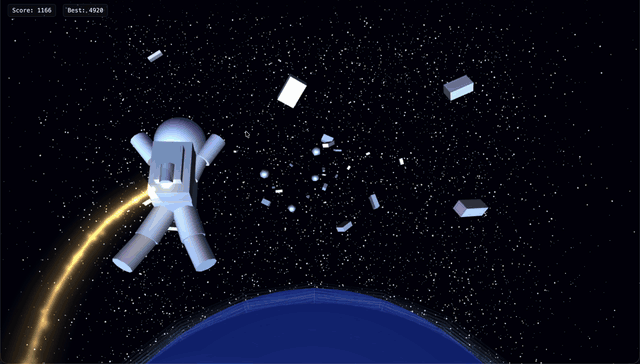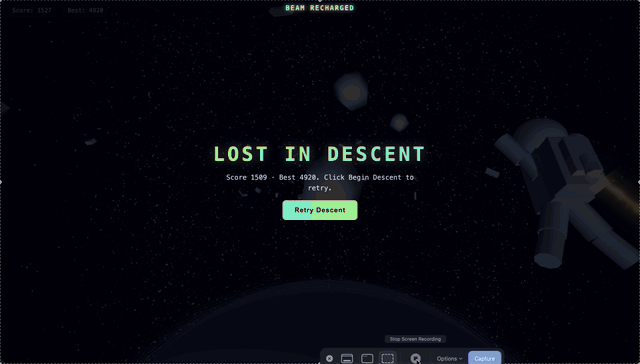
In una demo il modello realizza un gioco 3D in p5.js, nel quale un astronauta in caduta verso la Terra deve evitare asteroidi o distruggerli con raggi, ragionando testualmente sull’aspetto della scena.
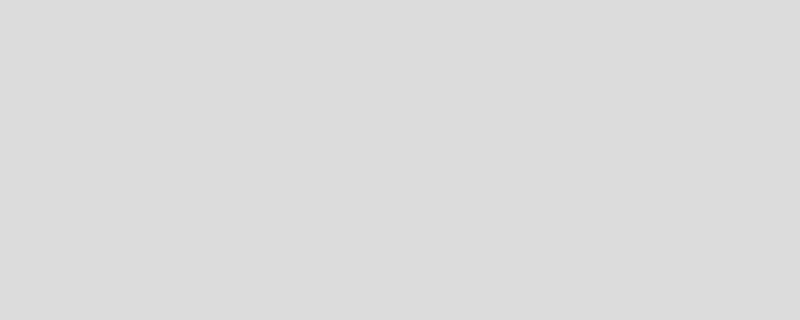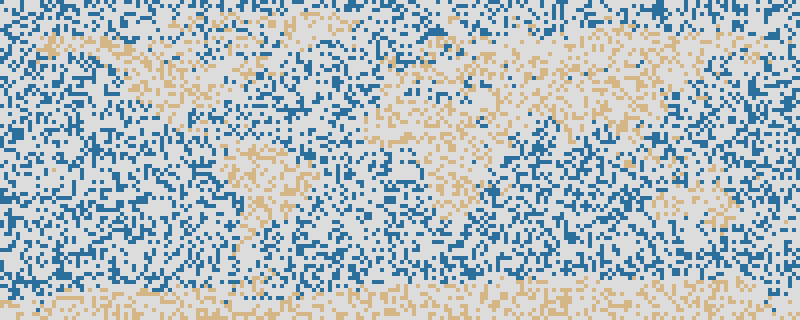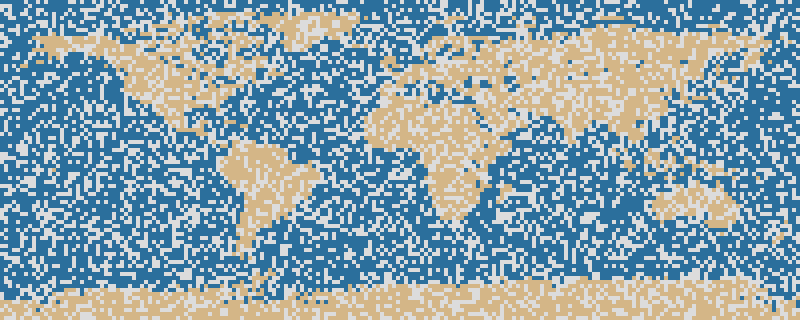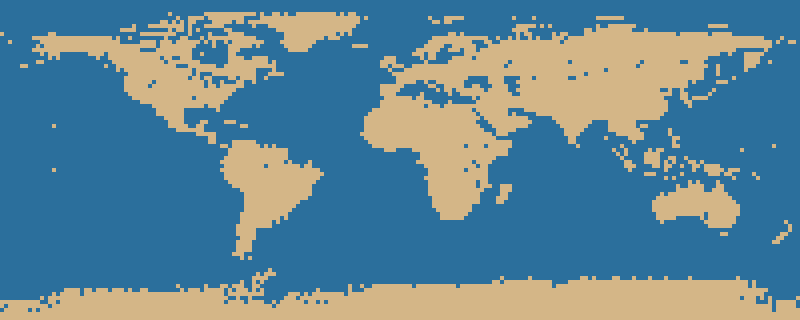
Un’altra prova chiede di classificare terra e acqua su una griglia geografica fissa di 180 × 90 elementi, con longitudini da −179° a 179° e latitudini da −89° a 89°, per 16.200 punti: Beam ottiene il 95,5% di copertura corretta, fra il 92,5% di Opus 5 e il 97,8% di Fable 5. Reflection presenta il quesito, comparso pochi giorni prima, come una verifica di generalizzazione su un problema successivo ai dati di training.
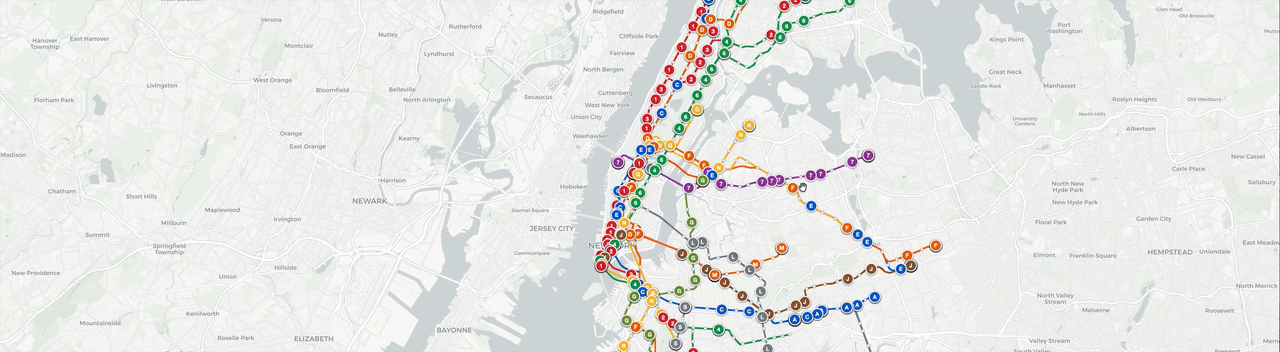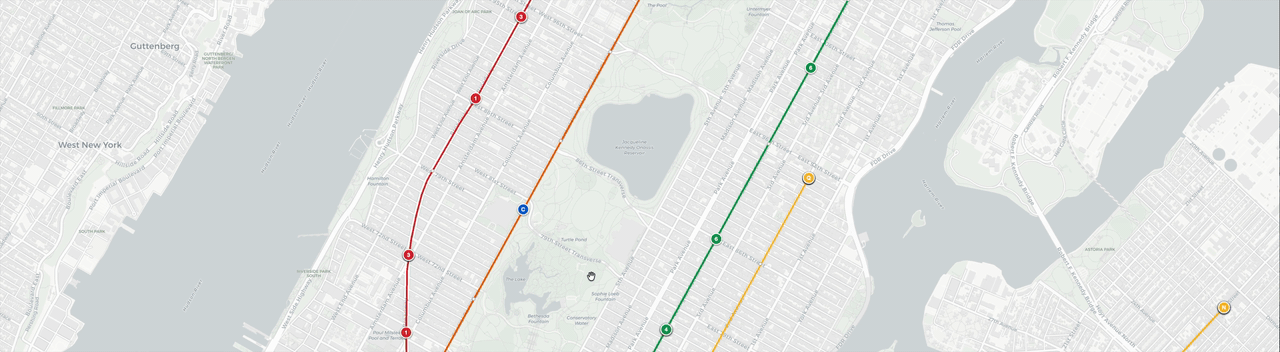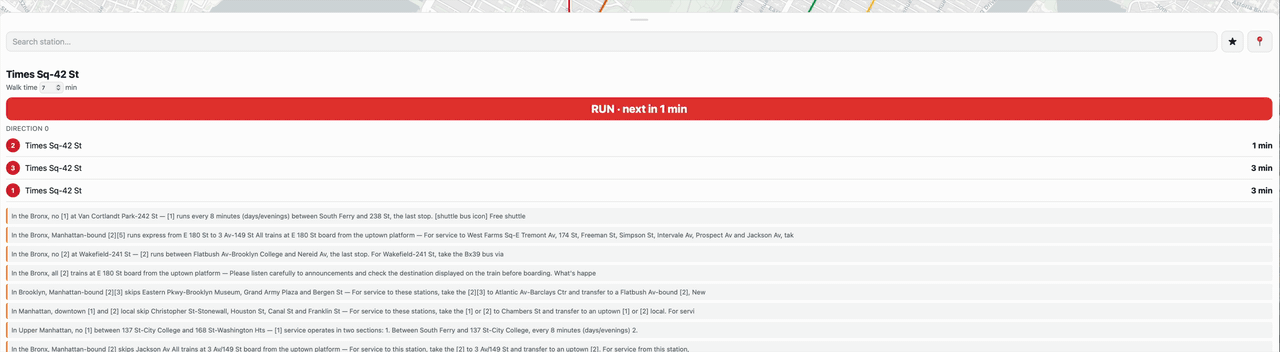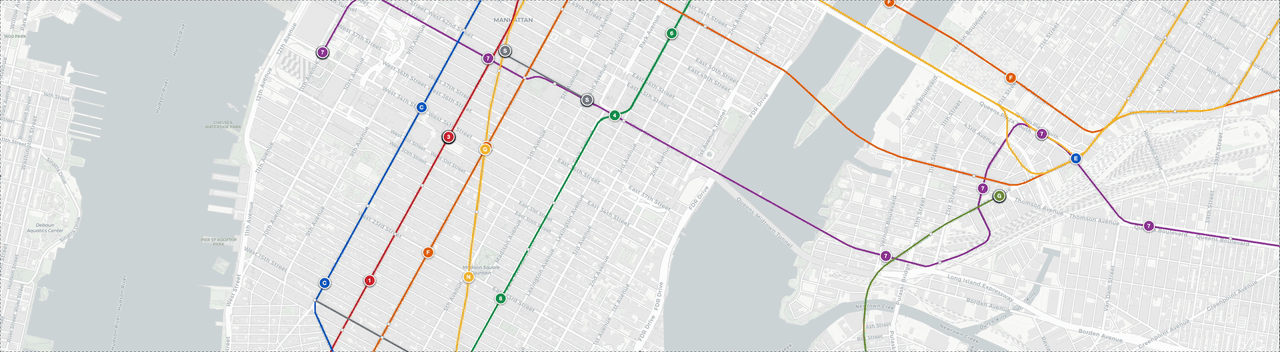
Per la metropolitana di New York, Beam costruisce una mappa aggiornata in tempo reale usando i dati pubblici della MTA: cerca le informazioni tecniche, verifica i requisiti di autenticazione, recupera le geometrie delle linee e della mappa e gestisce il movimento dei treni fra le stazioni. Realizza frontend e backend e mantiene il server operativo per gli aggiornamenti.
Nella dimostrazione di machine learning, Beam viene integrato in OpenCode e riceve la richiesta di usare Unsloth per preparare un notebook di fine-tuning del modello Gemma-4 più recente e più piccolo su un compito Text2SQL, la conversione di richieste testuali in query SQL. Il modello esamina model card, istruzioni di Unsloth e file README, quindi implementa la logica di personalizzazione e i componenti circostanti. Reflection riporta un miglioramento del 66,5% nell’accuratezza di Gemma sul set di test tenuto separato, riferito a questa specifica dimostrazione.
Un milione di ambienti e un’infrastruttura asincrona
La raccolta degli ambienti di reinforcement learning deriva soprattutto da pipeline di dati sintetici, integrate da dati proprietari di fornitori e fonti open source. Il processo parte da domini come ingegneria del software, terminale, programmazione competitiva, STEM, ricerca web, strumenti e lavoro generale basato sulla conoscenza; prosegue con filtri che eliminano compiti troppo facili o impossibili, richieste incomplete o fuorvianti, risposte indovinabili, verifiche aggirabili e materiale difettoso. Le prove di RL individuano ulteriori problemi e orientano il ciclo successivo di selezione.
Durante lo sviluppo, compromessi sulla qualità dei dati hanno provocato arresti dei progressi e altre difficoltà di training. Il miglioramento sistematico dei compiti ha consentito di sostenere gli incrementi di capacità fino alla fine della campagna.
La piattaforma asincrona coordina generazione dei rollout, esecuzione degli strumenti, valutazione dei risultati e aggiornamento del modello, lasciando operare queste attività indipendentemente. Durante l’addestramento ha mantenuto una media di 110.000 rollout simultanei, registrando per ogni token la versione dei pesi che lo aveva prodotto, così da gestire la distanza dalla policy corrente.
La distribuzione del calcolo è cambiata con il carico di lavoro: il rapporto fra GPU dedicate all’inferenza e al training è variato da 3,9:1 a 5,4:1, e il trainer è stato ridimensionato su cinque configurazioni di mesh di GPU senza perdere lo stato di addestramento. I nuovi pesi raggiungevano l’infrastruttura di inferenza con un tempo mediano di circa 12 secondi. La distribuzione gerarchica fra rack tramite RoCE, che consente l’accesso diretto alla memoria su Ethernet, e all’interno dei rack tramite NVLink ha ridotto del 75% il traffico fra rack e reso 2,2 volte più rapida l’adozione dei pesi rispetto al recupero diretto da parte di ogni replica.
La gestione dei guasti ha assorbito 71 incidenti di inferenza senza interrompere il job di training, con un ripristino mediano della capacità in otto minuti e una perdita pari allo 0,02% dei minuti-GPU complessivi del servizio. Il sistema ha supportato fino a 170.000 sandbox contemporanee e, sull’intera piattaforma, oltre un miliardo di richieste di creazione distribuite su più di 20 cluster, due cloud e quattro regioni; il 90% dei nuovi ambienti era pronto entro dieci secondi.
Il riempimento dinamico dei batch ha mantenuto un’occupazione media del 99,99%, contenendo entro l’1,5% la variazione della produttività del trainer per GPU mentre la lunghezza media dei rollout cresceva di quasi il 70%. Le registrazioni per token consentivano controlli di coerenza numerica a ogni passaggio; valutatori indipendenti riesaminavano le soluzioni riuscite per individuare aggiramenti dei verificatori, mentre registri riproducibili permettevano di ispezionare le ricompense e il loro uso nel training.
Pretraining su 23.800 miliardi di token e contesto fino a un milione
La base di Beam è stata preaddestrata su 23.800 miliardi di token, provenienti dal web, da fonti pubbliche e da dataset proprietari concessi in licenza. Il corpus comprende codice, spiegazioni tecniche e conoscenze matematiche e scientifiche; Reflection dichiara di utilizzare quasi tutto il codice e la relativa documentazione accessibili pubblicamente sul web con licenze prive di restrizioni.
Prima del modello finale, l’azienda ha addestrato una serie di reti progressivamente più grandi per verificare le leggi di scala, costruendo set interni di validazione per codice e web e rimuovendo dai dati di training le sovrapposizioni con queste prove. Beam Base ha raggiunto le prestazioni previste e risultati pari o superiori a quelli dei modelli base aperti accessibili di dimensione simile. La ricetta è stata verificata su quattro ordini di grandezza del calcolo, con un rapporto fra errore di previsione e risorse impiegate sulla frontiera di Pareto rispetto ai modelli base confrontabili.
Classificatori sviluppati internamente suddividono web, codice e contenuti STEM in livelli di qualità, assegnando maggiore peso al materiale migliore. Parsing, deduplicazione e selezione eliminano circa il 95% dei token grezzi di Internet; allo stesso tempo, i filtri convenzionali avrebbero escluso circa 1.800 miliardi di token di qualità conservati da Reflection, incluso l’87% dei token di codice web selezionati.
Per ogni linguaggio di programmazione sono stati applicati filtri specifici, eliminati contenuti autogenerati di scarsa qualità o dai quali il modello non poteva apprendere, e utilizzati classificatori per individuare dati corrotti o codice capace di compromettere la stabilità. Linguaggi e tipi di file sovrarappresentati sono stati riequilibrati. Una pipeline per i PDF combina un modello visione-linguaggio per l’OCR, classificatori e rilevatori di ricostruzioni malformate, distribuendo su migliaia di GPU l’elaborazione di petabyte di dati tecnici. Codice e contenuti tecnici sono stati riproposti più volte, con deduplicazione approssimata e algoritmi di impacchettamento studiati per sostenere la generalizzazione durante l’addestramento prolungato.
Il successivo midtraining prepara il modello al reinforcement learning con esempi reali selezionati, trasformati, combinati ed estesi per insegnare capacità specifiche, compresi documenti con lunghe catene logiche. Questa fase porta il contesto effettivo a un milione di token, utilizzando repository strutturati, compiti di lunga durata e documenti estesi per insegnare a conservare e collegare informazioni distribuite su sequenze molto ampie.
Stabilità degli esperti e addestramento su 6.144 GPU
Beam combina l’attenzione alle informazioni vicine nel testo con quella alle relazioni fra parti più distanti, così da elaborare sia i dettagli sia il contesto complessivo. Per ogni token, il sistema seleziona piccoli gruppi di “esperti”, le componenti specializzate della rete, e distribuisce il lavoro in modo da evitare che alcune vengano utilizzate troppo e altre rimangano poco allenate. Reflection ha adattato una tecnica di bilanciamento sviluppata da DeepSeek, riducendo gradualmente gli aggiustamenti alla selezione degli esperti nelle fasi finali del training. Il bilanciamento considera anche intere sequenze di testo, preparando il modello ai compiti differenti che incontrerà durante il reinforcement learning.
Alla fine del pretraining, gli esperti risultano utilizzati in modo quasi uniforme: quello più occupato riceve mediamente un carico appena superiore del 4% al livello uniforme. Altri accorgimenti mantengono sotto controllo l’intensità dei segnali mentre attraversano i 52 strati della rete, evitando che crescano eccessivamente o che piccoli contributi vadano persi negli arrotondamenti numerici. Per queste somme Beam utilizza calcoli a 32 bit, che aiutano a conservare la precisione. La stabilità viene mantenuta anche nelle successive fasi di reinforcement learning e allineamento.
Il pretraining completo ha richiesto meno di quattro settimane su 6.144 GPU Nvidia GB300 NVL72. Reflection ha sviluppato internamente quasi tutta l’infrastruttura software, compreso un sistema basato su Kubernetes che assegna i lavori tenendo conto di come le GPU sono collegate fra loro. Il monitoraggio continuo verifica il funzionamento dei nodi di calcolo, mentre un sistema dedicato cerca errori nei dati che potrebbero alterare l’addestramento senza provocare un guasto evidente. Quando rileva un problema, può ripristinare uno stato precedente del modello e riavviare il lavoro con un intervento umano limitato.
Durante la campagna sono stati necessari nove ripristini di questo tipo, per variazioni anomale nell’intensità degli aggiornamenti del modello o per sospetti errori silenziosi nei dati. Verso la fine, il 92,3% del tempo trascorso è stato impiegato in passaggi di addestramento effettivamente conservati nel modello finale: il resto comprende il tempo dedicato a salvataggi, interruzioni e lavoro da ripetere. Questo indicatore, chiamato goodput, è migliorato grazie a salvataggi più efficienti, rilevamento dei guasti e gestione dei nodi. L’addestramento ha mantenuto un andamento regolare, senza anomalie gravi e irrecuperabili.
Sicurezza e allineamento con due modelli insegnanti
Per insegnare a Beam a rispettare le richieste degli utenti e le regole di sicurezza, Reflection ha sviluppato due modelli a partire dalla stessa base preaddestrata. Il primo si è concentrato sulle capacità di ragionamento e di esecuzione dei compiti; il secondo ha appreso il comportamento desiderato attraverso esempi di risposte corrette e un addestramento che premiava il rispetto dei principi di sicurezza. Gli insegnamenti di entrambi sono stati trasferiti nel modello finale, valutando e correggendo le risposte che questo produceva durante l’apprendimento.
I principi comprendono tre livelli: regole fondamentali, come rispettare le policy di sicurezza e presentarsi come agente AI; qualità delle risposte, fra cui usare il contesto disponibile, fornire informazioni accurate, riconoscere l’incertezza e seguire con trasparenza le richieste; uno stile diretto, approfondito ed efficiente, capace di anticipare le esigenze dell’utente.
Per comportamenti come chiarezza e correttezza dell’interazione, la qualità di una risposta richiede un giudizio più articolato di un semplice controllo automatico. Reflection ha quindi utilizzato un altro modello AI come valutatore, assegnando ricompense alle risposte conformi ai criteri desiderati. Ha inoltre sviluppato un metodo per prevedere quanto questi incentivi avrebbero migliorato il comportamento: la correlazione fra previsioni e progressi osservati è stata di 0,79, rispetto a 0,46 con il metodo di confronto basato sulla scelta della migliore fra più risposte. Una correlazione più vicina a uno indica una maggiore corrispondenza fra previsione e risultato; questa capacità ha aiutato a perfezionare i criteri di valutazione e a ridurre informazioni inventate e formattazione eccessiva.
L’addestramento alla sicurezza insegna a Beam a considerare le regole durante il ragionamento che precede la risposta. Dopo ogni ciclo, Reflection mette alla prova il modello con richieste costruite per indurlo a compiere azioni dannose oppure a rifiutare compiti legittimi. I casi che fanno emergere problemi vengono utilizzati per preparare gli esempi del ciclo successivo.
Le prove comprendono richieste singole, conversazioni articolate, tentativi di aggirare le protezioni e situazioni nelle quali un avversario simulato cerca di convincere un agente dotato di strumenti a eseguire azioni pericolose. L’obiettivo è ridurre sia l’esecuzione di richieste dannose sia i rifiuti ingiustificati.
I risultati delle valutazioni di sicurezza saranno inclusi nel rapporto tecnico. Reflection renderà inoltre open source le prove sviluppate e utilizzate internamente, affinché altri ricercatori e sviluppatori possano esaminarle, riutilizzarle e contribuire a migliorarle.
Pesi Apache 2.0 e strumenti per esecuzione, valutazione e fine-tuning
È già possibile iscriversi alla lista d’attesa per l’accesso anticipato a Beam. La pubblicazione dei pesi è prevista entro ottobre 2026, insieme al rapporto tecnico, alla model card e agli strumenti per gli sviluppatori. La licenza annunciata è Apache 2.0, che definisce un quadro permissivo anche per l’impiego commerciale, nel rispetto dei suoi obblighi.
Reflection distribuirà inoltre la documentazione e lo stack per eseguire, valutare e personalizzare il modello tramite fine-tuning. Sono previsti partner di distribuzione e integrazioni con un’ampia gamma di librerie open source e harness, gli ambienti software che coordinano l’esecuzione degli agenti e delle valutazioni, per inserire Beam nei workflow esistenti.
Beam inaugura una serie di modelli. Reflection sta già addestrando la generazione successiva, con l’obiettivo dichiarato di avvicinare progressivamente le capacità dei sistemi aperti a quelle dei modelli più avanzati.