Generare uno sticker già scontornato, estrarre un soggetto da una fotografia e continuare a modificarlo senza perdere la trasparenza: sono operazioni che Qwen-Image-2.1 riunisce nello stesso modello insieme alla generazione da testo. Il nuovo sistema combina inoltre fino a dieci immagini di riferimento, consente di indicare con precisione le aree da ritoccare e conserva con maggiore fedeltà l’identità delle persone o l’aspetto dei prodotti.
Il componente dedicato alla generazione visiva conta 7 miliardi di parametri, distribuiti in 32 blocchi Transformer basati su un’architettura Diffusion Transformer (DiT), che elabora testo e dati visivi nello stesso flusso. Qwen ha scelto una struttura compatta per bilanciare qualità, costo computazionale e velocità di inferenza, mantenendo la generazione nativa a risoluzione 2K. Testo, istruzioni di modifica e immagini vengono gestiti con un meccanismo di attenzione a granularità mista; durante il processo, il sistema calcola una volta il contesto fornito in ingresso e lo riutilizza nei passaggi successivi attraverso la cache KV. Il vantaggio diventa particolarmente rilevante nei lavori che impiegano diversi riferimenti visivi, perché riduce i calcoli ripetuti e l’uso della memoria.
Immagini trasparenti generate ed elaborate nello stesso modello
La novità più caratteristica è il supporto nativo della trasparenza. Da una descrizione testuale, Qwen-Image-2.1 può produrre sia una normale immagine RGB sia un file RGBA dotato di canale alfa, adatto a sticker, soggetti scontornati, scritte ed elementi grafici pronti per essere inseriti in un’altra composizione. La trasparenza riguarda anche scene formate da più oggetti, perciò il modello può creare asset articolati mantenendo vuote le aree dello sfondo.
La stessa capacità resta disponibile durante il ritocco. Un elemento trasparente può essere modificato – per esempio cambiando l’espressione di un personaggio o sostituendo una parola – senza perdere il canale alfa. Il flusso funziona anche in direzione opposta: partendo da una fotografia RGB, il modello estrae il soggetto richiesto e lo restituisce come livello RGBA trasparente. Lo scontorno diventa così parte della generazione e dell’editing, senza richiedere un modello separato come Qwen-Image-Layered, presentato alla fine del 2025 proprio per lavorare con elementi trasparenti.
Fino a dieci immagini di riferimento in una composizione
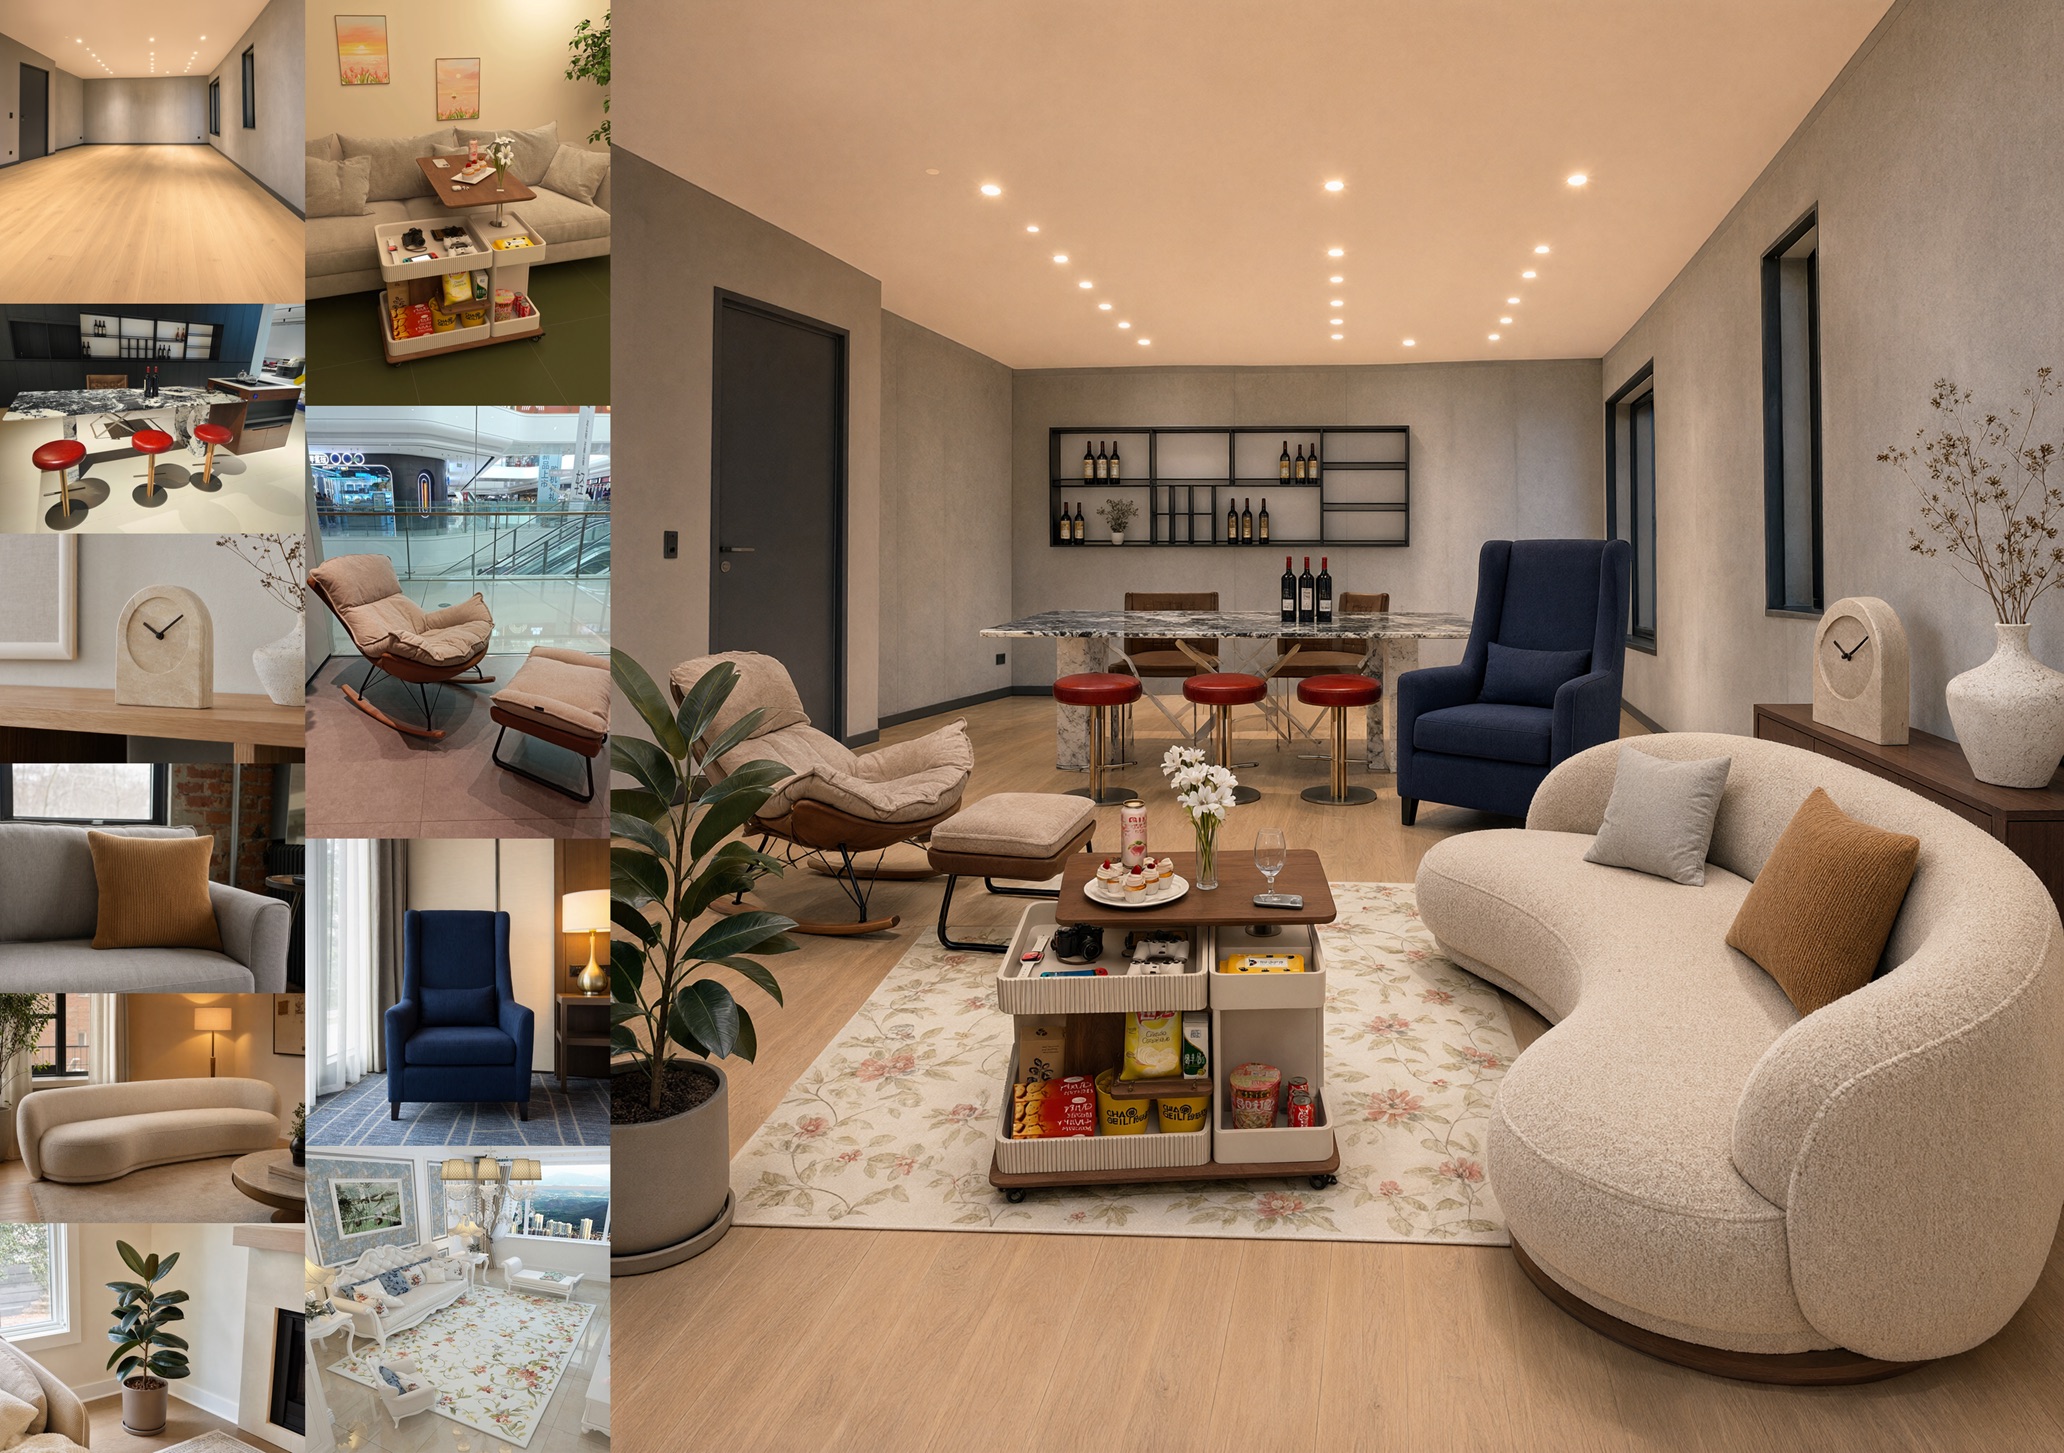
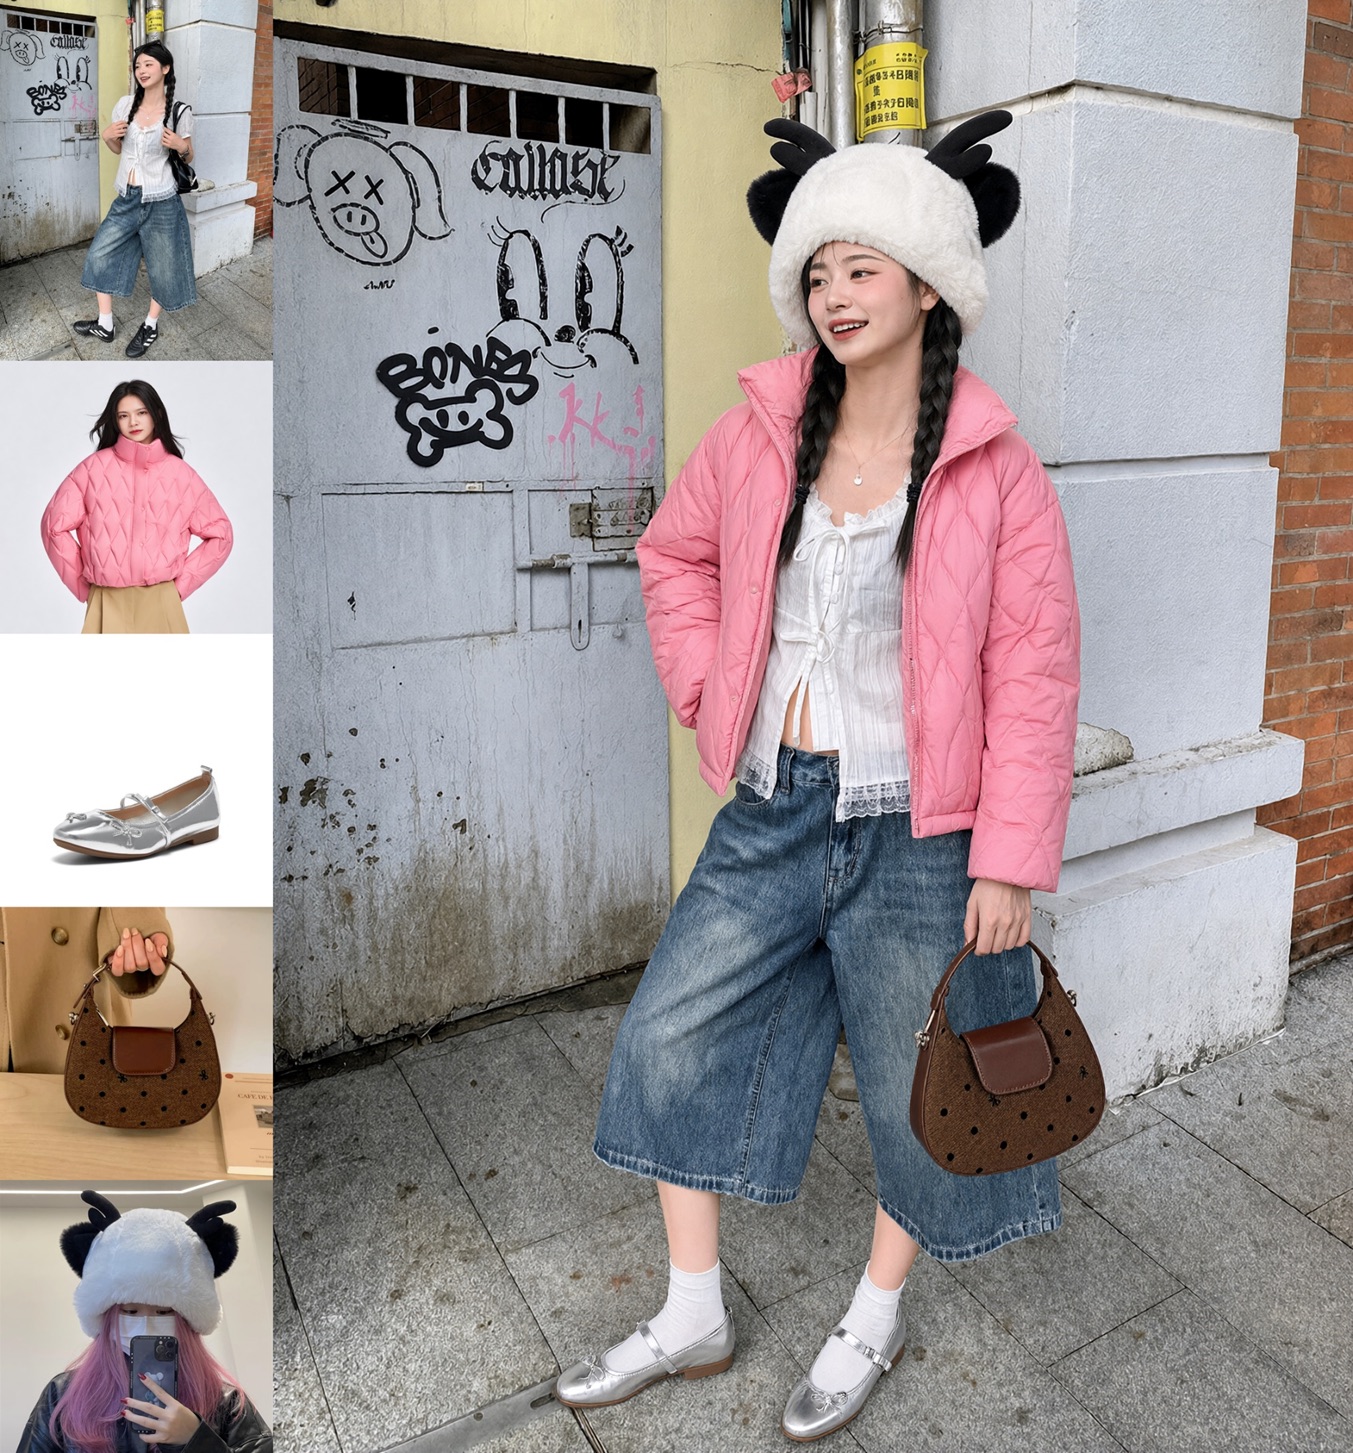
Qwen-Image-2.1 può ricevere fino a dieci immagini e ricombinarne soggetti e oggetti in una scena coerente. Negli esempi mostrati dall’azienda, sei ritratti separati confluiscono in una foto di gruppo, mentre cinque riferimenti – una modella, un abito, un paio di scarpe, una borsa e un cappello – diventano un unico look completo. Un’altra dimostrazione usa dieci fotografie di arredi per progettare una stanza.
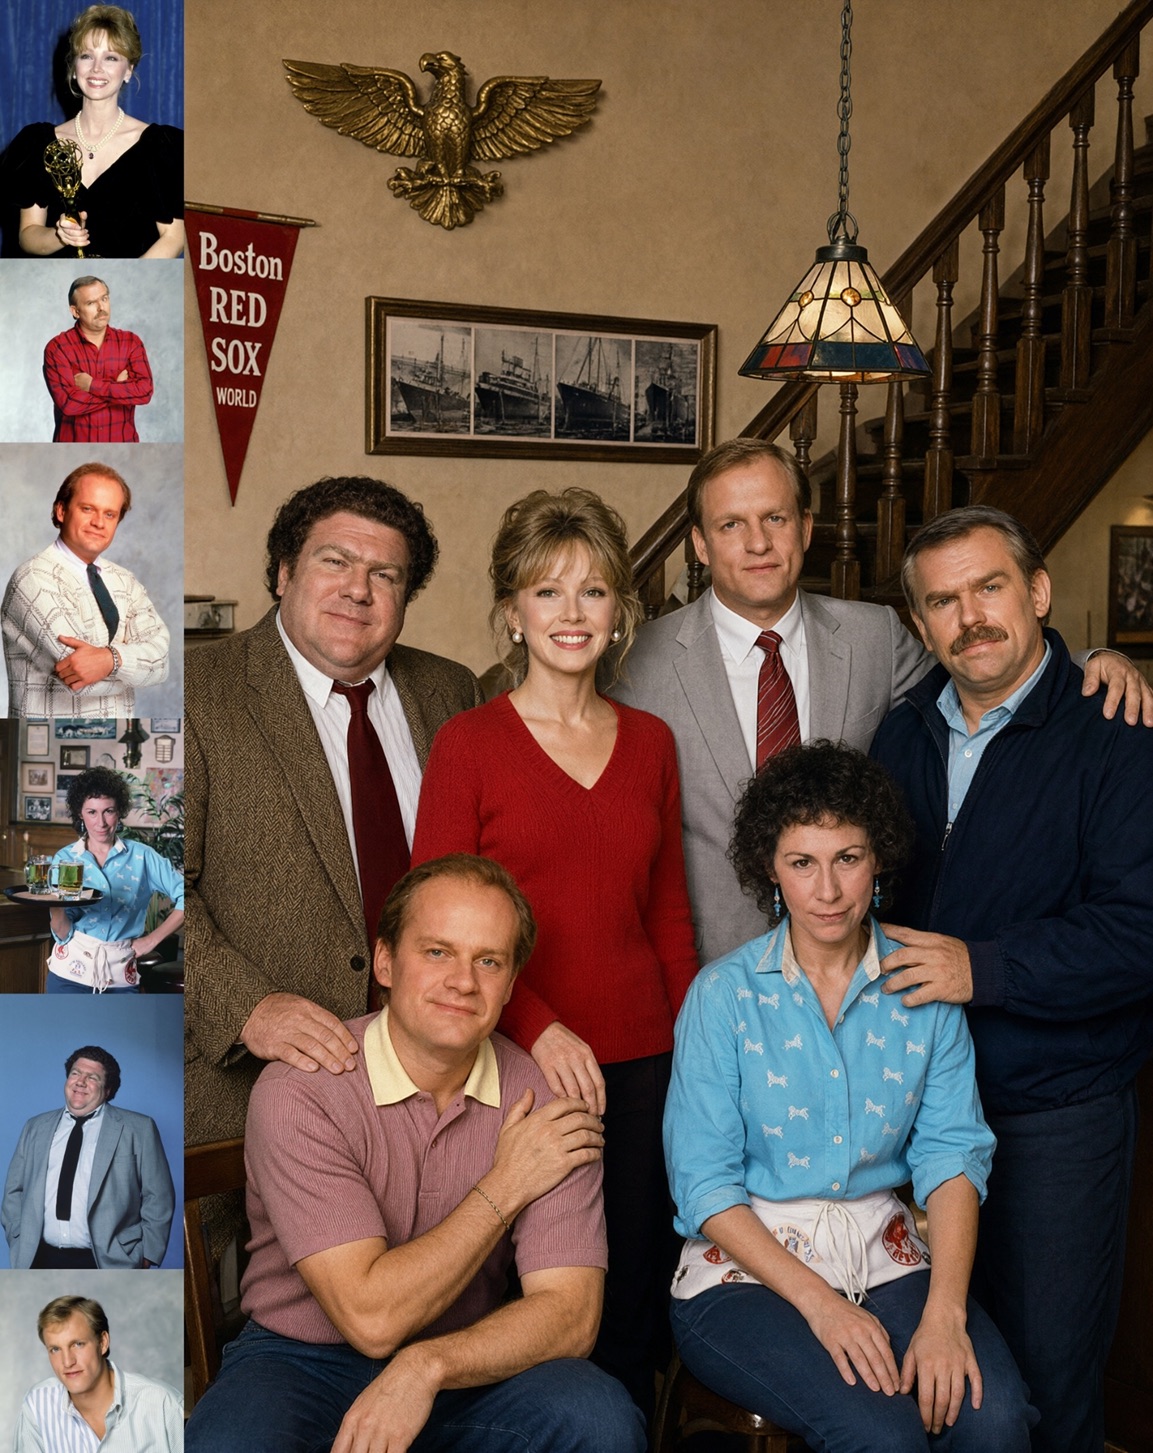
La funzione amplia soprattutto le possibilità nei flussi di lavoro in cui l’aderenza agli elementi forniti conta più della libera interpretazione del prompt. Moda, arredamento, pubblicità ed e-commerce possono costruire una nuova immagine a partire da un insieme di prodotti reali, mantenendo sotto controllo la scelta dei soggetti e la loro relazione nella scena.
Ritocchi locali indicati con cerchi, pennellate e maschere
Per circoscrivere una modifica, l’utente può disegnare cerchi colorati direttamente sull’immagine e associare a ciascuno un’istruzione. Una sola richiesta può così intervenire su più zone, come rimuovere un orologio, cambiare il colore dei capelli e sostituire un indumento. Sono accettate anche annotazioni dipinte, utili per delimitare liberamente l’area nella quale aggiungere o trasformare un elemento.
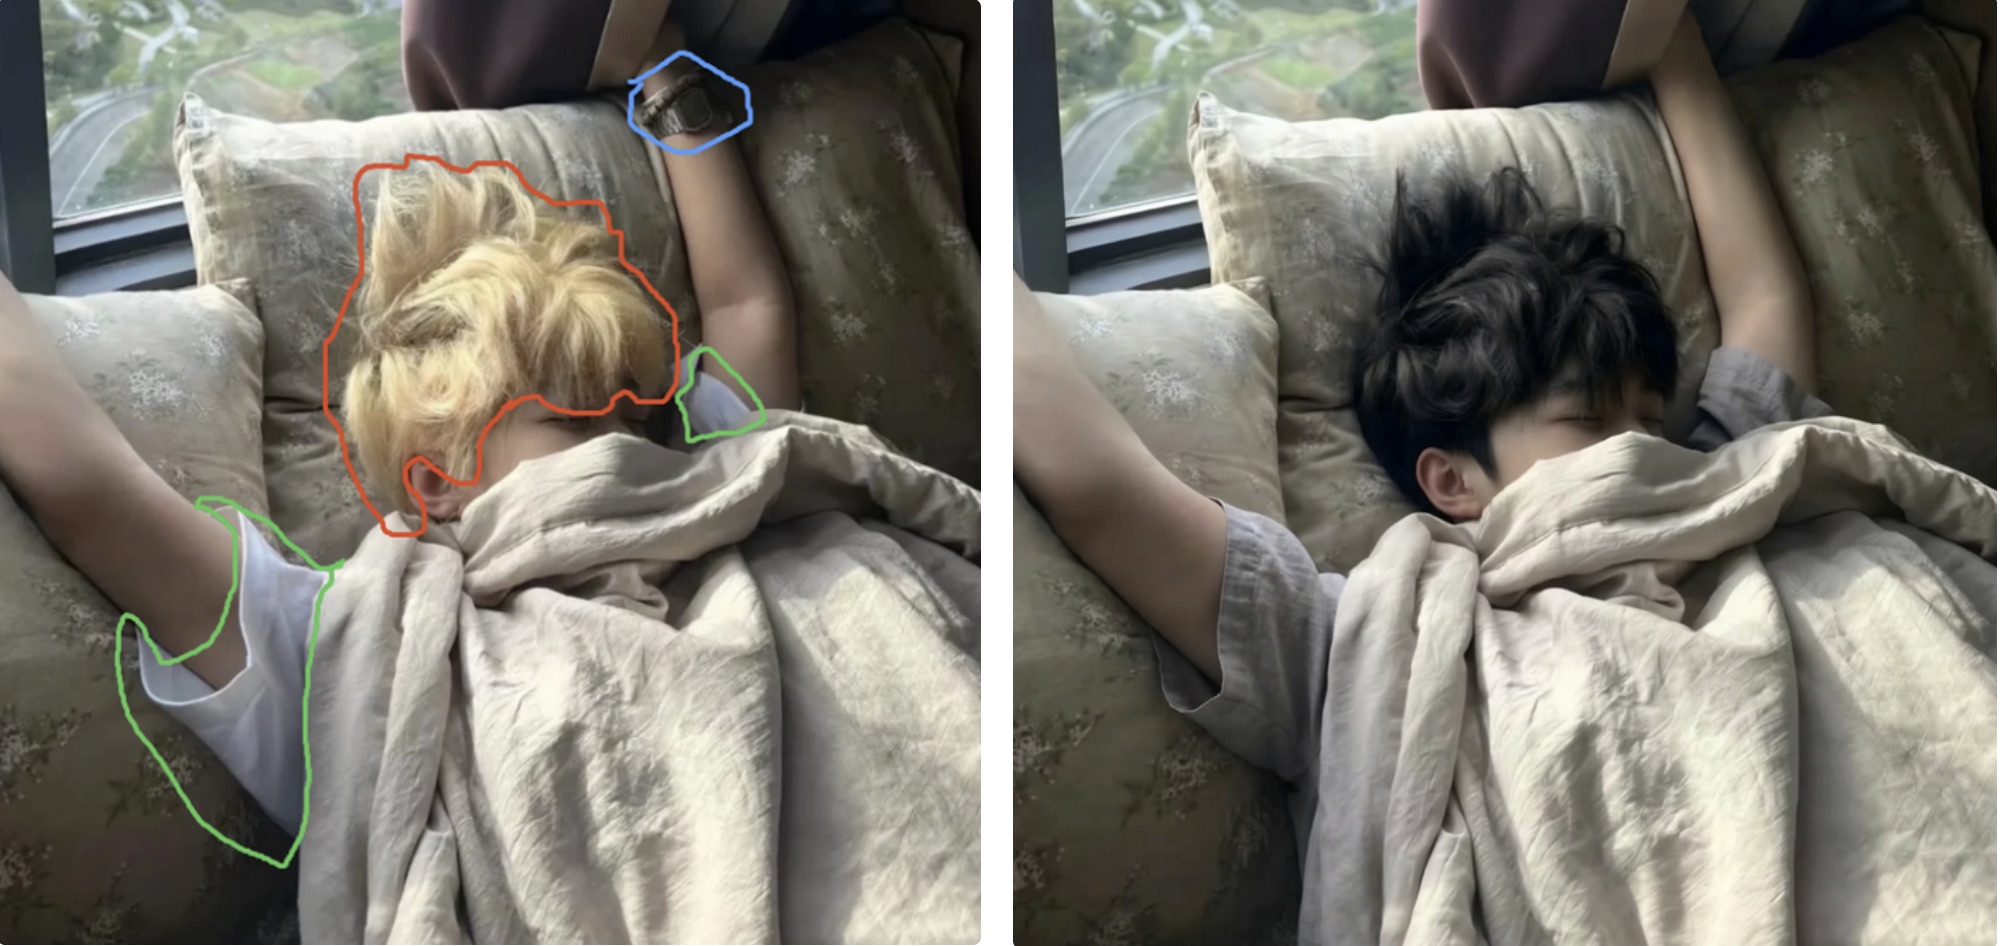
Quando l’annotazione coprirebbe dettagli necessari al risultato, il sistema riceve separatamente l’immagine originale e una maschera. In questo modo conserva l’intero contenuto di partenza e applica l’intervento soltanto nella regione selezionata. Qwen mostra inoltre come una sequenza di modifiche locali, lasciando stabile il resto della scena, possa fornire i fotogrammi per realizzare semplici animazioni.
Volti e prodotti restano riconoscibili durante le modifiche
Il modello migliora la fedeltà degli elementi che devono attraversare più trasformazioni. Nei ritratti mantiene con maggiore coerenza i tratti del viso, una caratteristica importante quando una persona viene collocata in ambienti, pose o stili differenti. Nel trattamento delle immagini commerciali tutela invece forma, texture e scritte presenti sulla confezione, così che il prodotto conservi le caratteristiche che lo rendono identificabile anche all’interno di una nuova scena.
Questa evoluzione completa gli strumenti multi-riferimento: una composizione pubblicitaria può attingere a fotografie distinte di persone, accessori e prodotti, mentre il modello cerca di rispettarne l’identità visiva. La maggiore coerenza risulta utile anche per storyboard e narrazioni illustrate, nei quali personaggi e oggetti devono mantenere un aspetto stabile tra una scena e la successiva.
Panorami, infografiche, storyboard e testo più curato
La gamma delle operazioni comprende la trasformazione di un selfie in un panorama esplorabile da più direzioni, l’espansione di una fotografia in un’infografica ricca di informazioni e la conversione delle viste frontale, laterale e posteriore di un personaggio in uno storyboard completo. Qwen-Image-2.1 presta inoltre maggiore attenzione alla tipografia, valutando contenuto, stile dei caratteri, impaginazione e rapporto fra testo e composizione. Nei ritratti intervengono una resa più accurata della luce e dettagli fini più realistici.
I requisiti per eseguire Qwen-Image-2.1 in locale
Secondo il repository ufficiale, l’installazione richiede PyTorch 2.4 o successivo, Transformers 5.17, Hugging Face Diffusers, Accelerate e Pillow. Gli esempi forniti da Qwen caricano la pipeline in formato bfloat16 su una GPU compatibile con CUDA e utilizzano 40 passaggi di inferenza; le risoluzioni consigliate spaziano dal formato quadrato 2048 × 2048 al 16:9 da 2752 × 1536 pixel.
Per le schede grafiche con memoria limitata è disponibile il model offloading verso la CPU, che evita di mantenere l’intera pipeline nella VRAM. Qwen non indica un quantitativo minimo di memoria video, perciò le risorse necessarie dipendono dalla risoluzione scelta, dal numero di immagini usate come riferimenti e dal sistema di inferenza. Il supporto hardware comprende anche le GPU AMD Radeon attraverso ROCm, PyTorch e Diffusers, oltre a otto piattaforme di chip gestite tramite FlagOS.
Il repository non documenta un percorso ufficiale per macOS e i processori Apple Silicon. La generazione da testo può essere eseguita attraverso il backend MPS di PyTorch e ComfyUI, ma al momento dell’uscita l’editing presenta una limitazione: un problema segnalato nel progetto ComfyUI riguarda la codifica delle immagini con il VAE su MPS e può degradare il risultato senza mostrare errori. Il rimedio indicato consiste nell’eseguire il VAE sulla CPU; sono disponibili anche conversioni MLX realizzate dalla comunità, prive però di supporto ufficiale da parte di Qwen.
I pesi e il codice sono disponibili per l’esecuzione locale. Sin dal debutto il modello è supportato da Hugging Face Diffusers e ComfyUI; vLLM-Omni, SGLang e LightX2V offrono invece soluzioni orientate all’inferenza ottimizzata, alla gestione della memoria e all’impiego su più GPU.